Scrapy应对普通反爬虫策略:Header、代理与动态加载
本文详解Scrapy框架应对常见反爬机制的策略。涵盖通过中间件随机User-Agent、处理Referer与Cookies、利用X-Forwarded-For伪装代理,以及配置带认证的代理IP。针对动态加载内容,介绍通过Ajax接口分析或结合Selenium与PhantomJS模拟浏览器渲染的方法,并提供相关代码实现与注意事项。
2026-10-14
23

本文详解Scrapy框架应对常见反爬机制的策略。涵盖通过中间件随机User-Agent、处理Referer与Cookies、利用X-Forwarded-For伪装代理,以及配置带认证的代理IP。针对动态加载内容,介绍通过Ajax接口分析或结合Selenium与PhantomJS模拟浏览器渲染的方法,并提供相关代码实现与注意事项。
本文详细介绍Python中字典的多种遍历方式,包括items()与iteritems()的区别,以及利用zip()合并序列。重点讲解如何使用sorted函数结合lambda表达式对字典按键或键值进行升序和降序排序,并提供完整代码示例与参数说明。
本文介绍如何使用Python3和requests模块抓取B站视频的历史弹幕数据。通过Chrome开发者工具分析网络请求,定位rolldate和dmroll接口,获取弹幕ID及时间戳。利用正则表达式解析返回的XML数据,按日期保存弹幕内容至本地文件,为后续词云或情感分析提供数据支持。
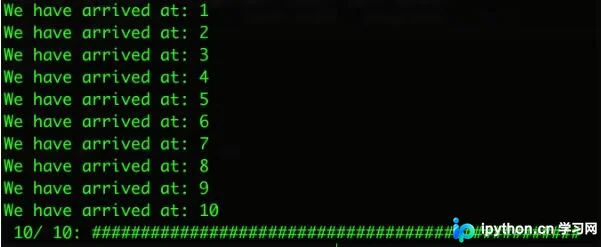
本文详解如何在Python控制台实现动态进度条。核心在于利用sys.stdout.write替代print,配合\r转义符将光标移至行首,并通过sys.stdout.flush()强制刷新缓冲区。文章涵盖解决旧字符残留、固定底部输出及封装类实现等常见问题,适用于爬虫、机器学习等耗时任务的可视化监控。
本文详解Python中实现Redis CAS(Compare and Set)的三种方案:基于Pipeline的乐观锁、基于同步装饰器的悲观锁以及Lua脚本原子操作。通过多线程并发测试对比发现,高竞争场景下乐观锁性能急剧下降,而Lua脚本因原子执行特性,在50线程1000次操作下表现最优,显著优于其他两种锁机制。
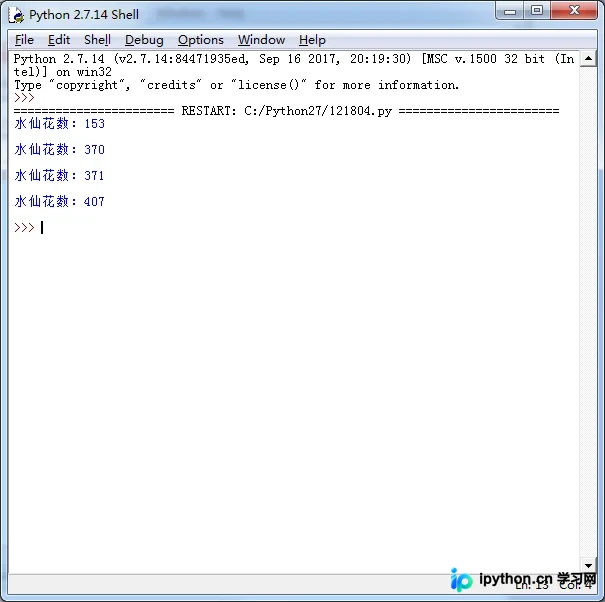
本文介绍如何使用Python语言生成并打印水仙花数。水仙花数指一个n位数(n≥3),其各位数字的n次幂之和等于该数本身。通过遍历指定范围的整数,利用循环与条件判断,程序可自动识别并输出所有符合条件的水仙花数,适合初学者理解基础逻辑与代码实现。
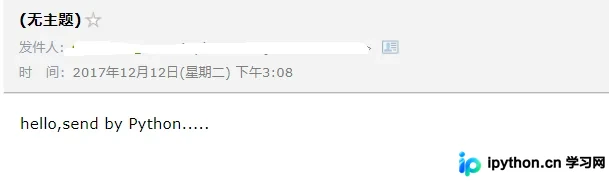
本文详细介绍如何利用Python的smtplib模块实现自动发送邮件功能。内容涵盖SMTP协议基础、连接登录流程,并分步演示如何构造和发送纯文本邮件、HTML格式邮件以及包含附件的复杂邮件。通过解析MIMEText、MIMEMultipart等类的继承关系,帮助开发者掌握邮件头设置与内容构造技巧,确保邮件完整送达。
本文详解如何在Python中利用rsa库实现公钥解密。通过解析RSA原理,提取核心解密逻辑,并提供完整代码示例。结合OpenShell命令验证流程,指导用户正确生成公钥文件并执行解密操作,解决网上缺乏公钥解密教程的问题。
本文介绍使用Python抓取亚马逊书籍基本信息的完整流程。通过构造包含node参数的GET请求获取搜索结果页,利用正则表达式解析书名、作者、封面等字段,并将结果写入MySQL数据库。代码展示了从请求构造到数据入库的核心逻辑,适用于需要批量采集书籍元数据的场景。
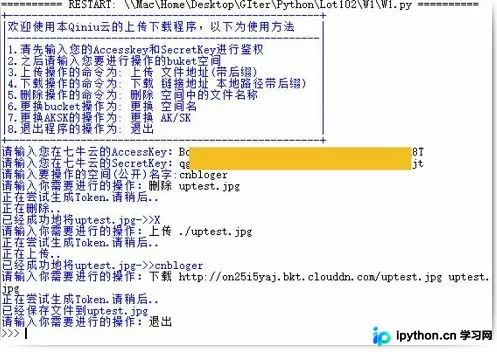
本文详解如何利用Python官方SDK对七牛云存储空间进行基础操作。内容涵盖从注册账号、获取AK/SK密钥到安装qiniu库的全过程。重点解析单文件直传、公共空间下载及文件删除的API调用逻辑,并提供完整的Python代码示例与命令行交互实现,帮助开发者快速掌握七牛云存储集成方法。
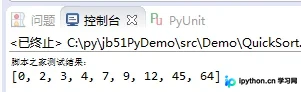
本文深入解析Python中快速排序算法的实现原理与代码细节。通过选取基准数、分区操作及递归处理,详细演示了如何将数组元素按大小重新排列。文章提供了完整的Python代码示例,分析了O(NlogN)的时间复杂度,并附带在线工具链接,帮助开发者掌握这一高效排序算法的核心逻辑与应用。
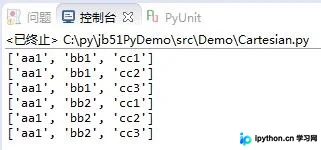
本文介绍在Python2.7环境下,通过自定义Cartesian类实现N个数组的笛卡尔积排列组合。核心逻辑包含计算总长度、递归处理下标及组装输出,适用于需要生成多维数据全组合的场景,代码结构清晰,便于参考与复用。