

Python类属性与实例属性详解:类方法、静态方法与实例方法的区别
本文详细解析Python中类的属性与方法。重点区分类属性与实例属性的优先级关系,并深入讲解实例方法、静态方法和类方法的定义及调用差异。通过代码示例说明self与cls参数的作用,以及类方法在实现多个构造函数场景下的优势,帮助开发者掌握Python面向对象的核心概念。
2026-10-13
17

本文详细解析Python中类的属性与方法。重点区分类属性与实例属性的优先级关系,并深入讲解实例方法、静态方法和类方法的定义及调用差异。通过代码示例说明self与cls参数的作用,以及类方法在实现多个构造函数场景下的优势,帮助开发者掌握Python面向对象的核心概念。
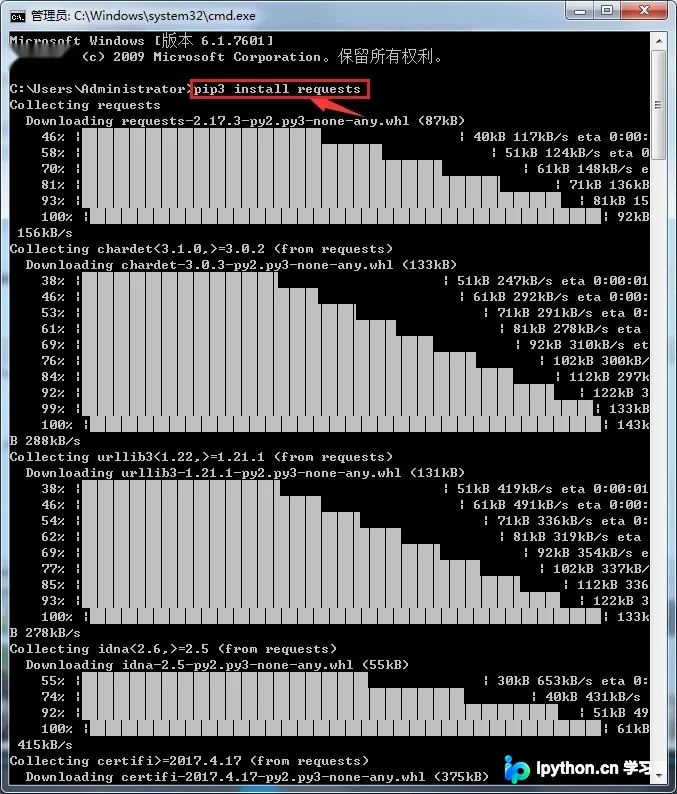
本文详细介绍在Windows系统中安装Python第三方模块的两种主要方式:使用内置的pip工具进行快速安装,以及通过下载源码包进行手动部署。针对初学者常遇到的pip命令未识别、路径配置缺失及依赖库冲突等问题,提供了具体的解决方案,包括环境变量设置、GitHub源码下载及setup.py安装步骤,并附带web.py模块的安装实战案例。
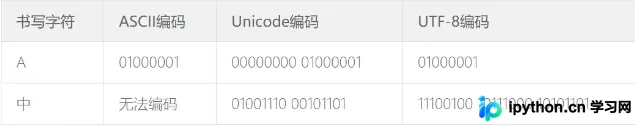
本文深入解析Python字符串的本质,阐述其作为Unicode码点不可变序列的定义。详细梳理ASCII、GB2312到Unicode及UTF-8的编码演进,并对比Python与Java在字符串定义、多行支持及字符处理上的差异,帮助开发者理解底层原理与跨语言特性。
本文介绍了一种Python实现方法,用于将输入的字符串按固定长度8进行拆分。若字符串长度不是8的倍数,则在末尾补数字0直至满足倍数要求。文章提供了完整代码示例及针对正常输入和空值输入的测试结果,旨在帮助开发者掌握字符串批量处理与格式化的基础技巧。
本文详解Python标准库unittest的使用,涵盖测试目录结构规范、函数与类的测试策略。通过get_city_info和CourseManage示例,演示如何编写测试用例、处理断言失败及升级函数兼容性,并深入解析assertEqual等常用断言方法及setUp()优化技巧,帮助开发者建立高效的自动化测试体系。
本文详解pandas中DataFrame的行列索引操作。涵盖获取index与columns、使用rename灵活修改索引(支持部分修改与inplace参数),以及数据选取技巧。重点对比直接索引、.loc(标签)与.iloc(整数下标)的区别,并介绍布尔索引与混用方法.ix的使用场景与注意事项。
本文介绍Python中训练数据与标签同步打乱的两种常用方法。第一种通过生成并打乱索引数组来重排数据,适用于大数据量以节约内存且每次结果不同;第二种利用随机种子固定打乱顺序,分别对数据和标签执行shuffle。两者各有适用场景,可根据需求选择。
本文介绍在pandas中进行数据映射时如何正确识别NaN值。通过自定义函数结合pd.isnull()判断空值,实现等频或等距切分。示例展示了age_map函数的逻辑及map函数的应用,确保分类准确处理缺失数据。
本文详细介绍在 Python 中导入 CSV 文件的三种常用方法。首先通过标准库 csv 结合 NumPy 数组处理基础数据;其次利用 NumPy 的 loadtxt 函数处理无表头且类型统一的数据;最后重点推荐 Pandas 库的 read_csv 函数,因其返回 DataFrame 结构,便于后续数据清洗与机器学习建模,是实际开发中的首选方案。
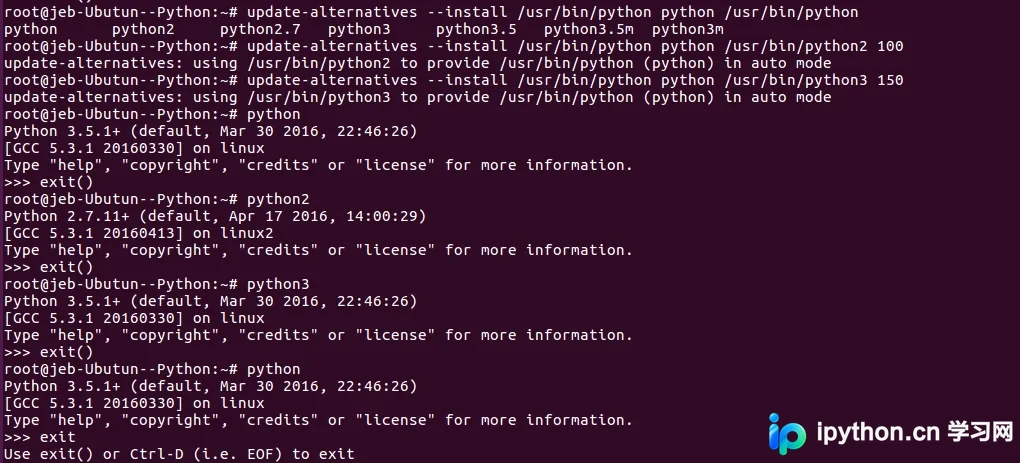
本文介绍在 Ubuntu 16.04 系统中通过 update-alternatives 命令将 Python3 设置为默认 Python 版本的操作步骤。包括安装版本优先级、切换回 Python2 的配置命令及具体执行方式,帮助开发者快速完成环境配置。
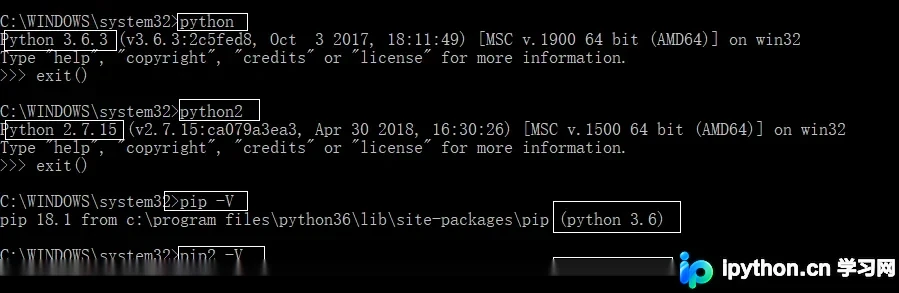
本文介绍在Windows系统中同时安装Python 2和Python 3时,如何将Python 3设置为默认运行版本。通过修改系统环境变量,并针对性地重命名或复制根目录及Scripts文件夹下的可执行文件(如python.exe和pip.exe),可实现命令行调用默认指向Python 3。操作完成后,通过命令行验证版本信息以确认配置成功。
本文介绍在Python中分离中英文文本的两种常用方法。针对超短文本,可通过ASCII码值直接过滤;对于复杂混合文本,利用Unicode编码范围\u4e00-\u9fa5及正则表达式匹配英文字符与空格,实现精准提取。