

pandas DataFrame行列索引获取、重命名及数据选取详解

本文详解pandas中DataFrame的行列索引操作。涵盖获取index与columns、使用rename灵活修改索引(支持部分修改与inplace参数),以及数据选取技巧。重点对比直接索引、.loc(标签)与.iloc(整数下标)的区别,并介绍布尔索引与混用方法.ix的使用场景与注意事项。
本文整理pandas数据选取的相关操作,首先介绍行列索引的获取与修改方法,以便后续更高效地获取数据。该文档旨在作为学习过程中的巩固资料。
文章主要内容顺序为:行列索引的获取、行列索引的修改、以及数据的选择操作。
一、pandas DataFrame行列索引的获取与修改
1. 获取方法:通过 df.index 和 df.columns 属性。
首先,构建一个示例DataFrame对象,代码如下:
>>>import pandas as pd
>>>import numpy as np
>>>data = pd.DataFrame({'a':[1,2,3],'b':[4,5,6],'c':[7,8,9]})
>>>data
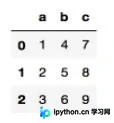
此处设置列索引为 'a', 'b', 'c',行索引默认为自动生成,用户也可手动指定。
>>>data.index = ['A','B','C']
>>>data
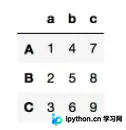
后续所有操作均基于上述创建的 data 对象进行演示。
接下来演示如何获取索引信息,其中 index 属性用于获取行索引,columns 属性用于获取列索引。
>>>data.index
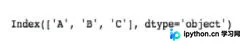
>>>data.columns
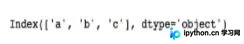
2. 修改方法:虽然有多种方式,此处推荐一种较为灵活且常用的方法。
 df.rename(index={ }, columns={ }, inplace=True)
>>>data.rename(index={'A':'D', 'B':'E', 'C':'F'}, columns={'a':'d', 'b':'e', 'c':'f'}, inplace = True)
>>>data
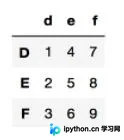
说明以下三个关键点:
1. index 和 columns 参数相互独立,可以分别指定。这意味着可以仅修改行索引,此时在 rename() 函数中只需传入 index 参数。
2. 索引可以按需选择性修改。例如 index={'A':'D', 'C':'F'} 表示仅将 'A' 改为 'D','C' 改为 'F',columns 参数同理。
3. 设置 inplace=True 可在原 DataFrame 对象上直接进行修改,无需重新赋值。
二、pandas DataFrame的数据选取
1. 直接使用中括号索引(灵活性较低,不推荐):df[ ]。
1)选取单列数据,例如 'a' 列。
>>>data['a']

注意事项:
1. 通过此方式取出的数据类型为 Series。
2. 该方法仅能选取单列,不支持数字下标,也无法进行多选或切片操作。例如 data['a','b']、data['a':'c'] 或 data[0] 均无法按预期工作。
2)选取多行数据,例如 'A' 到 'B' 行。
>>>data['A':'B']
>>>data[0:2] # 两种方法同一结果
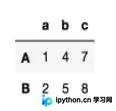
注意事项:
1. 通过此方式取出的数据类型为 DataFrame。
2. 该方法仅适用于行的切片选取,支持使用数字下标,但不能单独选取某一行。例如 data['A']、data['A','B'] 或 data[1] 无法直接选取单行。
2. 使用 .loc() 方法(推荐):df.loc(),括号内参数顺序为先行后列,通过标签区分行列选取方式。
1) 选取指定列:
>>>data.loc[:,['a','c']] #图1 需要行全取,再对应指定列
2)选取指定行:
>>>data.loc[['A','B']] #图2 直接指定行
3)选取行列交叉区域的值:
>>>data.loc[['A'],['b','c']] #图3
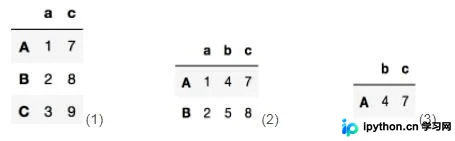
注意事项:
1. 需区分 df.iloc() 的用法。
.loc() —— 使用标签(label)作为索引进行取值。
.iloc() —— 使用整数下标(index)作为索引进行取值。上述三种情况可分别替换为以下对应语句,注意输出数据类型存在差异。
>>>data.iloc[:,[0,2]] # DataFrame
>>>data.iloc[[0,1]] # DataFrame
>>>data.iloc[0,[1,2]] # Series
2. 对于数值型变量,可以使用布尔条件选取行,但列选取不支持布尔索引。例如:
>>>data.loc[data.b>5] # DataFrame
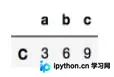
>>>data.loc[data.b>5,['c']] #DataFrame 输出为9位置的frame
>>>data.iloc[data.b.values>5,[2]] #DataFrame 输出同上,需要有 .values取值
3. .ix[ ] 方法允许混用标签(label)和下标(index),其位置参数用法与 .loc[ ] 和 .iloc[ ] 类似。
以上关于pandas行列名修改与数据选取的详解内容分享完毕,希望能为读者提供参考,欢迎支持。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









