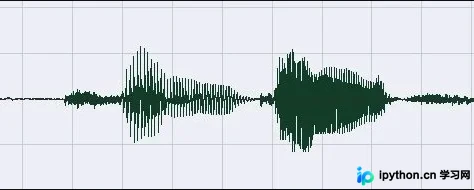
Python实现WebRTC语音端点检测:从原理到代码实战
本文详解利用Python及webrtcvad库实现语音端点检测(VAD)的方法。文章介绍了语音处理系统中ASR、NLU、TTS的流程,重点分析本地音频采集中的降噪、回声消除及VAD技术。通过对比唤醒词方案,展示了基于WebRTC VAD的纯语音起始与结束判定逻辑,并提供了完整的Python代码示例及运行方式,适合希望优化语音交互体验的开发者参考。
2026-10-13
17

本文详解利用Python及webrtcvad库实现语音端点检测(VAD)的方法。文章介绍了语音处理系统中ASR、NLU、TTS的流程,重点分析本地音频采集中的降噪、回声消除及VAD技术。通过对比唤醒词方案,展示了基于WebRTC VAD的纯语音起始与结束判定逻辑,并提供了完整的Python代码示例及运行方式,适合希望优化语音交互体验的开发者参考。
本文详细介绍Python虚拟环境工具virtualenv的安装与配置方法。涵盖从基础安装、创建指定解释器的虚拟环境,到激活、退出及删除环境的完整操作流程。同时深入讲解virtualenvwrapper的高级管理功能,包括统一目录管理、环境切换及批量操作命令,帮助开发者实现项目依赖的完全隔离与高效管理。
本文详细介绍Python中时间处理的核心操作,涵盖时间戳定义与计算、当前时间获取、时间差运算及文件时间戳提取。重点解析time与datetime模块用法,提供完整的时间日期格式化符号对照表,并通过代码示例演示时间加减、格式化转换及常用工具推荐,帮助开发者高效掌握Python时间编程技巧。
本文介绍如何利用Anaconda发行版解决Python 2与Python 3共存开发的难题。通过Anaconda提供的包管理和虚拟环境功能,开发者可以方便地在不同Python版本间切换,并解决Windows平台下第三方库安装失败的问题。文章涵盖Anaconda下载、conda命令使用、国内镜像源配置等实用步骤。
本文介绍了Python中常用的加密模块,包括md5、sha和crypt模块。详细讲解了各模块的核心函数用法及参数说明,并通过具体代码示例展示了摘要生成和更新过程。此外,提供了多种在线加密解密工具链接,供开发者参考使用。
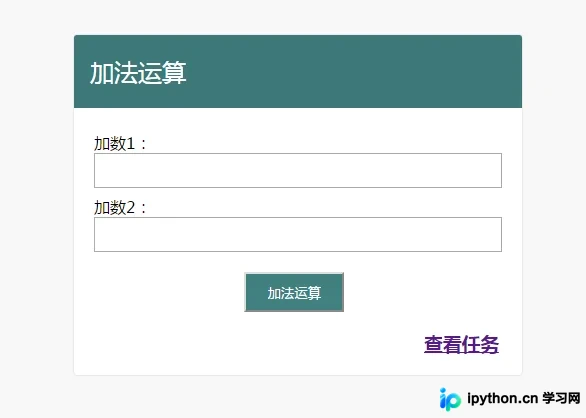
本文通过一个加法计算的小项目,详细演示如何在Django框架中集成Celery以解决长时间后台处理阻塞HTTP请求的问题。内容涵盖环境配置、项目结构设计、Broker与Backend选择、代码编写及Worker启动步骤,旨在提升Web应用的用户体验。
本文详细解析Python中获取当前路径的多种方法,包括os.getcwd()、sys.path[0]、sys.argv[0]及__file__相关函数。通过对比不同执行环境(如直接运行、py2exe打包)下的输出差异,帮助开发者准确获取脚本所在目录或执行起始目录,避免路径获取错误。
本文详细介绍Python中index()和seek()两个常用函数的用法。index()用于在序列中查找指定元素并返回首次出现的索引,支持通过beg和end参数指定搜索范围;seek()用于文件操作中移动读取指针,支持从文件头、当前位置或末尾进行偏移。文章通过具体代码示例演示了如何处理多次出现的情况及文件指针的移动技巧。
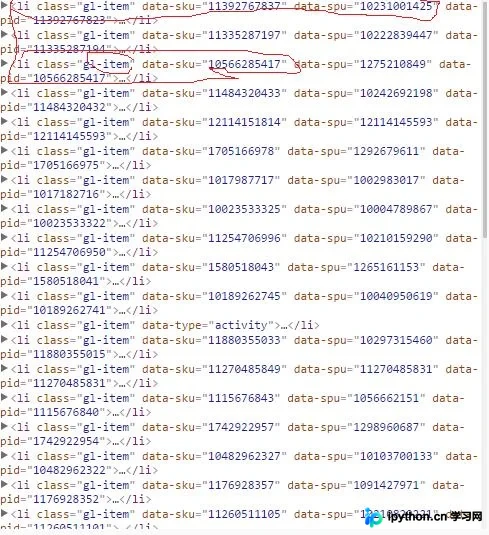
本文详解如何利用Python爬取京东商城商品数据。通过分析Ajax异步加载机制,结合Requests获取HTML源码,使用BeautifulSoup解析DOM结构提取data-pid及图片URL。教程涵盖简化请求URL、处理懒加载图片属性、多线程加速抓取及MySQL/MongoDB存储方案,提供完整代码逻辑与优化建议。
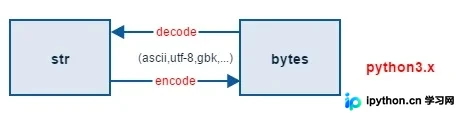
本文深入解析Python3如何解决Python2遗留的字符编码问题。通过对比Python2中ASCII默认编码及str/unicode混淆的缺陷,阐述Python3将默认编码设为UTF-8,并清晰区分str(文本)与bytes(二进制)类型。文章详细说明了bytes类型的定义、操作限制及与str的转换方法,包括encode和decode的具体应用,帮助开发者避免编码错误。
本文介绍如何使用Python的python-docx库,自动遍历指定目录下的特定后缀代码文件(如.cs),并将读取到的代码内容整理保存为Word文档。脚本支持处理中文编码,通过打印日志监控文件处理状态,确保生成包含标题、代码块及总行数的完整文档,适用于快速整理项目代码以申请专利或归档。
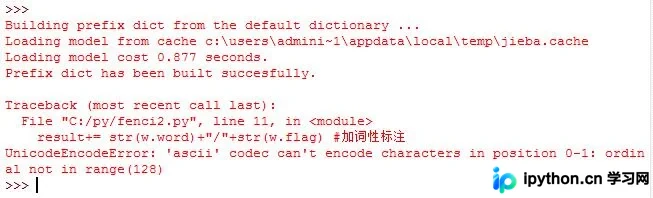
本文详细介绍Python中使用结巴分词库进行中文文本分词及词性标注的完整流程。通过读取文本文件、调用pseg.cut进行分词,并将结果保存至新文件。针对Python 2.7环境下常见的编码报错问题,提供了添加sys.setdefaultencoding("utf-8")的解决方案,附带完整代码示例及运行结果分析,帮助开发者快速掌握该工具的实际应用。