Python使用kafka-python库发送和接收JSON数据的完整示例

本文介绍如何使用Python的kafka-python库实现Kafka消息的JSON格式读写。重点解析生产者KafkaProducer中value_serializer参数的配置,通过json.dumps将字典编码为UTF-8字节流;以及消费者KafkaConsumer中value_deserializer参数的设置,利用json.loads解析消息。示例包含完整的连接配置、数据构造及循环发送逻辑,适用于需要结构化数据传输的场景。

Python xlrd读取Excel时间字段的转换方法

本文详解如何使用Python的xlrd库读取Excel中的时间数据。Excel存储的时间为浮点数,通过xldate_as_tuple函数可将其转换为datetime类型。文章介绍了该函数的基准日期参数设置及返回值格式,帮助开发者准确处理Excel时间字段。

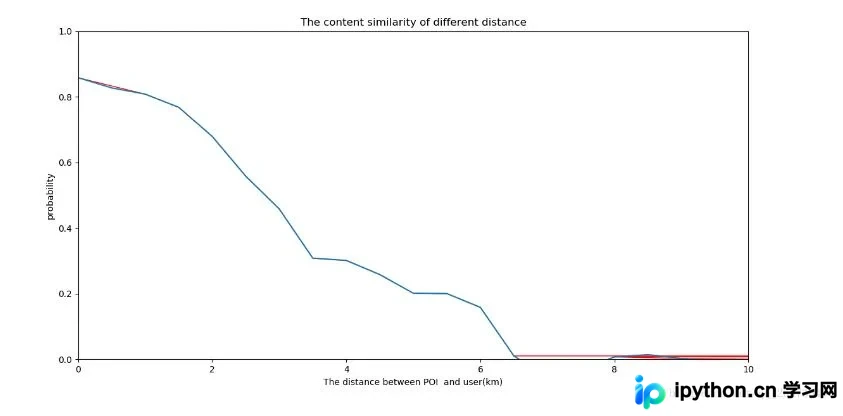
Python利用插值法实现折线平滑处理

本文介绍如何在Python中利用Scipy库的插值功能对折线数据进行平滑处理。通过对比拟合与插值的区别,详细解析nearest、cubic等插值方法,并提供完整代码示例,展示如何将原始折线转化为平滑曲线,适用于数据可视化优化场景。

Python利用插值法实现折线平滑处理

Celery 4与Django 2原生集成实现定时任务详解

本文介绍如何在Celery 4和Django 2环境下,利用原生Celery Beat实现高效定时任务,无需依赖djcelery或django_celery_beat等第三方插件。通过配置celery.py、tasks.py及settings.py,结合Redis作为消息队列,可简化部署流程。文中详细说明了任务定义、调度策略设置、启动脚本编写及日志监控方法,强调生产环境应避免使用Root权限运行Celery,确保系统安全与稳定。

Python获取二维数组行列数的两种实现方式

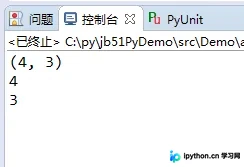
本文介绍在Python中获取二维数组行列数的两种常用方法。第一种利用numpy库的shape属性,可一次性获取形状或单独提取行列数值;第二种针对原生列表构成的二维数组,通过len函数分别计算外层和内层长度。文章包含具体代码示例及运行结果,适用于Python基础数据处理场景。

Python获取二维数组行列数的两种实现方式

Python实现TCP端口扫描:从基础到多线程与Nmap集成

本文详细介绍如何使用Python进行TCP端口扫描。从利用socket库建立全连接扫描器开始,演示如何检测主机开放端口。接着通过发送数据捕获应用标识以识别服务类型。为解决扫描延迟问题,引入多线程技术实现并发扫描。最后对比展示了使用nmap库进行扫描的方法,帮助读者掌握不同场景下的端口扫描技巧。

Python通用循环构造方法详解:交互、哨兵与文件处理

本文深入解析Python中几种通用循环构造方法,包括允许用户交互的无限循环、通过特定数据终止的哨兵循环,以及基于文件行的读取模式。文章详细说明了哨兵值的设定原则、eval()函数的应用及readline()在文件处理中的关键作用,并指出处理含换行符的空行时需注意的细节,旨在帮助开发者掌握不同场景下的循环控制技巧。

Python3 Pika连接断开问题排查与解决方案

本文针对Python3使用Pika库消费RabbitMQ队列时出现的连接断开问题进行分析。通过排查发现,当回调函数执行耗时操作时,若未正确理解heartbeat_interval参数含义,会导致连接被服务端强制关闭。文章详细解释了该参数的作用机制,并提供了正确的配置建议,避免手动添加复杂心跳线程。

在Scrapy中集成PhantomJS实现异步AJAX爬取

本文介绍如何在Scrapy中集成PhantomJS以实现异步AJ数据爬取。通过重写Downloader并引入Semaphore控制并发,解决传统同步集成的性能瓶颈。代码展示了如何配置PhantomJSDownloadHandler,利用线程池和队列管理浏览器实例,从而在保持Scrapy高效并发能力的同时,处理需要JavaScript渲染的网页内容。