OpenCV实现简单标准数字识别完整教程
本文介绍如何利用OpenCV的ml模块中的KNearest算法实现标准数字识别。通过图像预处理、自适应阈值化及轮廓提取构建训练集,保存特征数据后加载模型进行预测。文中提供完整的Python代码示例,涵盖从数据生成到识别输出的全过程,适合OpenCV初学者参考学习。
2026-10-14
6

本文介绍如何利用OpenCV的ml模块中的KNearest算法实现标准数字识别。通过图像预处理、自适应阈值化及轮廓提取构建训练集,保存特征数据后加载模型进行预测。文中提供完整的Python代码示例,涵盖从数据生成到识别输出的全过程,适合OpenCV初学者参考学习。
本文介绍基于Python3和Windows环境的爬虫开发基础,涵盖Anaconda与Jupyter工具使用。详细解析Robots协议规范、动态页面处理及反爬策略。同时展望Python在数据分析、人工智能、运维自动化及Web开发领域的核心应用与实战价值。
本文介绍如何在TensorFlow2中通过自定义网络构建复杂结构。详细讲解Sequential容器的使用方法,以及如何继承Model和Layer类实现[[wp:a3]]和[[wp:a4]]来自定义层。结合CIFAR-10数据集案例,展示完整代码实现与训练输出结果,帮助开发者掌握自定义网络结构的技巧。
本文介绍TensorFlow2中全连接层的实现方法。详细解析keras.layers.Dense的参数配置与权重形状,以及使用Sequential构建多层线性网络模型。通过代码示例展示如何定义层、设置激活函数并查看内部参数,帮助开发者快速掌握基础网络构建。
本文详解使用Python从本地读取MNIST手写数字数据集的方法。涵盖.gz压缩格式与解压缩后.ubyte格式的两种读取策略,解析文件头Magic Number与样本数量结构,提供训练集与测试集的完整加载代码及验证步骤,适用于机器学习入门与模型训练准备。
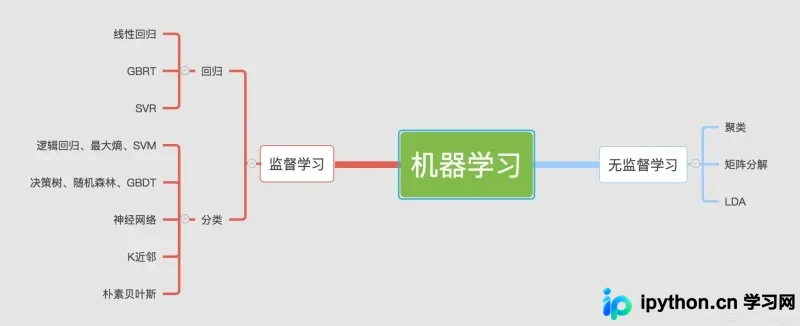
本文作为Python机器学习系列的开篇,系统梳理了机器学习的基本概念、监督与无监督学习的区别,以及基于Python的数据科学生态。重点详解了SciPy、NumPy、Pandas等核心库的作用,并提供了通过清华镜像安装Anaconda及验证环境配置的完整操作步骤,帮助初学者快速搭建开发环境并理解机器学习工作流。
本文详细介绍K-means聚类算法的原理、目标函数及Python实现流程。涵盖初始化质心、迭代更新与收敛判断,提供基于sklearn与手动实现的代码示例,并分析算法优缺点及注意事项。
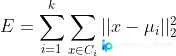
本文深入解析Python环境下的模型集成技术,强调模型多样性对提升预测性能的关键作用。详细对比了简单平均与加权平均两种集成策略,并系统介绍了Bagging(挂袋法)、加权提升法及梯度提升法的核心原理与适用场景,为构建更稳定、准确的机器学习模型提供理论依据与实践指导。
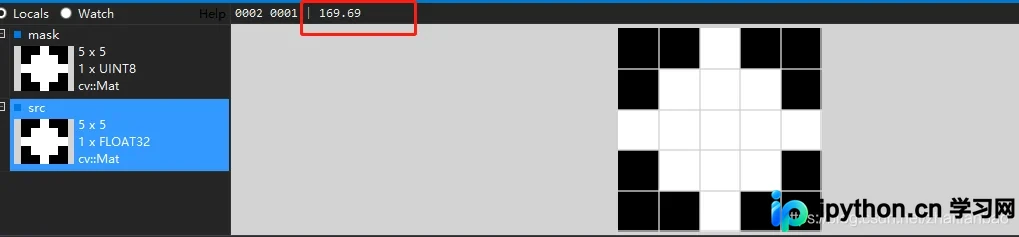
本文介绍OpenCV中cv::mean函数的用法,用于计算cv::Mat矩阵的平均值。该函数支持指定通道及掩膜(mask)进行局部计算。通过C++测试代码演示如何结合掩膜筛选特定区域数据,并对比手动计算与函数结果,验证其准确性。
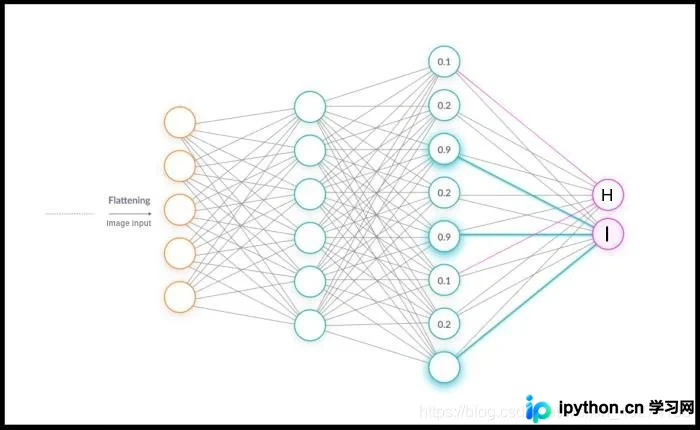
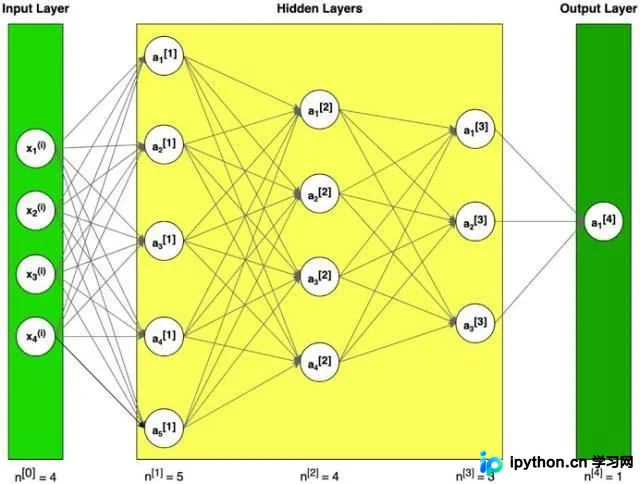
本文详细解析如何使用Python从零构建支持任意层数的深度神经网络。内容涵盖神经网络基础原理、数据集预处理、参数初始化策略、Sigmoid与ReLU激活函数应用,以及正向传播、损失函数计算和反向传播的核心算法。通过完整的Python代码示例,展示如何定义模型架构、执行梯度下降优化及更新参数,帮助开发者掌握深度学习模型构建的关键步骤。
本文详细介绍PaddleOCR库的安装配置、基础代码实现及核心功能特性。PaddleOCR支持中英文数字组合识别、竖排及长文本处理,提供轻量级模型与多种检测识别算法。文章涵盖从环境搭建到实际调用的完整流程,并列举其跨平台部署与移动端支持能力,助力开发者快速落地OCR应用。
本文详解如何利用Python抓取百度贴吧表情包,并通过百度AI开放平台的OCR接口识别图片文字。文章涵盖API Key申请、贴吧数据抓取及多线程下载,最终实现根据识别出的主要文字自动重命名图片文件,提升表情包管理效率。