

Python实现K-means聚类算法详解:原理、流程与代码

本文详细介绍K-means聚类算法的原理、目标函数及Python实现流程。涵盖初始化质心、迭代更新与收敛判断,提供基于sklearn与手动实现的代码示例,并分析算法优缺点及注意事项。
前言
K-Means是一种基础的聚类算法,属于无监督学习范畴。该算法在给定聚类数量和输入数据集的情况下,旨在将数据划分为若干簇,使得簇内数据点具有较高的相似性,而不同簇之间的数据点具有较低的相似性。
算法原理
第一步是初始化聚类中心。这可以通过在输入数据范围内随机选择,或者使用现有的训练样本来完成(推荐使用后者)。
第二步是迭代直至收敛。
- 在每次迭代中,将每个数据点分配到距离最近的聚类。点与聚类中心之间的距离通过欧几里德距离进行计算。
- 随后,更新聚类中心的估计值,将其设置为属于该聚类的所有数据点的平均值。
目标函数
聚类算法的目标函数旨在寻找最优的聚类中心,使得数据被划分到相应的簇中,并最小化数据点与其最近聚类中心之间的距离。
给定一组数据X1至Xn以及一个正整数k,目标是找到k个聚类中心C1至Ck,以最小化以下目标函数:
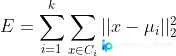 其中
 代表质心,其计算表达式为
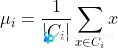
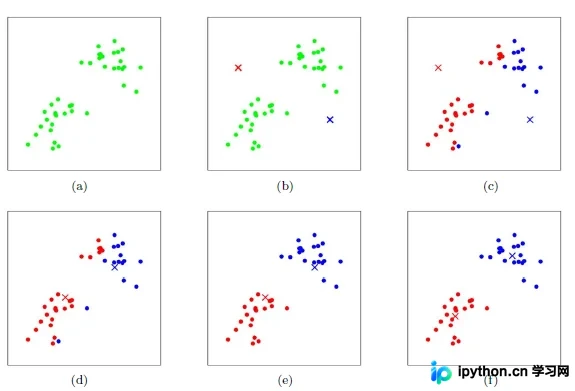
上图a展示了初始数据集,假设k=2。在图b中,我们随机选择了两个类别的质心,即图中的红色和蓝色质心。接着计算所有样本点到这两个质心的距离,并将每个样本标记为距离最近的质心所属的类别,如图c所示。经过计算,我们得到了所有样本点在第一轮迭代后的类别。此时,我们对当前标记为红色和蓝色的点分别计算新的质心,如图4所示,新的红色和蓝色质心位置已发生变动。图e和图f重复了图c和图d的过程,即将所有点的类别标记为距离最近的质心所属类别并重新计算质心。最终得到两个类别,如图f所示。当然,在实际K-Means算法中,通常需要多次运行图c和图d,才能达到较为理想的分类结果。
算法流程
注意事项:
- 对于K-Means算法,首要关注的是k值的选择。通常,我们会根据对数据的先验知识选择合适的k值。若缺乏先验知识,则可以通过交叉验证来确定合适的k值。
- 在确定k的个数后,需要选择k个初始质心,如上图b中的随机质心。由于这是一种启发式方法,初始质心的位置对最终的聚类结果和运行时间有重大影响,因此需要谨慎选择初始质心,最好确保这些质心之间不要过于接近。
流程:
输入包括样本集D={x1,x2,...xm},聚类簇数k,以及最大迭代次数N。
输出为簇划分C={C1,C2,...Ck}。
1) 从数据集D中随机选择k个样本作为初始的k个质心向量:{μ1,μ2,...,μk}。
2)对于n=1,2,...,N执行以下操作:
a) 将簇划分C初始化为Ct=∅,其中t=1,2...k。
b) 对于i=1,2...m,计算样本xi与各个质心向量μj(j=1,2,...k)的距离: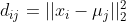 ,将xi标记为距离最小的
 所对应的类别
 。此时更新
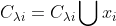 。
c) 对于j=1,2,...,k,对Cj中所有的样本点重新计算新的质心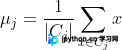 。
e) 如果所有的k个质心向量都没有发生变化,则转到步骤3)。
3)输出簇划分C={C1,C2,...Ck}。
Python实现
import numpy as np
import matplotlib.pyplot as plt
import random
from sklearn.datasets import make_blobs
np.random.seed(123)
from sklearn.cluster import KMeans
class Kmeans:
    def __init__(self,data,k):
        self.data=data
        self.k = k
    def cluster_data_Bysklearn(self):
        kmeans_model = KMeans(self.k,random_state=1)
        labels = kmeans_model.fit(self.data).labels_
        print(labels)
        return labels

    def kmeans(self):
        # 获取4个随机数
        rarray = np.random.random(size=self.k)
        # 乘以数据集大小——>数据集中随机的4个点
        rarray = np.floor(rarray * len(self.data))
        # 转为int
        rarray = rarray.astype(int)
        print('数据集中随机索引', rarray)
        # 随机取数据集中的4个点作为初始中心点
        center = data[rarray]
        # 测试比较偏、比较集中的点,效果依然完美,测试需要删除以上代码
        # center = np.array([[4.6,-2.5],[4.4,-1.7],[4.3,-0.7],[4.8,-1.1]])
        # 1行80列的0数组,标记每个样本所属的类(k[i])
        cls = np.zeros([len(self.data)], np.int)
        print('初始center=\n', center)
        run = True
        time = 0
        n = len(self.data)
        while run:
            time = time + 1
            for i in range(n):
                # 求差
                tmp = data[i] - center
                # 求平方
                tmp = np.square(tmp)
                # axis=1表示按行求和
                tmp = np.sum(tmp, axis=1)
                # 取最小(最近)的给该点“染色”(标记每个样本所属的类(k[i]))
                cls[i] = np.argmin(tmp)
            # 如果没有修改各分类中心点,就结束循环
            run = False
            # 计算更新每个类的中心点
            for i in range(self.k):
                # 找到属于该类的所有样本
                club = data[cls == i]
                # axis=0表示按列求平均值,计算出新的中心点
                newcenter = np.mean(club, axis=0)
                # 如果新旧center的差距很小,看做他们相等,否则更新之。run置true,再来一次循环
                ss = np.abs(center[i] - newcenter)
                if np.sum(ss, axis=0) > 1e-4:
                    center[i] = newcenter
                    run = True
            print('new center=\n', center)
        print('程序结束,迭代次数:', time)
        # 按类打印图表,因为每打印一次,颜色都不一样,所以可区分出来
        # for i in range(self.k):
        #     club = data[cls == i]
        #     self.showtable(club)
        # 打印最后的中心点
        self.showtable(center)
        #打印聚类标签
        print(cls)

    def showtable(self,data):
        x = data.T[0]
        y = data.T[1]
        plt.scatter(x, y)
        plt.show()

if __name__ == '__main__':
    data = np.random.rand(10,2)
    K = 4
    model = Kmeans(data,K)

    model.kmeans()
    model.cluster_data_Bysklearn()
结果:
自写得出的 [0 2 0 0 0 2 3 2 1 2] 调用模型的出的[0 2 0 1 0 2 3 2 3 0]
jupyter notebook实现
import numpy as np
import matplotlib.pyplot as plt
import random
from sklearn.datasets import make_blobs


%matplotlib inline
X, y = make_blobs(centers=6, n_samples=1000)
print(f'Shape of dataset: {X.shape}')

fig = plt.figure(figsize=(8,6))
plt.scatter(X[:,0], X[:,1], c=y)
plt.title("Dataset with 6 clusters")
plt.xlabel("First feature")
plt.ylabel("Second feature")
plt.show()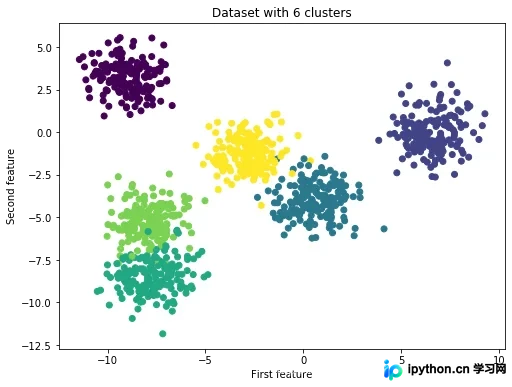
class KMeans():
    def __init__(self, n_clusters=6):
        self.k = n_clusters

    def fit(self, data):
        """
        Fits the k-means model to the given dataset
        """
        n_samples, _ = data.shape
        # initialize cluster centers
        self.centers = np.array(random.sample(list(data), self.k))
        self.initial_centers = np.copy(self.centers)

        # We will keep track of whether the assignment of data points
        # to the clusters has changed. If it stops changing, we are
        # done fitting the model
        old_assigns = None
        n_iters = 0

        while True:
            new_assigns = [self.classify(datapoint) for datapoint in data]

            if new_assigns == old_assigns:
                print(f"Training finished after {n_iters} iterations!")
                return

            old_assigns = new_assigns
            n_iters += 1

            # recalculate centers
            for id_ in range(self.k):
                points_idx = np.where(np.array(new_assigns) == id_)
                datapoints = data[points_idx]
                self.centers[id_] = datapoints.mean(axis=0)

    def l2_distance(self, datapoint):
        dists = np.sqrt(np.sum((self.centers - datapoint)**2, axis=1))
        return dists

    def classify(self, datapoint):
        """
        Given a datapoint, compute the cluster closest to the
        datapoint. Return the cluster ID of that cluster.
        """
        dists = self.l2_distance(datapoint)
        return np.argmin(dists)

    def plot_clusters(self, data):
        plt.figure(figsize=(12,10))
        plt.title("Initial centers in black, final centers in red")
        plt.scatter(data[:, 0], data[:, 1], marker='.', c='y')
        plt.scatter(self.centers[:, 0], self.centers[:,1], c='r')
        plt.scatter(self.initial_centers[:, 0], self.initial_centers[:,1], c='k')
        plt.show()
X = np.random.randn(10,100)
kmeans = KMeans(n_clusters=6)
kmeans.fit(X)
for data in X:
    print(kmeans.classify(data))
总结
K-Means的主要优点:
1)原理简单,容易实现。
2)可解释度较强。
K-Means的主要缺点:
1)K值很难确定。
2)容易陷入局部最优。
3)对噪音和异常点敏感。
4)需样本存在均值(限定数据种类)。
5)聚类效果依赖于聚类中心的初始化。
6)对于非凸数据集或类别规模差异太大的数据效果不好。
到此这篇关于利用Python如何实现K-means聚类算法的文章就介绍到这了,更多相关Python实现K-means聚类算法内容请搜索本站以前的文章或继续浏览下面的相关文章希望大家以后多多支持本站!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









