

Python生成1100个指定范围随机数的方法

本文详细讲解在Python中生成1100个指定范围随机数的多种方法,涵盖允许重复、唯一不重复、浮点数以及NumPy高性能生成等场景,解析区间边界规则与避坑指南。
random.choices 适合快速生成允许重复的整数,random.sample 用于无重复抽样,而科学计算库 NumPy 则能在海量运算中提供纳秒级的批量生成速度。
一、明确需求场景与技术选型
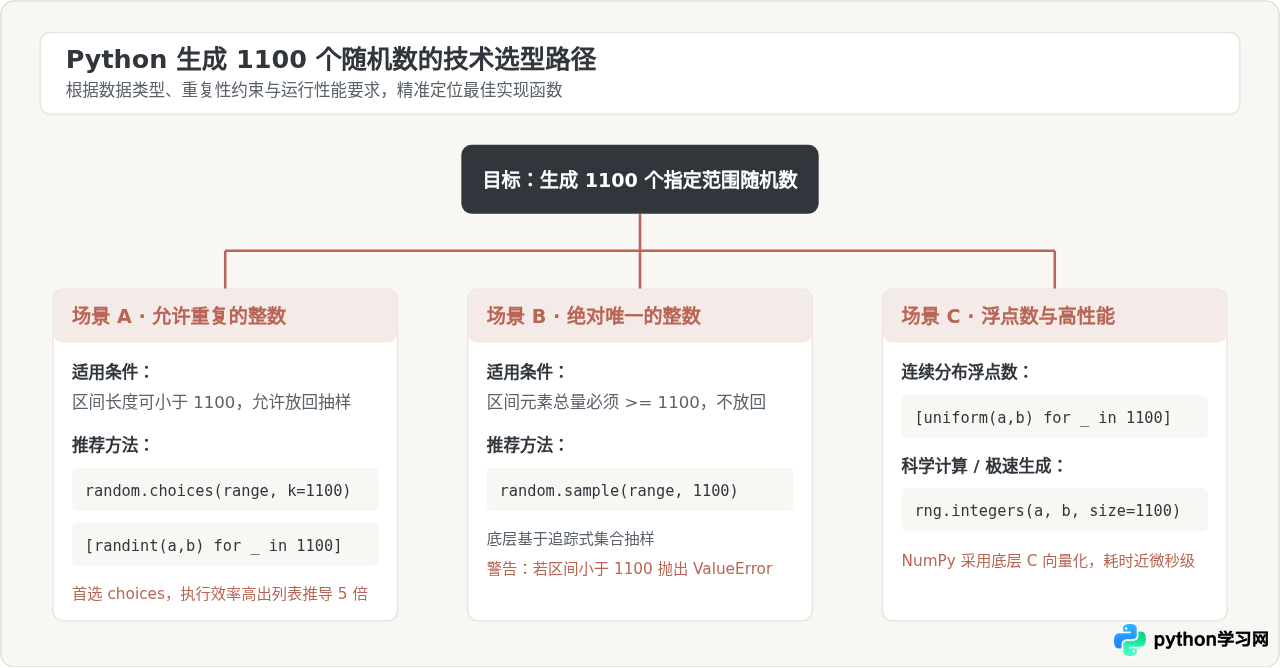
在编写代码前,必须先厘清“指定范围”与“1100个”组合下的具体业务边界。例如,目标区间是 [1, 100] 还是 [1000, 9999]?如果要求这 1100 个数字完全互不相同,那么目标区间的可用整数总量就必须大于或等于 1100,否则在数学上无法成立。
根据这几项判定条件,可以将生成方式清晰划分为四种典型方案,如下方技术选型路径所示:
二、核心方法一:生成允许重复的指定范围整数
当业务场景允许同一个数字出现多次时(例如模拟 1100 次投骰子、生成测试电话号码后四位等),属于“有放回抽样”。Python 标准库提供了两种主要写法。
1. 推荐方案:使用 random.choices
Python 3.6 及以上版本引入了 random.choices 函数。通过将目标范围定义为一个 range 序列,并指定参数 k=1100,函数能在底层循环中快速抽取 1100 个元素并返回列表。
import random

# 设定目标范围为 [10, 50](包含 10 和 50)
start_val = 10
end_val = 50
total_count = 1100

# range 右端点是开区间,因此需要 end_val + 1
numbers = random.choices(range(start_val, end_val + 1), k=total_count)

# 结果验证
print(f"生成数量: {len(numbers)}")
print(f"前5个数字: {numbers[:5]}")
print(f"最小值: {min(numbers)}, 最大值: {max(numbers)}")生成数量: 1100前5个数字: [42, 17, 33, 42, 10]最小值: 10, 最大值: 50
2. 基础方案:列表推导式配合 random.randint
如果读者刚开始接触 Python,列表推导式配合 random.randint(a, b) 是直观好懂的方案。randint 的区间定义为双闭区间 [a, b],即两端数值都能取到。
import random

# 生成 1100 个在 1 到 100 之间(闭区间)的随机整数
numbers_comp = [random.randint(1, 100) for _ in range(1100)]
虽然列表推导式直观,但由于在 Python 层面连续调用了 1100 次函数,耗时通常是 random.choices 的 4 到 6 倍。在批量生成 1100 个或更多元素时,优先选用 random.choices。
三、核心方法二:生成互不重复的指定范围整数
在许多现实任务中,如生成批次抽奖编号、问卷用户样本分配等,要求这 1100 个数字彼此互不重复。这属于“无放回抽样”。
无放回抽样必须使用标准库的 random.sample 函数。该函数接收一个总体序列与抽样数量 k。
import random

# 目标范围:[1000, 3000]
start_val = 1000
end_val = 3000
total_count = 1100

# 严谨校验:区间包含的独立整数总量是否满足抽样数量
available_count = end_val - start_val + 1
if available_count < total_count:
    raise ValueError(f"范围内的整数数量({available_count})不足以抽取 {total_count} 个互不相同的数!")

# 执行无放回抽样
unique_numbers = random.sample(range(start_val, end_val + 1), k=total_count)

# 验证唯一性与长度
print(f"生成数量: {len(unique_numbers)}")
print(f"去重后数量: {len(set(unique_numbers))}")
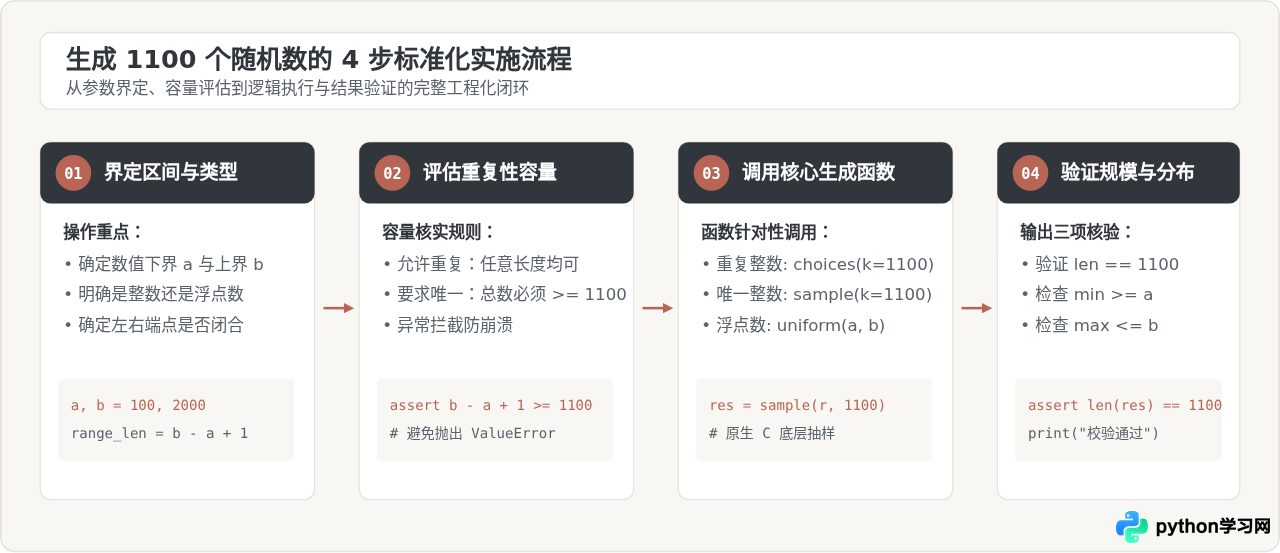
如果设定的范围是 range(1, 1000),其中只有 999 个数字,执行 random.sample(..., 1100) 时,Python 会直接抛出:
ValueError: Sample larger than population or is negative。
因此,只要涉及唯一随机数,务必确保 (上限 - 下限 + 1) >= 1100。
四、核心方法三:生成指定范围的浮点数
当业务处理物理模拟、坐标位移、概率模型或经纬度随机扰动时,往往需要指定范围的连续浮点数。Python 标准库使用 random.uniform(a, b) 来生成范围内的均匀分布浮点数。
import random

# 生成 1100 个在 5.0 到 20.0 之间的浮点数
lower_bound = 5.0
upper_bound = 20.0

# 保留 4 位小数(可根据需要省略 round)
float_numbers = [
    round(random.uniform(lower_bound, upper_bound), 4)
    for _ in range(1100)
]

print(f"生成数量: {len(float_numbers)}")
print(f"样例切片: {float_numbers[:3]}")
random.uniform(a, b) 计算公式为 a + (b - a) * random()。在浮点精度范围内,两端理论上都可以取到,但在实际连续抽样中,命中完全相同浮点数的概率极低。
五、高性能场景:利用 NumPy 批量生成
当程序处于数据分析、机器学习或需要频繁生成批量测试数据的环境时,推荐使用第三方库 NumPy。
自 NumPy 1.17 开始,官方推荐通过 np.random.default_rng() 构建现代随机数生成器。其在底层基于 PCG64 算法与 C 语言连续内存分配,生成 1100 个随机数耗时仅在微秒级别。
import numpy as np

# 创建现代推荐生成器实例
rng = np.random.default_rng(seed=42)

# 场景 1:生成 1100 个指定范围 [10, 100] 的整数
# endpoint=True 表示包含右边界 100
np_integers = rng.integers(low=10, high=100, size=1100, endpoint=True)

# 场景 2:生成 1100 个指定范围 [0.0, 1.0) 的浮点数
np_floats = rng.uniform(low=0.0, high=1.0, size=1100)

# 场景 3:无重复抽取 1100 个唯一整数
np_unique = rng.choice(np.arange(1, 5001), size=1100, replace=False)

print(f"NumPy 数组类型: {type(np_integers)}, 数组维度: {np_integers.shape}")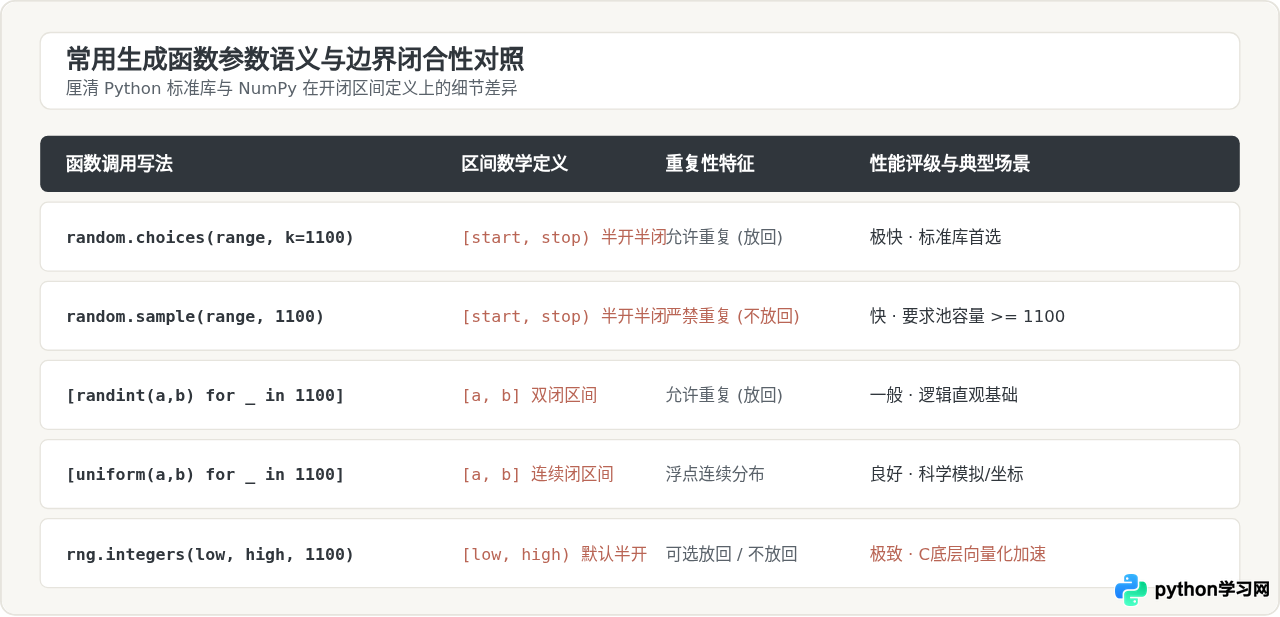
六、关键避坑点与注意事项
在批量生成随机数时,初学者和工程开发中最容易遇到以下三个问题:
1. 区间端点混淆(闭区间 vs 半开区间)
Python 内置函数对端点的处理规则并不完全一致:
random.randint(1, 100)是双闭区间,包含 1 和 100。range(1, 100)是左闭右开区间,只包含 1 到 99。如果传递给random.choices(range(1, 100), k=1100),生成的最大数只会是 99。- 若需要覆盖目标整数
b,配合range时务必写成range(a, b + 1)。
2. 随机种子的设置与可复现性(Reproducibility)
在自动化测试、算法演示或学术论文实验中,往往需要每次运行代码都生成完全相同的一组随机数。此时可以通过设置种子(Seed)来固定伪随机序列:
import random

# 设置固定种子
random.seed(2026)
batch_1 = random.choices(range(1, 500), k=1100)

# 再次设定相同种子
random.seed(2026)
batch_2 = random.choices(range(1, 500), k=1100)

# 验证两组数据完全一致
print(f"两次生成是否完全相同: {batch_1 == batch_2}")  # 输出: True
3. 安全敏感场景禁止使用伪随机
Python 标准库的 random 模块采用的是梅森旋转算法(Mersenne Twister)。该算法周期长、速度快,但属于确定性伪随机,绝不能用于密码生成、Token 签发或安全验证码。若有加密安全需求,应使用标准库内置的 secrets 模块。
七、总结
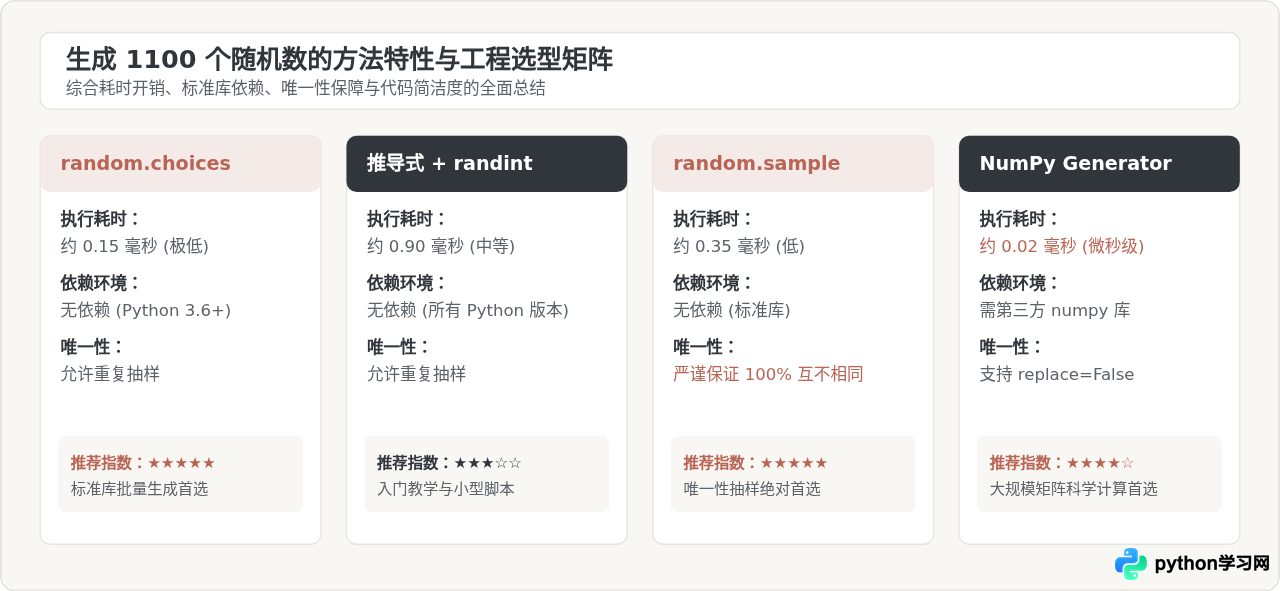
实现“Python生成1100个指定范围随机数”的核心依据可以总结为:
- 允许重复的整数:使用
random.choices(range(a, b + 1), k=1100),执行速度快,代码简洁。 - 互不重复的整数:使用
random.sample(range(a, b + 1), 1100),调用前务必确认候选元素总量(b - a + 1) >= 1100。 - 指定范围浮点数:使用列表推导式
[random.uniform(a, b) for _ in range(1100)]。 - 追求性能或矩阵运算:使用
numpy.random.default_rng().integers(low, high + 1, size=1100)。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









