

Python爬虫数据怎么存?CSV、Excel与MySQL存储方案详解

详解Python网络爬虫采集数据的三种主流落地存储方案:CSV纯文本、Excel电子表格与MySQL关系型数据库,涵盖具体代码实现、编码避坑、去重优化与场景选型指南。
编写Python网络爬虫时,网络请求和网页解析只是前半段工作,如何安全、高效、规范地将内存中的结构化数据持久化到磁盘上,决定了整个爬虫项目的实用价值。面对文本文件、电子表格和关系型数据库,初学者常在数据乱码、追加覆写冲突以及写入性能瓶颈等问题上反复折腾。本文将深入讲解CSV纯文本、Excel工作簿与MySQL数据库三种主流存储方案的具体落地方案,剖析代码实现、避坑细节与选型边界。
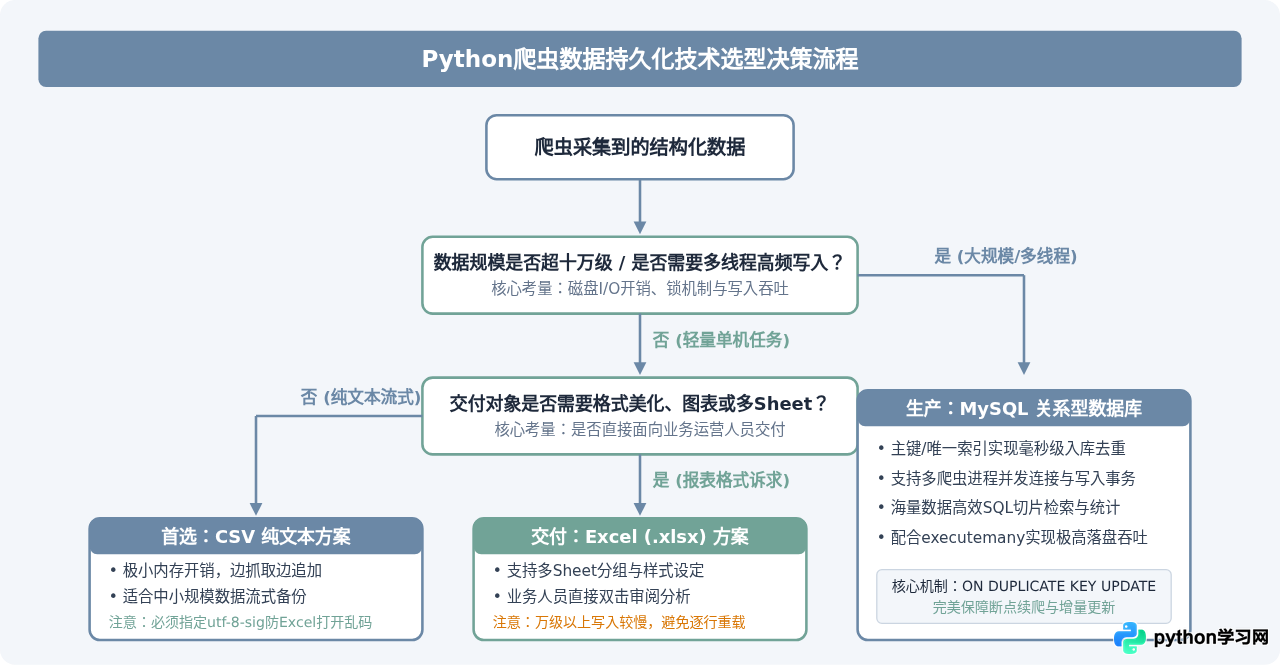
一、存储方案的选择路径与核心考量
爬虫存储方案的选择并不是越复杂越好,而是取决于四个核心指标:数据规模与写入频次、字段结构的稳定性、并发与去重要求,以及下游使用者的协作方式。在进入具体编码之前,我们需要建立清晰的判断标准:
- 数据量级与吞吐要求: 当采集目标只有几百到数万条记录时,单文件存储能以零外部依赖的优势快速验证逻辑;当数据上升到十万乃至数百万级别时,频繁打开写文件会导致I/O雪崩,必须使用具有索引支持的数据库。
- 数据防重与断点续爬: 文件形式难以在写入前低成本校验“这条URL或ID是否采集过”,而数据库原生具备主键(Primary Key)与唯一索引(Unique Index),能以极高的效率拦截重复数据并支持断点续爬。
- 下游交互与交付需求: 如果采集结果直接交给运营人员或业务分析人员查看,带样式排版的Excel最为便利;如果是作为下游算法模型或脚本处理的语料,通用纯文本CSV或数据库SQL接口则更加标准。
二、CSV方案:轻量、高效与边爬边存
CSV(Comma-Separated Values)是一种用逗号分隔字段的纯文本格式。由于其无需解析复杂的文档元数据,Python内置的标准库csv可以直接对其进行按行读写。对于绝大部分单机爬虫项目,CSV是默认首选。
1. 关键避坑点:换行符与中文乱码
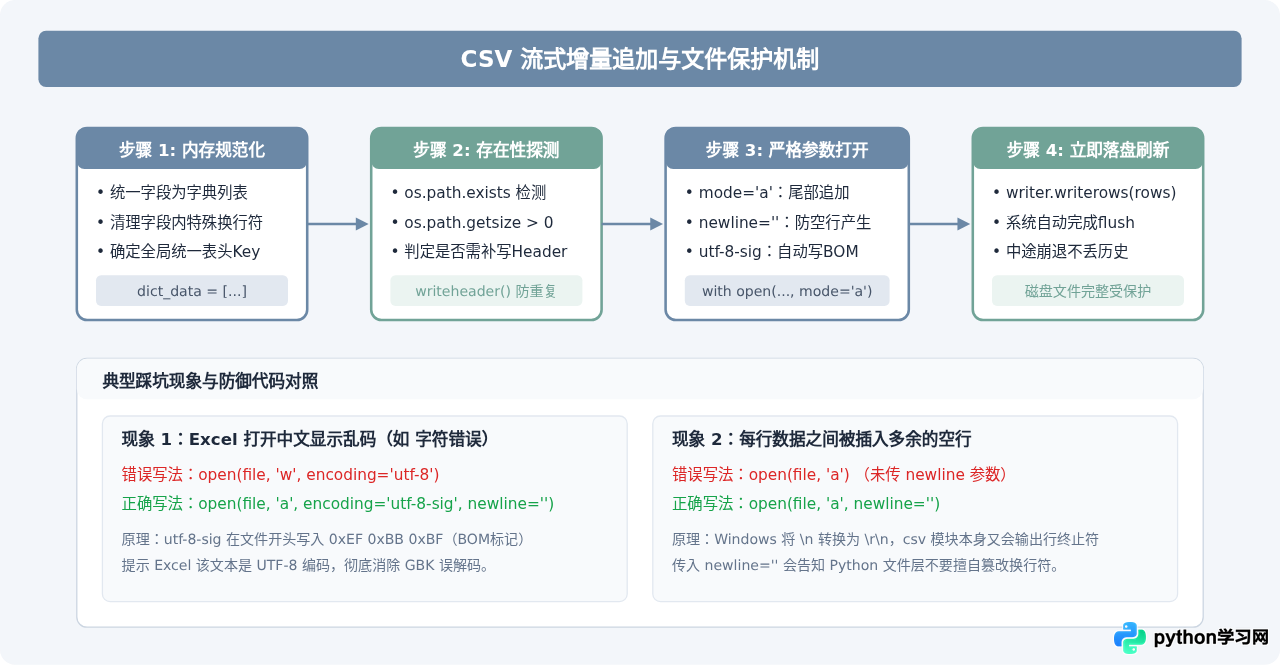
很多开发者在初次使用内置csv模块时,常遇到两个经典问题:每一行数据之间多出一个空行,以及生成的CSV在Windows版Excel中打开时中文全部显示为乱码。原因如下:
- 空行问题: Python的
open()函数在Windows下默认会将换行符转换为\r\n,而csv.writer在底层也会自动写入系统的换行终止符。两层处理叠加后就出现了连续换行。解决办法是:必须在open()中指定newline='',把换行符的控制权全权交由csv模块处理。 - 中文乱码: 现代程序默认采用无BOM的
utf-8编码,但Windows系统下的Excel在打开未指定BOM标记的文本文件时,会默认采用系统本地代码页(如GBK)解析,导致中文全部乱码。解决办法是:将文件编码显式指定为encoding='utf-8-sig'。带有签名标记(BOM)的文件既符合UTF-8标准,也能让Excel正确识别编码。
2. 增量写入的完整示例
爬虫在运行过程中随时可能因网络超时、反爬封禁或进程异常而中断。如果将全部抓取结果保存在内存列表中最后一次性写入,一旦中途崩溃就会丢失所有数据。因此,必须采用“获取一批,追加写入(Mode='a')一批”的流式机制。
import csv
import os

def save_to_csv(data_list, file_path="crawled_products.csv"):
    """
    将爬取的字典列表流式追加写入CSV文件
    :param data_list: list of dict, 形如 [{'id': 101, 'title': '商品A', 'price': 99.8}]
    :param file_path: 输出文件路径
    """
    if not data_list:
        return

    # 获取字段列表(表头)
    fieldnames = list(data_list[0].keys())

    # 检查文件是否已存在,以决定是否需要先写入表头行
    file_exists = os.path.exists(file_path) and os.path.getsize(file_path) > 0

    # 核心参数:mode='a' 追加模式, newline='' 防多余空行, encoding='utf-8-sig' 防Excel中文乱码
    with open(file_path, mode='a', newline='', encoding='utf-8-sig') as f:
        writer = csv.DictWriter(f, fieldnames=fieldnames)

        # 仅在文件不存在或为空时写入一次表头
        if not file_exists:
            writer.writeheader()

        # 批量写入本批次记录
        writer.writerows(data_list)

# 模拟爬虫分页抓取调用
if __name__ == "__main__":
    page_1 = [
        {"id": 1001, "title": "无线机械键盘", "price": 299.00, "sales": 1520},
        {"id": 1002, "title": "人体工学鼠标", "price": 149.50, "sales": 3410}
    ]
    page_2 = [
        {"id": 1003, "title": "4K显示器支架", "price": 188.00, "sales": 890}
    ]

    save_to_csv(page_1)
    save_to_csv(page_2)
    print("CSV数据追加写入完成!")
三、Excel方案:业务交付、多工作表与结构化排版
当爬取结果需要直接面向非技术部门交付时,Excel格式(.xlsx)能够提供多工作表(Sheet)划分、自动列宽、数字格式化和条件高亮等功能。在Python生态中,最常用的操作库是pandas和openpyxl。
1. 为什么不能像CSV那样简单地“追加写入”?
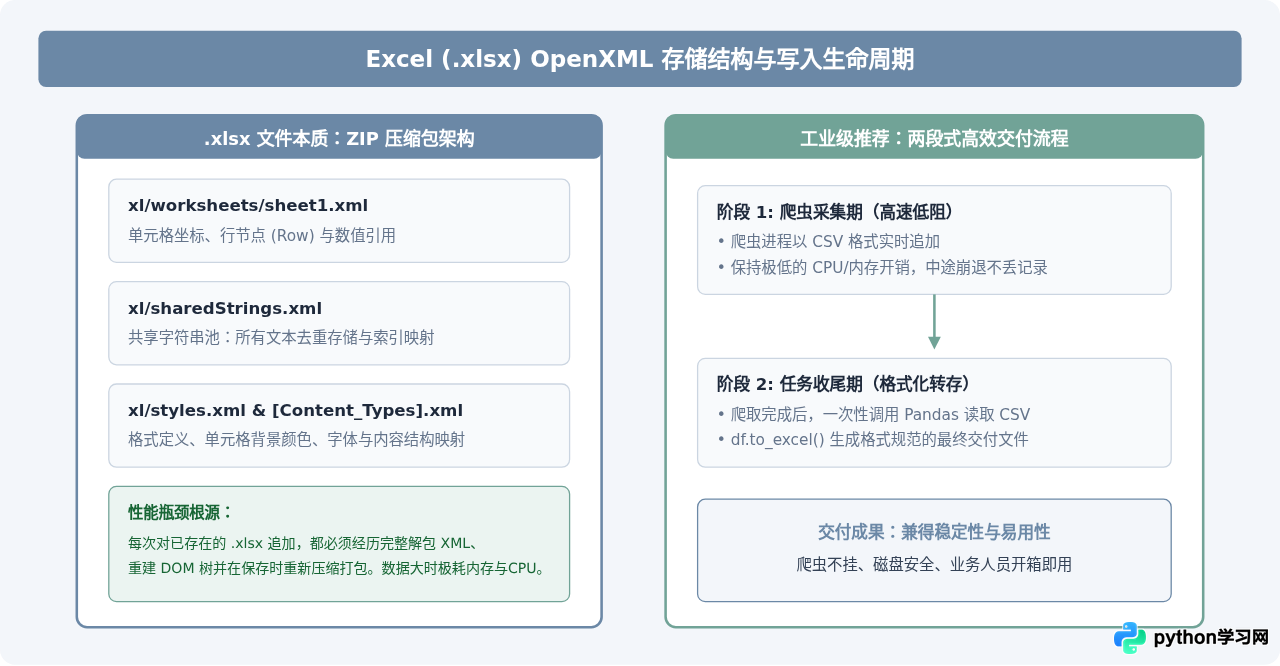
这是Excel在爬虫存储中最容易让人碰壁的地方:.xlsx本质上不是纯文本,而是一个遵循OpenXML标准的ZIP压缩包,内部包含多个XML描述文件(工作表数据、样式表、字符串共享池等)。
因此,如果你用普通的写入模式去追加一个.xlsx,不仅无法插入新行,还会彻底破坏整个压缩包结构。想要在已有Excel文件中追加内容,程序必须:先将原有文件完整解压并读入内存,将新行注入对应的Sheet对象,最后重新整体打包压缩写回磁盘。当数据量上升到万级以上时,每次追加都要经历“读入-解压-重绘-压缩-覆盖”,性能急剧下降。
2. 高效的Excel落地策略
针对Excel的底层特性,爬虫采用Excel落地的推荐策略有两种:
- 爬虫阶段先写CSV,全部抓取完成后转换为Excel: 在爬取过程中保持最高写入效率与容灾能力,最后用
pandas.read_csv()一次性导出带格式的.xlsx。 - 直接使用openpyxl进行分批流式追加: 借助
openpyxl.load_workbook()加载工作簿,调用sheet.append()添加记录,并在适当时机保存。
import os
import openpyxl
from openpyxl.styles import Font, PatternFill, Alignment

def save_to_excel_workbook(data_list, file_path="crawled_analysis.xlsx", sheet_name="爬虫结果"):
    """
    使用openpyxl向Excel中追加数据,并保持表头格式美化
    """
    if not data_list:
        return

    # 若文件不存在则新建,若存在则直接载入
    if not os.path.exists(file_path):
        wb = openpyxl.Workbook()
        ws = wb.active
        ws.title = sheet_name

        # 写入表头
        headers = list(data_list[0].keys())
        ws.append(headers)

        # 美化表头样式(背景色、白字、加粗、居中)
        header_font = Font(name="微软雅黑", size=11, bold=True, color="FFFFFF")
        header_fill = PatternFill(start_color="6B88A6", end_color="6B88A6", fill_type="solid")
        alignment = Alignment(horizontal="center", vertical="center")

        for col_idx in range(1, len(headers) + 1):
            cell = ws.cell(row=1, column=col_idx)
            cell.font = header_font
            cell.fill = header_fill
            cell.alignment = alignment
    else:
        wb = openpyxl.load_workbook(file_path)
        if sheet_name in wb.sheetnames:
            ws = wb[sheet_name]
        else:
            ws = wb.create_sheet(title=sheet_name)
            headers = list(data_list[0].keys())
            ws.append(headers)

    # 循环追加当前批次的数据行
    for item in data_list:
        row_values = list(item.values())
        ws.append(row_values)

    # 保存工作簿
    wb.save(file_path)

if __name__ == "__main__":
    records = [
        {"文章ID": "A101", "标题": "Python高并发爬虫实战", "阅读量": 12800, "状态": "已发布"},
        {"文章ID": "A102", "标题": "MySQL存储引擎深度解析", "阅读量": 9400, "状态": "已发布"}
    ]
    save_to_excel_workbook(records)
    print("Excel工作簿写入与美化完成!")
四、MySQL方案:海量数据、事务并发与自动去重
当爬虫面对百万级互联网数据、多进程分布式并发抓取,或者需要保证全网URL只被抓取一次(去重)时,文件存储便难以为继。关系型数据库MySQL提供了完整的ACID事务、主键索引约束与连接池机制,是工业级爬虫管道的基石。
1. 表结构设计与去重核心机制
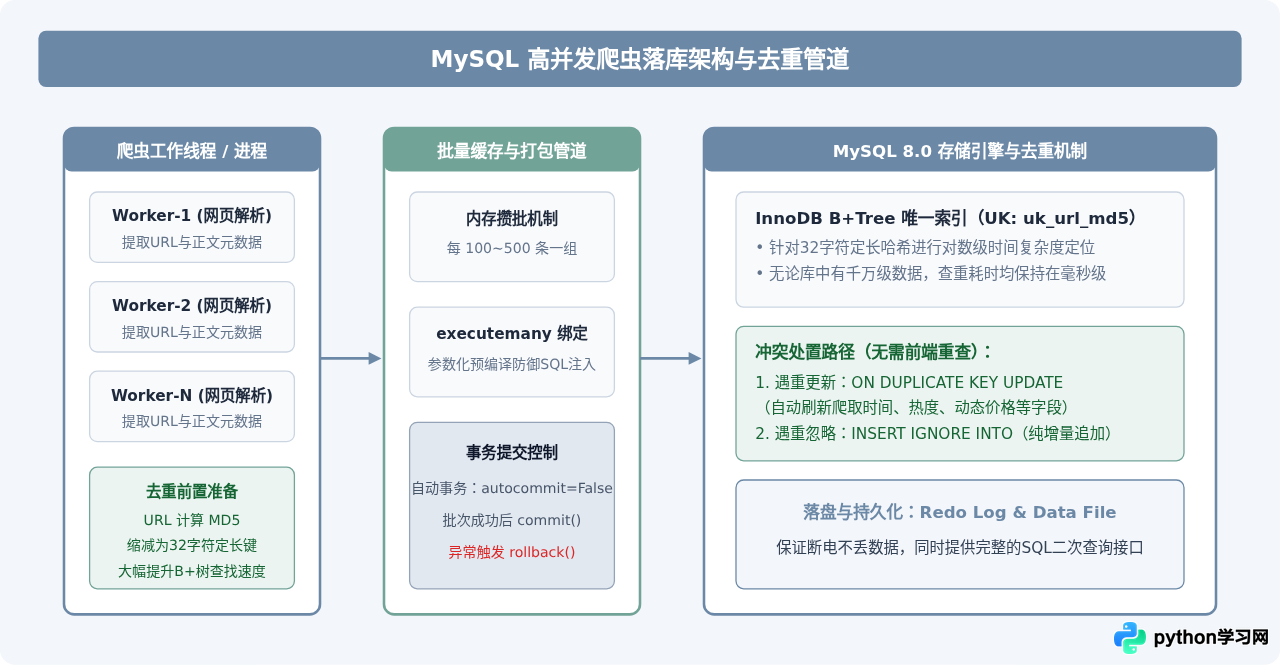
爬虫存储到MySQL中最关键的设计是基于唯一索引(Unique Key)的幂等写入。网页的URL往往很长(可能超过几百字符),如果直接对长文本URL建唯一索引会严重浪费索引空间且影响写入性能。标准做法是:提取URL计算MD5散列值(固定32位字符),在数据库中将该MD5字段设为UNIQUE KEY。
在插入数据时,利用MySQL的原生语法避免因重复记录导致插入报错崩溃:
INSERT IGNORE INTO ...:如果主键或唯一索引已存在,则静默忽略当前插入,不报主键冲突异常,非常适合“抓过就跳过”的冷数据场景。ON DUPLICATE KEY UPDATE ...:如果唯一键已存在,则触发对应字段的更新(如更新抓取时间、最新价格或状态),非常适合增量监控型爬虫。
2. 完整建表与高效批量写入代码
首先在MySQL中执行建表语句:
CREATE DATABASE IF NOT EXISTS spider_db DEFAULT CHARACTER SET utf8mb4 COLLATE utf8mb4_unicode_ci;
USE spider_db;

CREATE TABLE IF NOT EXISTS articles (
    id BIGINT AUTO_INCREMENT PRIMARY KEY,
    url_md5 CHAR(32) NOT NULL COMMENT '文章URL的MD5哈希,用于唯一去重',
    title VARCHAR(255) NOT NULL COMMENT '文章标题',
    author VARCHAR(64) DEFAULT '' COMMENT '作者',
    source_url VARCHAR(1024) NOT NULL COMMENT '原网页完整URL',
    crawl_time DATETIME NOT NULL COMMENT '采集时间',
    UNIQUE KEY uk_url_md5 (url_md5)
) ENGINE=InnoDB DEFAULT CHARSET=utf8mb4 COMMENT='爬虫采集文章表';
接下来使用Python官方推荐的纯Python驱动pymysql实现高吞吐入库。注意:绝不能在循环中每次execute()单条SQL,必须使用cursor.executemany()进行批量提交:
import hashlib
from datetime import datetime
import pymysql

def get_md5(text: str) -> str:
    """计算字符串的MD5哈希值"""
    return hashlib.md5(text.encode('utf-8')).hexdigest()

def batch_save_to_mysql(items):
    """
    批量将采集数据写入MySQL,利用唯一键自动去重
    :param items: list of dict
    """
    if not items:
        return

    # 建立数据库连接(生产环境中建议使用 DBUtils 等连接池)
    connection = pymysql.connect(
        host='localhost',
        user='root',
        password='YourSecurePassword',
        database='spider_db',
        charset='utf8mb4',
        autocommit=False  # 手动管理事务,批量commit
    )

    # 准备参数化SQL语句:利用 ON DUPLICATE KEY UPDATE 实现去重更新
    sql = """
    INSERT INTO articles (url_md5, title, author, source_url, crawl_time)
    VALUES (%s, %s, %s, %s, %s)
    ON DUPLICATE KEY UPDATE
        title = VALUES(title),
        crawl_time = VALUES(crawl_time);
    """

    # 组装元组参数列表
    params = []
    now_str = datetime.now().strftime('%Y-%m-%d %H:%M:%S')
    for item in items:
        url_md5 = get_md5(item['source_url'])
        params.append((
            url_md5,
            item['title'],
            item.get('author', '未知'),
            item['source_url'],
            now_str
        ))

    try:
        with connection.cursor() as cursor:
            # 批量执行参数化SQL
            affected_rows = cursor.executemany(sql, params)
        # 批量提交事务
        connection.commit()
        print(f"成功批量落库,受影响行数: {affected_rows}")
    except Exception as e:
        connection.rollback()
        print(f"入库异常,已回滚事务: {e}")
        raise
    finally:
        connection.close()

if __name__ == "__main__":
    crawled_batch = [
        {
            "title": "深入理解Python内存管理机制",
            "author": "张三",
            "source_url": "https://example.com/posts/python-memory-101"
        },
        {
            "title": "分布式爬虫架构设计",
            "author": "李四",
            "source_url": "https://example.com/posts/distributed-crawler-202"
        }
    ]
    batch_save_to_mysql(crawled_batch)
f"INSERT INTO ... '{val}'")拼接参数,这会导致严重的SQL注入风险以及特殊符号(如单引号、反斜杠)导致执行崩溃。必须统一使用 cursor.executemany(sql, params) 的参数化绑定方式。
五、方案综合对比与终极选型总结
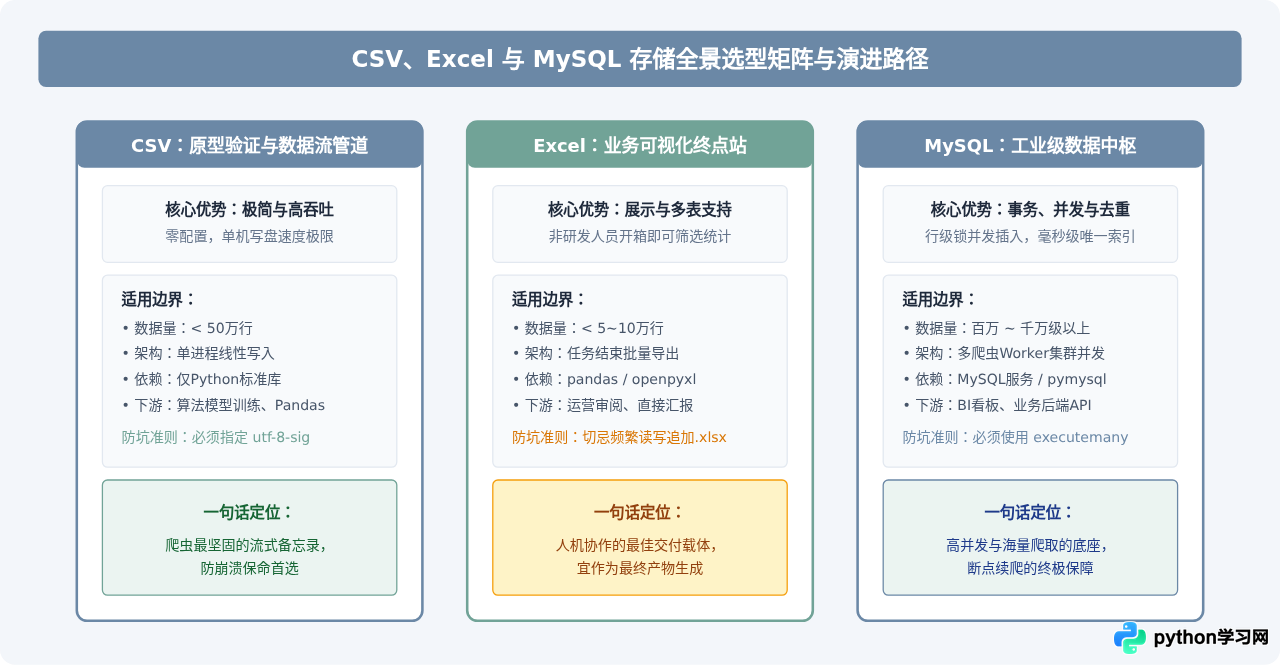
为了帮助开发者根据自身爬虫任务的实际场景做出合理决策,我们将三种存储方案的核心维度汇总如下:
| 对比维度 | CSV 纯文本方案 | Excel (.xlsx) 方案 | MySQL 数据库方案 |
|---|---|---|---|
| 数据规模承载 | 数十万行以内(受单机文本读写限制) | 建议10万行以内(单Sheet上限1,048,576行) | 千万级及以上(支持分区表与分布式集群) |
| 写入资源开销 | 极低(流式追加,内存占用几乎为零) | 较高(每次打开需解析XML DOM,万级以上耗内存) | 中等(依赖网络连接,需批量攒批降低网络往返) |
| 并发写入支持 | 不支持(多线程同时打开写入会导致乱序冲突) | 不支持(文件锁限制,并发修改必损坏结构) | 极好(行级锁机制,支持数十上百线程高并发入库) |
| 自带去重能力 | 无(需内存维护全局set,重启即失效) | 无(需要全表读入比对,开销巨大) | 原生具备(主键与唯一索引,毫秒级原子去重) |
| 下游交互便利性 | 通用格式,各种语言与数据处理库原生兼容 | 业务友好度最高,原生支持图表、多表与颜色样式 | 适合开发者、数据工程师使用SQL进行复杂深度分析 |
| 核心适用场景 | 单机爬虫、轻量级抓取、流式中间结果暂存 | 周报统计、向非技术人员一次性交付分析数据 | 分布式爬虫、企业级数据仓库、持续增量监控 |
六、结语与最佳实践建议
在实际的爬虫工程架构中,这三种存储方案并非互斥,而是经常协同工作。一个稳定健壮的爬虫系统通常遵循以下最佳实践法则:
- 爬虫抓取层严禁直写复杂富文本格式: 抓取线程应当以最快、最低资源占用的方式落盘(如先追加到CSV或写入本地SQLite/MySQL暂存表),降低由于格式转换异常引发爬虫中断的风险。
- 海量抓取务必通过唯一哈希拦截重复: 使用URL的MD5值配合数据库的
UNIQUE KEY,可以在无需预先进行SELECT查询的前提下,直接依赖存储引擎底层B+树索引完成原子去重。 - 善用分层交付: 爬虫专注于把原始数据精准入库(MySQL),后续通过定时脚本从数据库中拉取汇总数据并格式化输出给业务部门(Excel),形成清晰稳定的技术与业务解耦架构。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









