

Python生成指定范围随机整数:random.randint与randrange用法区别

random 模块中,randint(a, b) 生成的是包含两端点在内的全闭区间 [a, b] 随机整数;而 randrange(start, stop[, step]) 生成的是左闭右开区间 [start, stop) 随机整数,并且支持指定步长 step。在底层源码中,randint(a, b) 本质上就是 randrange(a, b + 1) 的快捷包装。
一、为什么需要区分 randint 与 randrange
在编写 Python 程序时,生成随机整数是非常高频的操作,比如模拟掷骰子、打乱抽奖、从列表随机截取索引或按间隔抽取采样点。Python 标准库的 random 模块提供了两个专门生成随机整数的函数:random.randint() 和 random.randrange()。
很多初学者甚至有经验的开发者常常对它们产生混淆,最常见的问题是:明明指定了范围上限,为什么有时会取到上限值,有时却永远取不到?如果需要生成特定步长(例如“1 到 100 之间的随机奇数”),又该选用哪一个?弄清楚这两个函数的参数规则、边界行为与底层联系,能够彻底避免开发中难以察觉的“差一错误”(Off-by-one Error)。
二、核心区别一:区间开闭特性对比
两者的首要区别,在于生成的随机整数集合是否包含右端点边界。
1. random.randint(a, b):双端闭区间 [a, b]
randint(a, b) 返回一个随机整数 N,满足数学上的双闭区间条件:a <= N <= b。这意味着参数中的 a 和 b 都有可能被随机选中。
import random

# 生成 1 到 6 之间的随机整数(模拟掷骰子),1 和 6 都有概率出现
dice = random.randint(1, 6)
print(f"骰子点数: {dice}")  # 可能的值为:1, 2, 3, 4, 5, 6
2. random.randrange(start, stop[, step]):左闭右开区间 [start, stop)
randrange() 的命名与行为与 Python 内置的 range() 序列完全一致,遵循左闭右开规范。它返回的随机整数 N 满足:start <= N < stop。右端点 stop 永远不会被包含在结果中。
import random

# 范围为 [1, 6),生成的随机数只可能包含 1, 2, 3, 4, 5,绝对不会出现 6
val = random.randrange(1, 6)
print(f"随机值: {val}")  # 结果集为 {1, 2, 3, 4, 5}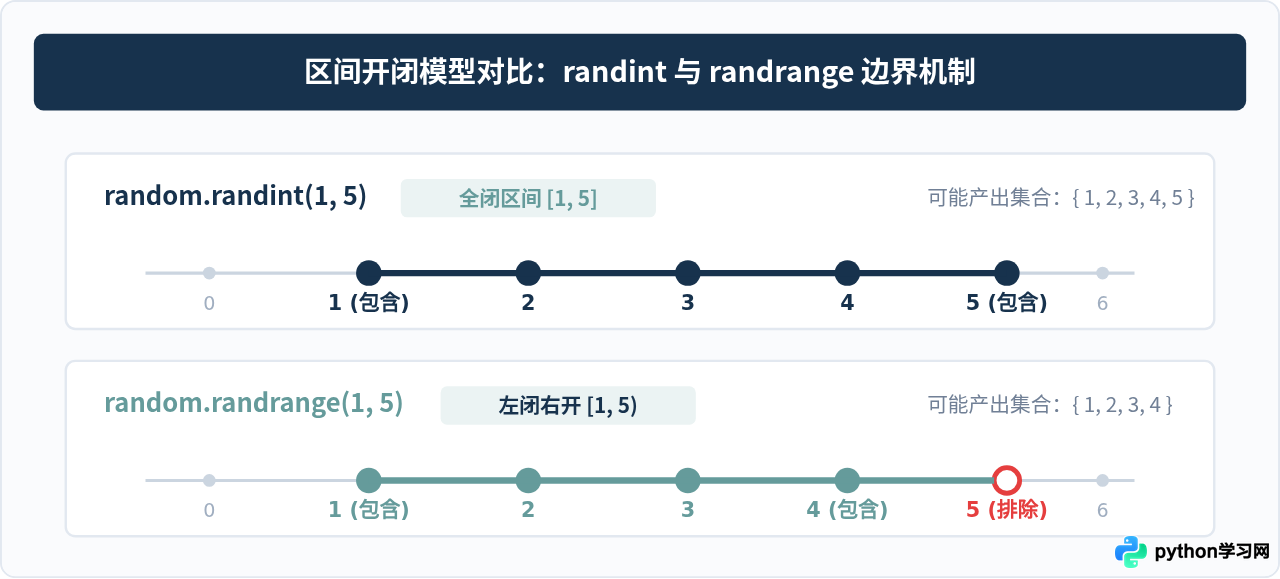
三、核心区别二:底层实现与调用机制
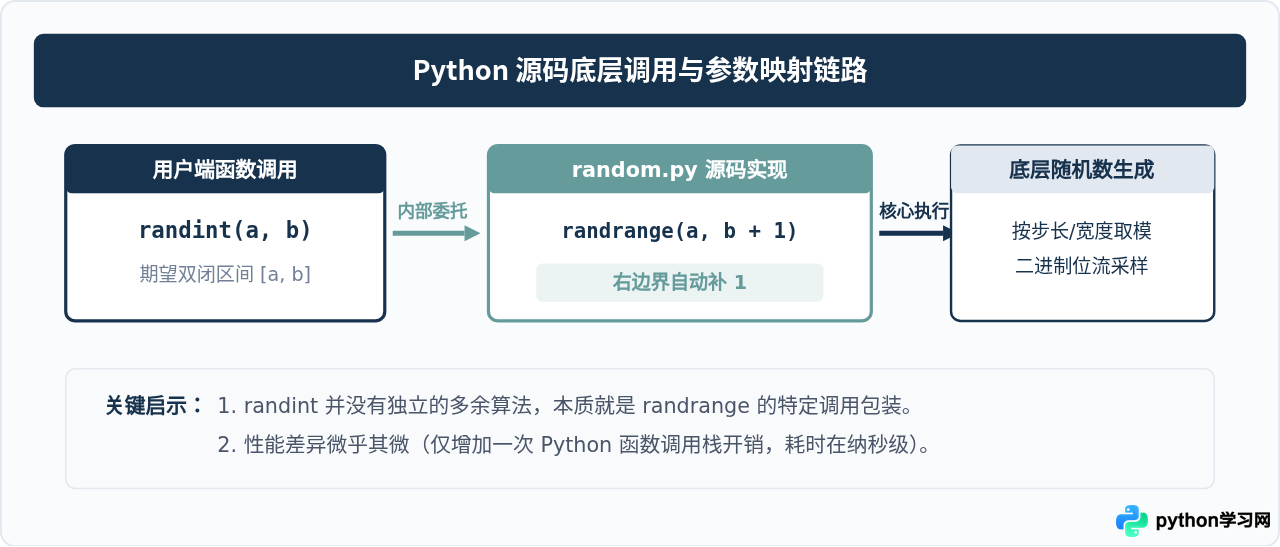
很多人以为 randint 和 randrange 是两个完全平行的算法实现,但翻阅 Python 官方标准库 random.py 的源码就会发现,它们其实是直接的包装与委托关系。
在 Python 源码中,randint 的实现只有两行核心逻辑:
def randint(self, a, b):
    """Return random integer in range [a, b], including both end points."""
    return self.randrange(a, b + 1)
这段代码揭示了几个关键事实:
- 同根同源:
randint内部就是通过调用randrange完成计算的,随机数的分布质量、底层伪随机算法(Mersenne Twister)完全没有差别。 - 边界转换:
randint(a, b)只是将右边界自动累加了 1,使其以randrange(a, b + 1)的形式运行,从而恰好把b纳入了可取值的集合中。 - 设计初衷:Python 之所以单独提供
randint,是为了迎合人们日常的数学直觉(比如日常生活中的“请在 1 到 10 之间选一个数字”,直觉上都是包含 10 的),减少频繁手写+ 1的繁琐与疏漏。
四、核心区别三:步长支持与调用签名
除了区间开闭差异外,两者的参数灵活性存在显著不同。
1. 参数数量差异:单参数与多参数
randint(a, b) 必须且只能接收两个位置参数 a 与 b。如果只传一个参数,会直接抛出 TypeError: randint() missing 1 required positional argument 异常。
与此相对,randrange() 支持三种重载传参形式,完全贴合 range():
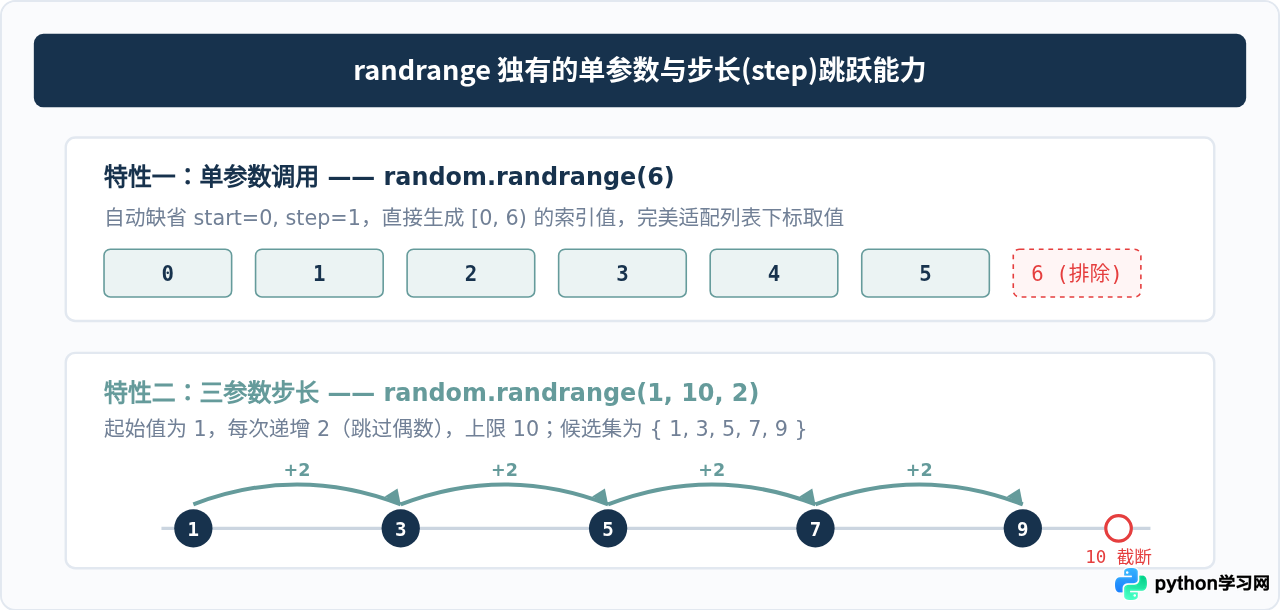
randrange(stop):只传入一个参数时,默认从0开始,步长为1。例如randrange(5)生成0, 1, 2, 3, 4。这在配合列表下标时非常便捷。randrange(start, stop):指定起始与终止端点,步长默认为1。randrange(start, stop, step):指定起始端点、终止端点以及递进步长。
2. 步长(step)机制实战
当需要生成特定间隔的随机整数时,randint 无法直接胜任,而 randrange 的 step 参数则能够原生支持:
import random

# 生成 0 到 100 之间的随机偶数(包含 0,不含 100)
even_num = random.randrange(0, 100, 2)

# 生成 1 到 100 之间的随机奇数(包含 1,不含 101)
odd_num = random.randrange(1, 101, 2)

# 生成 0 到 50 之间 5 的倍数
five_multiple = random.randrange(0, 55, 5)  # 可能取到 0, 5, 10, ..., 50
若使用 randint 实现上述需求,开发者必须先生成连续序号,再手动乘以步长或加上偏移量,例如 random.randint(0, 49) * 2,代码的可读性和维护性明显劣于 randrange。
五、常见错误与避坑指南
在实际编码中,由于对参数约束和异常机制不了解,开发者经常会遭遇以下两类典型异常:
1. 空范围引发的 ValueError
对于 randint(a, b),要求 a <= b。如果传入 a > b,例如 random.randint(10, 1),在底层执行 randrange(10, 2) 时会直接抛出:
ValueError: empty range for randrange() (10, 2, -8)对于 randrange(start, stop, step),如果步长方向与端点方向相反(例如 randrange(1, 10, -1) 或 randrange(10, 1, 1)),或者范围跨度无法产生任何有效整数,同样会抛出 ValueError: empty range for randrange()。
2. 步长为 0 引发的 ValueError
步长参数必须是非零整数。如果传入 random.randrange(1, 10, 0),系统会立即抛出 ValueError: zero step for randrange(),这与 Python 内置 range(1, 10, 0) 的报错规则保持高度一致。
__index__ 方法的整数对象)。如果误传浮点数,如 randint(1.5, 6.5),Python 3 会直接抛出 ValueError: non-integer arg 1 for randrange(),不会自动四舍五入。如果需要生成随机浮点数,请使用 random.uniform(a, b)。
六、特性对比与技术选型指南
为了在开发中迅速做出恰当的选择,我们可以将两者的核心指标整理成对比清单:
| 特性指标 | random.randint(a, b) | random.randrange(start, stop[, step]) |
|---|---|---|
| 区间类型 | 全闭区间 [a, b],包含两端端点 | 左闭右开区间 [start, stop),不包含 stop |
| 必需参数 | 必须传两个参数 (a, b) | 至少传一个参数 (stop) |
| 步长支持 | 不支持 step 参数 | 原生支持可选的 step 参数 |
| 对标模型 | 符合现实生活与数学闭区间直觉 | 与 Python 内置 range() 和切片规则完全一致 |
| 典型场景 | 模拟骰子(1~6)、自然数随机抽选、明确全闭范围 | 随机索引下标(len)、奇偶数跳跃、序列步长采样 |
七、总结
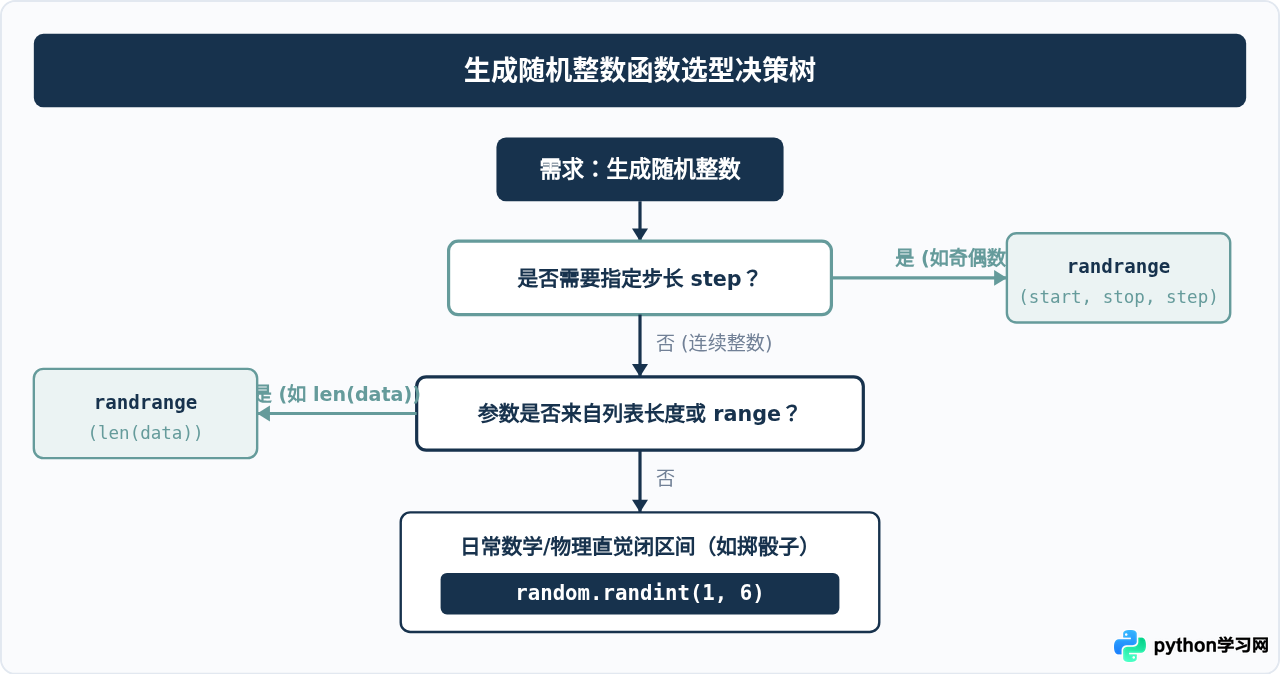
总结来说,random.randint 与 random.randrange 的选用原则可以归纳为两点:
- 看区间直觉:如果需求是明确的“包含上下限”的日常数值(如掷骰子取 1~6、答题抽签 1~50 号),优先选用
randint(a, b),它符合自然认知,避免手动加减 1 带来的心智负担。 - 看代码语境与步长:如果操作对象涉及数组索引、切片、循环次数,或者需要按步长跳跃(如奇偶数),优先选用
randrange(),它与 Python 核心生态的range和索引机制无缝统一。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









