

Python Django开发题库系统:从数据库设计到随机组卷实现
深入讲解如何使用 Python Django 从零构建健壮的题库系统,涵盖题库与试卷数据模型设计、避免全表扫描的高效随机组卷算法、事务持久化及生产落地注意事项。
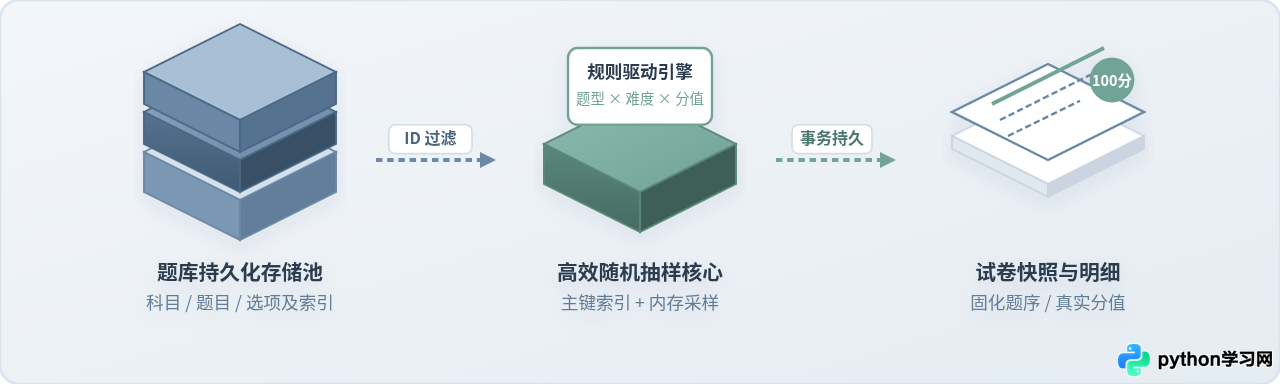
开发一套实用的在线题库系统,核心在于两个关键环节的协同:一是构建规范且具备扩展能力的数据库模型,准确沉淀学科、题型、难度及选项数据;二是实现一套性能稳定、分布均匀且能够抵御高并发的随机组卷算法。很多初次接触题库开发的开发者,往往直接使用 Django ORM 的 order_by('?') 进行随机排序,在题库规模扩大后引发严重的全表扫描与数据库宕机。本文将从规范的 Django 模型设计出发,拆解随机组卷的约束矩阵与流程,并给出基于主键覆盖索引与 Python 内存抽样的高性能实现方案。
一、题库系统核心数据模型设计
题库系统的数据模型设计必须兼顾灵活性与历史可追溯性。在实际业务中,题目通常分为单选题、多选题、判断题、填空题和问答题;同时,试卷一旦生成并投入考试,其所包含的题目及每道题的分值就必须永久固定(即使题库中原题被教师修改或软删除,历史试卷的成绩计算与试卷回顾也不受影响)。
因此,我们将系统实体划分为三个清晰层次:
- 基础层(Subject / Category):管理学科、年级与知识点树形分类,作为题目检索的顶层维度。
- 题库层(Question / QuestionOption):题目主表记录题干、题型、难度与通用解析,选项表通过外键挂载于题目下方,支持单选与多选。
- 试卷层(PaperRule / Paper / PaperQuestion):组卷规则保存配置矩阵;试卷主表记录卷面元数据;试卷明细关联表(
PaperQuestion)作为关键的中间实体,持久化题目在试卷中的物理序号、快照分值。
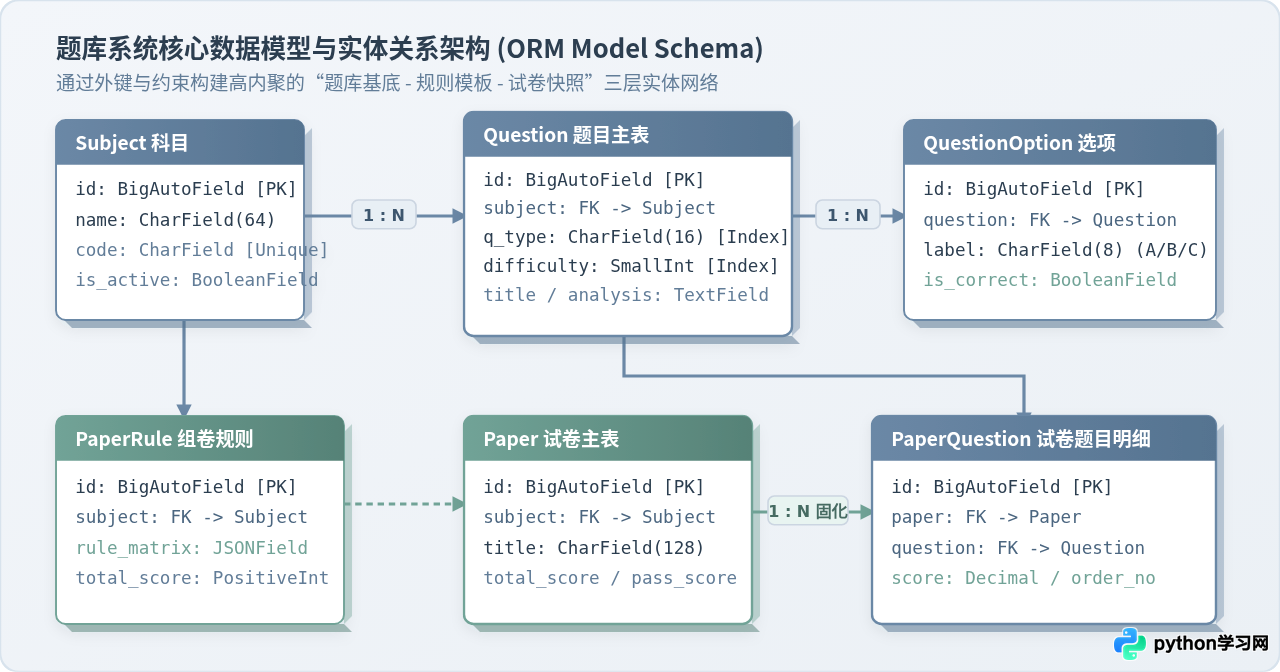
在 Django 的 models.py 中,我们通过模型类将上述结构固化。注意为查询过滤高频使用的 q_type、difficulty 与 is_active 建立联合索引(db_index),以保证后续组卷筛选能够直接命中索引。
from django.db import models
from django.core.validators import MinValueValidator, MaxValueValidator


class Subject(models.Model):
    """学科与分类模型"""
    name = models.CharField(max_length=64, verbose_name="学科名称")
    code = models.CharField(max_length=32, unique=True, verbose_name="学科代码")
    is_active = models.BooleanField(default=True, verbose_name="是否启用")

    class Meta:
        verbose_name = "学科"
        verbose_name_plural = verbose_name

    def __str__(self):
        return self.name


class QuestionType(models.TextChoices):
    SINGLE = 'SINGLE', '单选题'
    MULTI = 'MULTI', '多选题'
    JUDGE = 'JUDGE', '判断题'
    BLANK = 'BLANK', '填空题'
    ESSAY = 'ESSAY', '简答题'


class Question(models.Model):
    """题目主表"""
    subject = models.ForeignKey(Subject, on_delete=models.CASCADE, related_name='questions', verbose_name="所属学科")
    q_type = models.CharField(max_length=16, choices=QuestionType.choices, verbose_name="题型")
    difficulty = models.PositiveSmallIntegerField(
        validators=[MinValueValidator(1), MaxValueValidator(5)],
        default=3,
        verbose_name="难度等级(1简单-5困难)"
    )
    title = models.TextField(verbose_name="题干内容")
    analysis = models.TextField(blank=True, default='', verbose_name="题目解析")
    default_score = models.DecimalField(max_digits=5, decimal_places=1, default=5.0, verbose_name="默认参考分值")
    is_active = models.BooleanField(default=True, verbose_name="可用状态")
    created_at = models.DateTimeField(auto_now_add=True, verbose_name="创建时间")

    class Meta:
        verbose_name = "题目"
        verbose_name_plural = verbose_name
        indexes = [
            # 建立多字段联合索引,为组卷时的核心条件过滤提供毫秒级支撑
            models.Index(fields=['subject', 'q_type', 'difficulty', 'is_active'], name='idx_q_pool_filter'),
        ]

    def __str__(self):
        return f"[{self.get_q_type_display()}] {self.title[:30]}"


class QuestionOption(models.Model):
    """题目选项(适用于单选、多选、判断)"""
    question = models.ForeignKey(Question, on_delete=models.CASCADE, related_name='options', verbose_name="所属题目")
    label = models.CharField(max_length=8, verbose_name="选项标识(A/B/C/D)")
    content = models.TextField(verbose_name="选项文字/内容")
    is_correct = models.BooleanField(default=False, verbose_name="是否为正确答案")
    sort_order = models.PositiveSmallIntegerField(default=1, verbose_name="显示顺序")

    class Meta:
        verbose_name = "题目选项"
        verbose_name_plural = verbose_name
        ordering = ['sort_order']


class Paper(models.Model):
    """试卷主实体"""
    subject = models.ForeignKey(Subject, on_delete=models.PROTECT, related_name='papers', verbose_name="所属学科")
    title = models.CharField(max_length=128, verbose_name="试卷标题")
    total_score = models.DecimalField(max_digits=5, decimal_places=1, default=100.0, verbose_name="试卷总分")
    pass_score = models.DecimalField(max_digits=5, decimal_places=1, default=60.0, verbose_name="及格线")
    time_limit_minutes = models.PositiveIntegerField(default=90, verbose_name="考试时长(分钟)")
    created_at = models.DateTimeField(auto_now_add=True, verbose_name="组卷时间")

    class Meta:
        verbose_name = "试卷"
        verbose_name_plural = verbose_name

    def __str__(self):
        return self.title


class PaperQuestion(models.Model):
    """试卷题目明细中间表(固化题序与实际分值)"""
    paper = models.ForeignKey(Paper, on_delete=models.CASCADE, related_name='paper_questions', verbose_name="所属试卷")
    question = models.ForeignKey(Question, on_delete=models.PROTECT, related_name='paper_records', verbose_name="题目引用")
    order_no = models.PositiveIntegerField(verbose_name="卷面题号顺序")
    score = models.DecimalField(max_digits=5, decimal_places=1, verbose_name="本卷实际分值")

    class Meta:
        verbose_name = "试卷题目关联"
        verbose_name_plural = verbose_name
        unique_together = ('paper', 'question')
        ordering = ['order_no']
注意 PaperQuestion 对 Question 的级联设置使用了 models.PROTECT。这是严防生产事故的关键细节:如果某道题目已经被任何正式试卷使用,系统将禁止从题库中物理硬删除该题目,以防止历史考试试卷渲染出现空指针错误。下架题目应通过修改 is_active=False 进行软标记。
二、随机组卷的业务规则与流水线拆解
所谓“随机组卷”,并不是把题库所有题目随意乱抓,而是在满足一系列硬性约束条件的前提下进行多维度抽样。典型的组卷约束包括:
- 学科约束:所有题目必须属于同一学科或对应知识模块。
- 题型配额:例如单选 20 道、多选 10 道、判断 10 道、简答 5 道。
- 难度梯队(Difficulty Matrix):整卷难度通常要求符合正态分布或阶梯分布,如简单:中等:困难 = 3:5:2。
- 总分平衡:每种题型的分值加权求和,必须精确等于试卷总分(例如 100 分),不能多也不能少。
- 去重与唯一性:同一张试卷内,同一道题目绝不能重复出现。
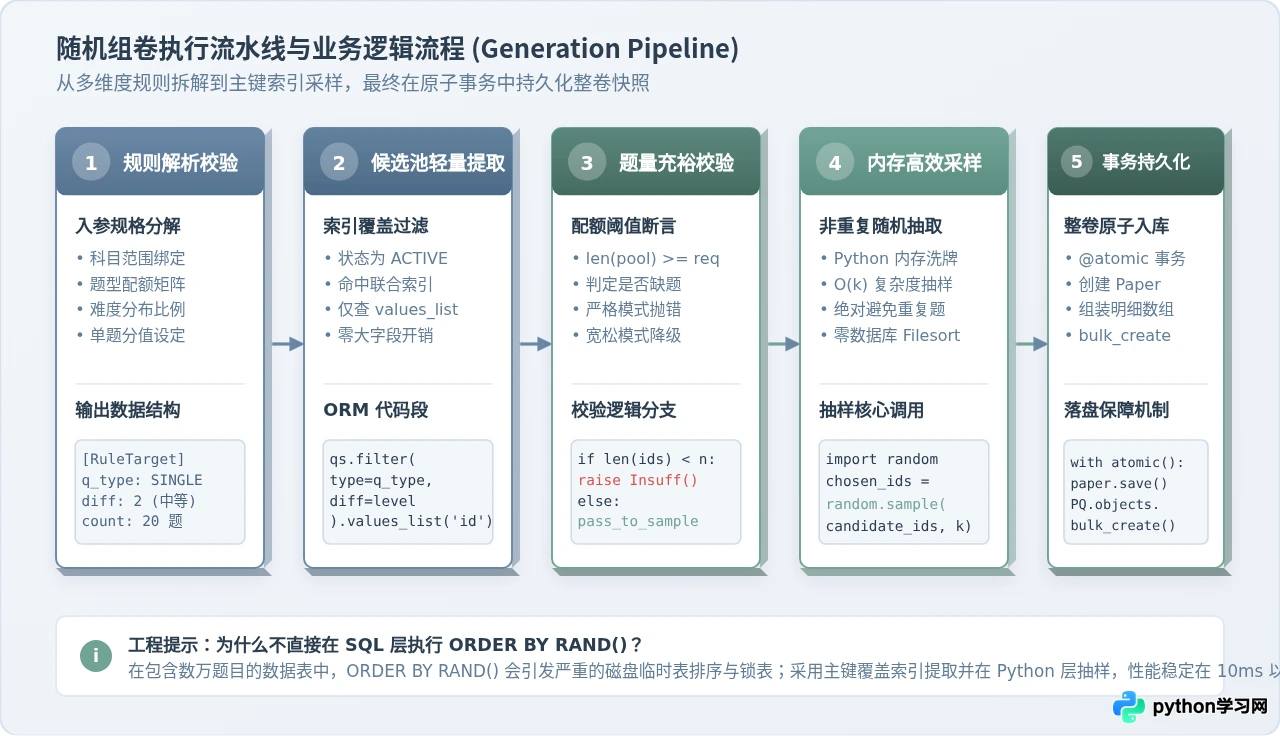
为了实现严谨的组卷链路,整个执行流水线分为 5 个标准步骤:
- 步骤 1(规则解析与校验):解析输入的组卷策略配置,检查题型总分是否等于试卷设定的总分,建立每一个子抽样单元的目标清单。
- 步骤 2(候选池筛选):利用 Django 联合索引,通过
filter(subject=..., q_type=..., difficulty=..., is_active=True)筛选符合条件的题目候选集。 - 步骤 3(充裕度断言):比对候选集大小与期望数量。如果期望抽取 20 题,但题库只有 15 题,根据配置触发告警或者平滑升降级回退。
- 步骤 4(无重复抽样):将候选主键在 Python 内存中进行采样,获取该维度的题号集合,保证同维度与跨维度无冲突。
- 步骤 5(事务入库):开启
transaction.atomic()事务,生成试卷主表记录,排定题号顺序,并通过bulk_create一次性写入关联表。
三、Django ORM 随机算法选型与性能深度分析
随机组卷中最容易产生性能灾难的地方,就是“如何在 Django 中随机获取 N 条记录”。初学者最常见的写法是:
# 错误示范:order_by('?')
random_questions = Question.objects.filter(
    subject=subject, q_type='SINGLE', difficulty=2
).order_by('?')[:20]
虽然代码只有一行,但在底层 SQL 中,它会被翻译为 SELECT * FROM question WHERE ... ORDER BY RAND() LIMIT 20;。在 MySQL 或 PostgreSQL 中,RAND() 会迫使数据库引擎为满足条件的每一行数据生成随机数,并将整行数据写入内存临时表(甚至磁盘临时表),最后调用 Filesort 执行一次全量排序。当题库数据达到数万乃至十万级别时,单次查询可能耗时数秒甚至将数据库 CPU 打满。
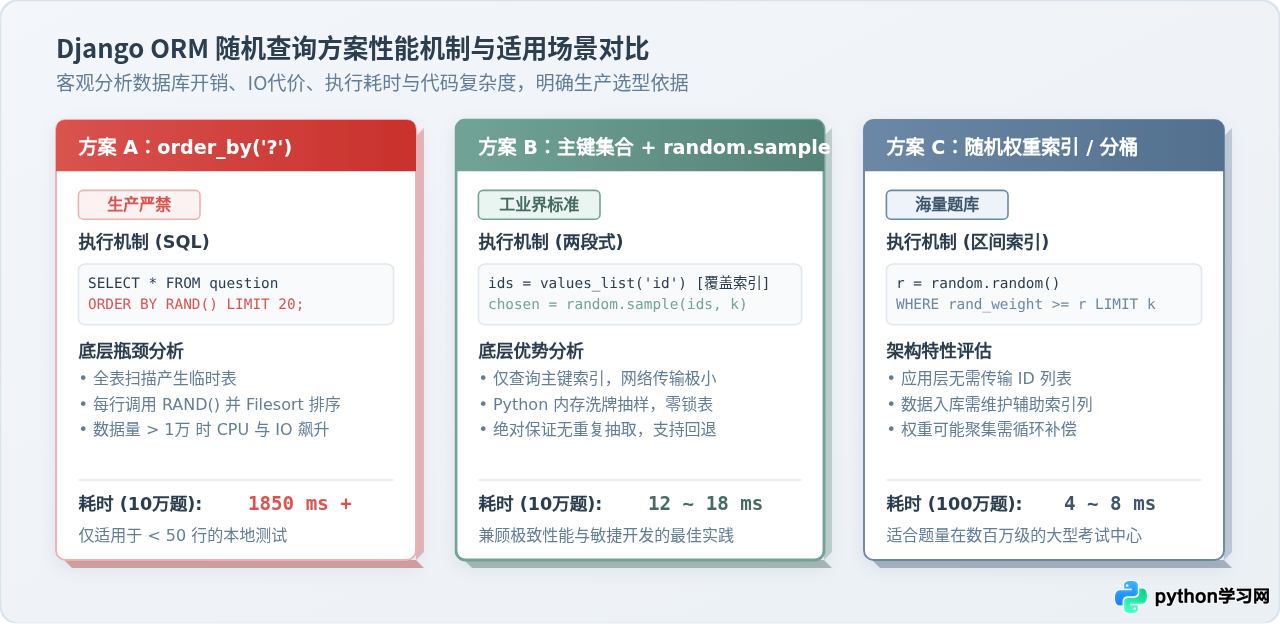
为了规避全表排序,业界成熟的解决方案是“主键索引覆盖 + 内存洗牌”。其工作原理如下:
-
使用
qs.values_list('id', flat=True)仅拉取题目主键列表。由于我们在模型中建立了联合索引,该查询仅需扫描 B-Tree 索引树,无需回表读取题干、解析等大字段内容,耗时仅需数毫秒。 -
将得到的主键列表传递给 Python 标准库的
random.sample(candidate_ids, k)。该函数基于 Fisher-Yates 算法实现,在内存中完成无放回的等概率随机抽样,时间复杂度为O(k),且绝对不产生重复项。 -
如果后续组卷流程仅需要主键关联入库,可直接使用这组采样出的 ID 构建
PaperQuestion;若需要加载题目对象,直接执行Question.objects.filter(id__in=selected_ids),精准走主键聚集索引单次批量检索。
| 对比指标 | order_by('?') 盲目随机 | 主键 values_list + random.sample (推荐) | 辅助分桶 / 权重索引 |
|---|---|---|---|
| 底层 SQL 机制 | ORDER BY RAND() 全排序 | B-Tree 覆盖索引提取 ID | 预计算浮点范围扫描 |
| 10万行数据耗时 | 1500ms ~ 2800ms (高负载) | 10ms ~ 18ms (平稳) | 3ms ~ 6ms (极快) |
| 数据库锁与资源 | 创建磁盘临时表,高 CPU | 仅读取主键索引,零临时表 | 单次范围索引查询 |
| 重复性与均匀度 | 概率均匀,但无法做业务校验 | 无放回精确抽样,防重复,便于容错 | 可能产生区间聚集,需补偿 |
| 实现与维护成本 | 极低(但生产崩溃风险极高) | 低(仅需十几行封装,无需额外表结构) | 中等(需维护索引列与更新触发器) |
四、随机组卷核心服务的完整代码实现
接下来,我们将组卷业务逻辑封装为一个专用的领域服务类 PaperGeneratorService。该服务支持结构化规则输入、题量不足检查、分值精准核算与事务级持久化。
import random
from decimal import Decimal
from typing import List, Dict, Any
from django.db import transaction
from .models import Subject, Question, QuestionType, Paper, PaperQuestion


class PaperGenerationError(Exception):
    """组卷业务异常基类"""
    pass


class InsufficientQuestionsError(PaperGenerationError):
    """题库题量不足异常"""
    pass


class PaperGeneratorService:
    """
    智能随机组卷服务
    支持题型配额、难度分布与总分平衡
    """

    def __init__(self, subject: Subject, paper_title: str, total_score: float = 100.0, time_limit: int = 90):
        self.subject = subject
        self.paper_title = paper_title
        self.total_score = Decimal(str(total_score))
        self.time_limit = time_limit
        self.rules: List[Dict[str, Any]] = []

    def add_rule(self, q_type: QuestionType, difficulty: int, count: int, score_per_question: float):
        """
        添加组卷细分规则
        :param q_type: 题型枚举
        :param difficulty: 难度等级 (1-5)
        :param count: 抽取数量
        :param score_per_question: 单题分值
        """
        if count <= 0:
            return
        self.rules.append({
            'q_type': q_type,
            'difficulty': difficulty,
            'count': count,
            'score': Decimal(str(score_per_question))
        })

    def validate_rules(self):
        """校验规则配比总分是否与试卷总分吻合"""
        calculated_total = sum(r['count'] * r['score'] for r in self.rules)
        if calculated_total != self.total_score:
            raise PaperGenerationError(
                f"组卷规则总分 ({calculated_total}) 与试卷预设总分 ({self.total_score}) 不一致,请检查配置!"
            )

    def _sample_question_ids(self, rule: Dict[str, Any], excluded_ids: set) -> List[int]:
        """
        通过主键覆盖索引提取候选集并进行内存抽样
        """
        q_type = rule['q_type']
        difficulty = rule['difficulty']
        required_count = rule['count']

        # 1. 覆盖索引快速查询所有可用题目 ID
        candidate_ids = list(
            Question.objects.filter(
                subject=self.subject,
                q_type=q_type,
                difficulty=difficulty,
                is_active=True
            ).exclude(
                id__in=excluded_ids
            ).values_list('id', flat=True)
        )

        # 2. 题量充裕度检查
        if len(candidate_ids) < required_count:
            type_name = dict(QuestionType.choices).get(q_type, q_type)
            raise InsufficientQuestionsError(
                f"题库储备不足:[{self.subject.name}] 题型={type_name} 难度={difficulty} "
                f"需要 {required_count} 题,实际仅可用 {len(candidate_ids)} 题。"
            )

        # 3. 内存高效随机抽样
        selected = random.sample(candidate_ids, required_count)
        return selected

    @transaction.atomic
    def generate(self) -> Paper:
        """
        执行组卷并持久化到数据库
        保证原子性:只要有一类题目缺失,全部事务自动回滚
        """
        self.validate_rules()

        selected_question_plan = []  # 存放 (question_id, score)
        used_ids = set()

        # 依次对每项规则进行无放回抽样
        for rule in self.rules:
            sampled_ids = self._sample_question_ids(rule, excluded_ids=used_ids)
            for q_id in sampled_ids:
                selected_question_plan.append((q_id, rule['score']))
                used_ids.add(q_id)

        # 创建试卷主表记录
        paper = Paper.objects.create(
            subject=self.subject,
            title=self.paper_title,
            total_score=self.total_score,
            pass_score=self.total_score * Decimal('0.6'),
            time_limit_minutes=self.time_limit
        )

        # 批量组装试卷题目明细
        paper_questions = [
            PaperQuestion(
                paper=paper,
                question_id=q_id,
                order_no=index + 1,
                score=score
            )
            for index, (q_id, score) in enumerate(selected_question_plan)
        ]

        # 批量高效入库,减少 SQL 交互开销
        PaperQuestion.objects.bulk_create(paper_questions)

        return paper
在 View 或 API 中的调用示例
在 Django 的视图函数或 API 接口中调用上述服务时,代码极其紧凑,且异常边界非常明确:
from django.http import JsonResponse
from django.views.decorators.http import require_POST
from .models import Subject, QuestionType
from .services import PaperGeneratorService, PaperGenerationError


@require_POST
def generate_math_exam_api(request):
    try:
        subject = Subject.objects.get(code="MATH_HIGH")

        # 初始化组卷引擎:设定 100 分满分,考试时间 120 分钟
        service = PaperGeneratorService(
            subject=subject,
            paper_title="2026学年高等数学期中摸底考试卷",
            total_score=100.0,
            time_limit=120
        )

        # 设定题型与难度矩阵:
        # 1. 单选题 (共10题,每题3分,总计30分):简单6题,中等4题
        service.add_rule(q_type=QuestionType.SINGLE, difficulty=2, count=6, score_per_question=3.0)
        service.add_rule(q_type=QuestionType.SINGLE, difficulty=3, count=4, score_per_question=3.0)

        # 2. 多选题 (共5题,每题4分,总计20分):中等3题,困难2题
        service.add_rule(q_type=QuestionType.MULTI, difficulty=3, count=3, score_per_question=4.0)
        service.add_rule(q_type=QuestionType.MULTI, difficulty=4, count=2, score_per_question=4.0)

        # 3. 判断题 (共10题,每题2分,总计20分):简单10题
        service.add_rule(q_type=QuestionType.JUDGE, difficulty=1, count=10, score_per_question=2.0)

        # 4. 简答计算题 (共3题,每题10分,总计30分):中等2题,困难1题
        service.add_rule(q_type=QuestionType.ESSAY, difficulty=3, count=2, score_per_question=10.0)
        service.add_rule(q_type=QuestionType.ESSAY, difficulty=5, count=1, score_per_question=10.0)

        # 执行事务组卷
        paper = service.generate()

        return JsonResponse({
            "code": 200,
            "message": "组卷成功",
            "data": {
                "paper_id": paper.id,
                "title": paper.title,
                "total_score": float(paper.total_score),
                "question_count": paper.paper_questions.count()
            }
        })

    except Subject.DoesNotExist:
        return JsonResponse({"code": 404, "message": "指定学科不存在"}, status=404)
    except PaperGenerationError as e:
        return JsonResponse({"code": 400, "message": str(e)}, status=400)
    except Exception as e:
        return JsonResponse({"code": 500, "message": f"系统内部异常: {str(e)}"}, status=500)
五、生产落地与架构全景总结
完成核心代码编写后,在实际高并发线上环境中,仍有四项关键的工程细节需要关注:
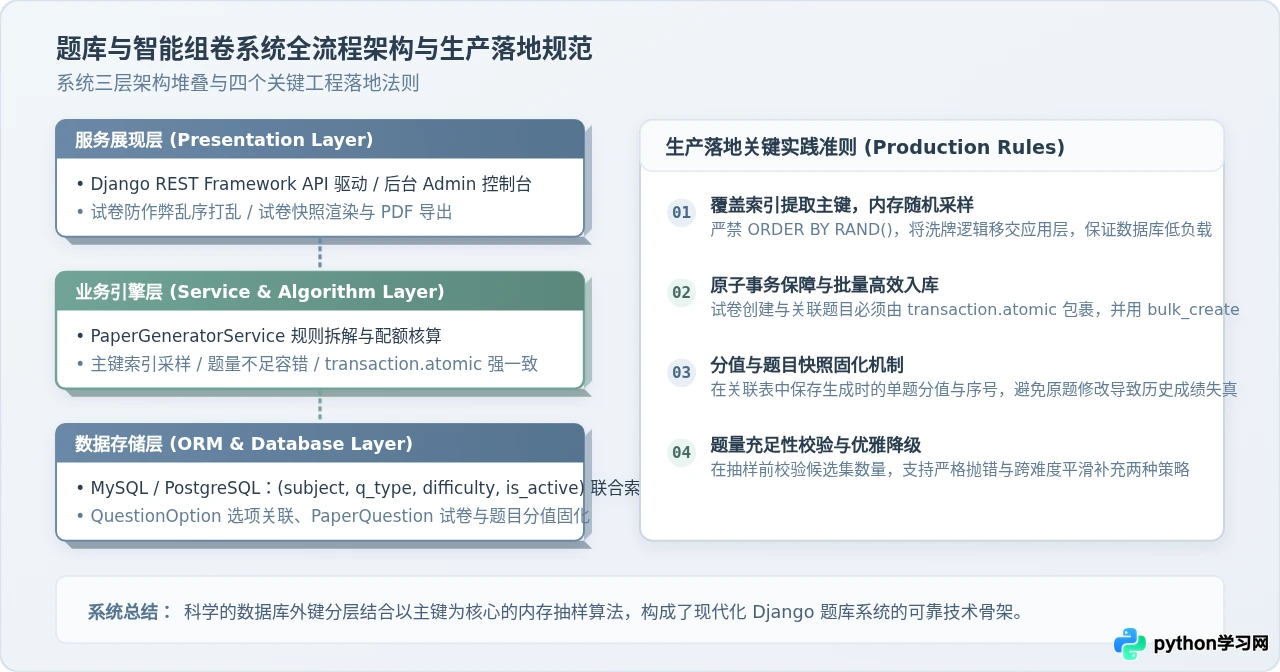
-
试卷数据快照固化:
为什么必须设计
PaperQuestion明细表?因为题库不是静态的,后续维护者随时可能修复某道题的错别字、更改选项甚至调整参考分值。如果试卷仅保存一个题目外键的多对多关联,一旦原题数据被修改,所有历史考生的试卷内容与得分记录都将发生错乱。在PaperQuestion中固化生成时刻的分值、题序,必要时甚至可以冗余题干快照,是题库系统合规性与可追溯性的基石。 -
高并发防作弊乱序(AB 卷):
在学生端进入考场拉取试卷时,可以直接依据考生 ID 或考试座位号作为随机种子,对当前试卷中的单选题选项顺序进行动态置换(例如通过将
options顺序洗牌存储在 Redis 考生会话中),做到“同卷不同序”,低成本实现强防作弊能力。 -
批量题目加载优化(避免 N+1 查询):
前端展示整张试卷时,切勿通过循环
paper_question.question.options.all()逐一取数。应当充分运用 Django ORM 的prefetch_related:试卷视图渲染优化 ORM prefetch# 预加载题目及选项,将数据库查询次数压缩至 2 次 paper = Paper.objects.prefetch_related( 'paper_questions__question__options' ).get(id=paper_id) -
题库动态变更下的规则回退:
针对题量可能不足的冷门科目,可以在
PaperGeneratorService中扩展“弹性降级策略”:当指定难度的题目不足时,允许算法自动向相邻难度(如难度 3 不足时向上借用难度 4 或向下借用难度 2)平滑借调补充,并在生成日志中记录降级警告,避免直接向用户抛出异常中断考试流程。
Python Django 开发题库系统的关键在于“明晰的实体职责划分”与“轻量级主键随机算法”:通过数据模型将题库与试卷快照解耦,避免外键硬删除破坏历史数据;通过 values_list('id') 配合 random.sample 彻底摆脱 order_by('?') 的性能泥潭,最后以 transaction.atomic 与 bulk_create 完成原子持久化。这一套组合拳既保证了敏捷开发效率,也为系统日后平滑支撑百万级题库打下了坚实的架构基础。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









