

Python多线程爬虫与异步asyncio爬虫该怎么选

深入对比Python多线程爬虫与基于asyncio的异步爬虫在执行机制、内存开销、编码难度及并发性能上的本质区别,提供明确的选型决策依据、完整代码示例与工程重构建议。
如果你需要在几个小时内抓取几千到两三万个常规页面,且不想重写既有的同步清洗脚本,优先选择多线程配合线程池;如果你面对的是十万级以上的高并发请求、网络等待耗时长、或者需要把单台机器的吞吐量压榨到极限,那么直接选用基于 asyncio 与 aiohttp 的异步爬虫是毫无争议的更优解。
不少写爬虫的工程师都会经历一个典型阶段:用 requests 串行爬取发现太慢,便套上一层 ThreadPoolExecutor,速度瞬间提升了五六倍。然而当任务规模从数千上升到数十万,试图把线程数调到 200 或 500 时,程序往往会出现内存占用剧增、CPU 频繁在上下文切换中空耗、频繁报错卡死等状况。这时大家自然会把目光投向 asyncio。但异步编程陡峭的语法改造成本和生态割裂,又常常让人望而却步。搞清楚它们背后的运行模型与瓶颈边界,才能根据任务特征快速作出正确的技术选型。
一、底层机制:多线程阻塞调度 vs 事件循环协作
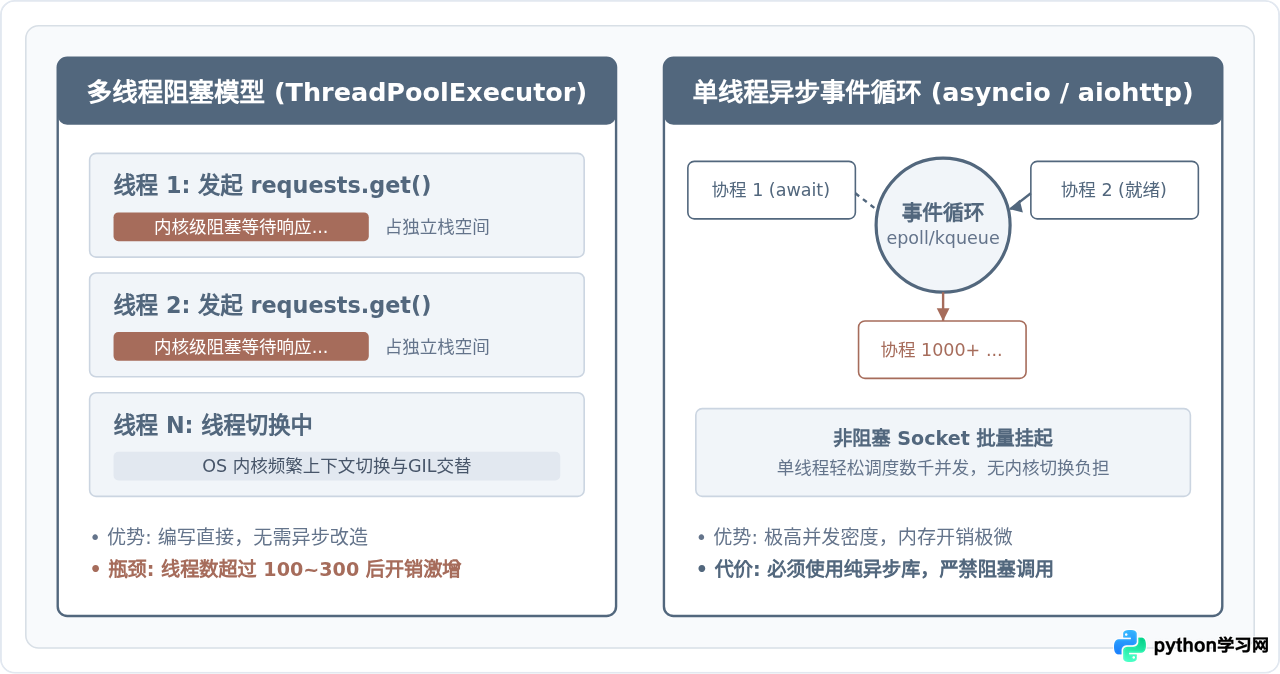
在网络爬虫中,任务的大部分时间都在“等待”:等待建立 TCP 连接、等待服务器处理请求并返回 HTML。这种等待属于典型的网络 I/O 密集型工作。多线程与异步协程在操作系统和解释器层面处理这种等待的方式有着根本不同。
在 Python 的多线程模型中,每个线程由操作系统内核进行调度管理。尽管 Python 存在全局解释器锁(GIL),但在发起系统调用执行 socket 读取等 I/O 操作时,Python 会主动释放 GIL,允许其它线程继续运行。不过,操作系统为每个线程分配了独立的栈空间(通常为几百 KB 到数兆字节)。当并发线程数达到上百个时,系统内核在众多线程之间做频繁的上下文切换(保存寄存器状态、恢复上下文),会造成显著的性能损耗。
相比之下,asyncio 运行在单线程内。它依赖一个持续轮询就绪事件的“事件循环”(Event Loop)与操作系统的 I/O 多路复用机制(如 Linux 上的 epoll、macOS 上的 kqueue)。所有爬虫协程在发起请求后立即将控制权交还给事件循环,事件循环在底层 socket 数据到来前可以继续推进成百上千个其它任务。每个协程的开销通常只有几百字节,因此一台普通开发机就可以轻松承载数千甚至上万个并发协程。
二、代码组织与典型实现:从直觉到协作
为了直观感受两者的编码差异,我们分别使用两种方式抓取一组测试 URL。
1. 多线程爬虫的典型实现
在 Python 中实现多线程爬虫,推荐直接使用标准库的 concurrent.futures.ThreadPoolExecutor。它封装了底层线程创建与销毁细节,且通过 max_workers 限制线程总数。
# 运行环境: Python 3.8+
# 依赖安装: pip install requests
import requests
from concurrent.futures import ThreadPoolExecutor, as_completed

urls = [f"https://httpbin.org/delay/1?id={i}" for i in range(20)]

def fetch_page(url):
    try:
        response = requests.get(url, timeout=5)
        response.raise_for_status()
        return {"url": url, "status": response.status_code, "len": len(response.text)}
    except requests.RequestException as e:
        return {"url": url, "error": str(e)}

def run_thread_crawler():
    results = []
    # 设置合理的最大线程数,一般建议在 10 ~ 50 之间
    with ThreadPoolExecutor(max_workers=10) as executor:
        future_to_url = {executor.submit(fetch_page, url): url for url in urls}
        for future in as_completed(future_to_url):
            res = future.result()
            results.append(res)
    return results

if __name__ == "__main__":
    data = run_thread_crawler()
    print(f"成功完成 {len(data)} 个任务")
future.result() 在主线程归集结果。
2. asyncio 异步爬虫的典型实现
编写异步爬虫不能再使用 requests,因为它的底层 socket 是同步阻塞的,一旦在协程中调用,就会把整个事件循环完全冻结,导致其余并发协程全部停滞。我们需要使用 aiohttp 或 httpx,并结合 asyncio.Semaphore 精确控制并发度。
# 运行环境: Python 3.8+
# 依赖安装: pip install aiohttp
import asyncio
import aiohttp

urls = [f"https://httpbin.org/delay/1?id={i}" for i in range(20)]

async def fetch_page_async(session, url, semaphore):
    async with semaphore:  # 控制同时飞在网络中的请求数量
        try:
            async with session.get(url, timeout=aiohttp.ClientTimeout(total=5)) as response:
                content = await response.text()
                return {"url": url, "status": response.status, "len": len(content)}
        except Exception as e:
            return {"url": url, "error": str(e)}

async def run_async_crawler():
    # 限制并发连接上限为 10,避免瞬间打崩目标端或本机端口
    semaphore = asyncio.Semaphore(10)

    # ClientSession 必须复用,复用底层 TCP 连接池
    async with aiohttp.ClientSession() as session:
        tasks = [fetch_page_async(session, url, semaphore) for url in urls]
        results = await asyncio.gather(*tasks)
    return results

if __name__ == "__main__":
    data = asyncio.run(run_async_crawler())
    print(f"异步爬取完成 {len(data)} 个任务")
time.sleep(1),必须替换为 await asyncio.sleep(1);同理,读取大文件时应使用 aiofiles,避免阻塞主线程事件循环。
三、核心选型决策树:按需定方案
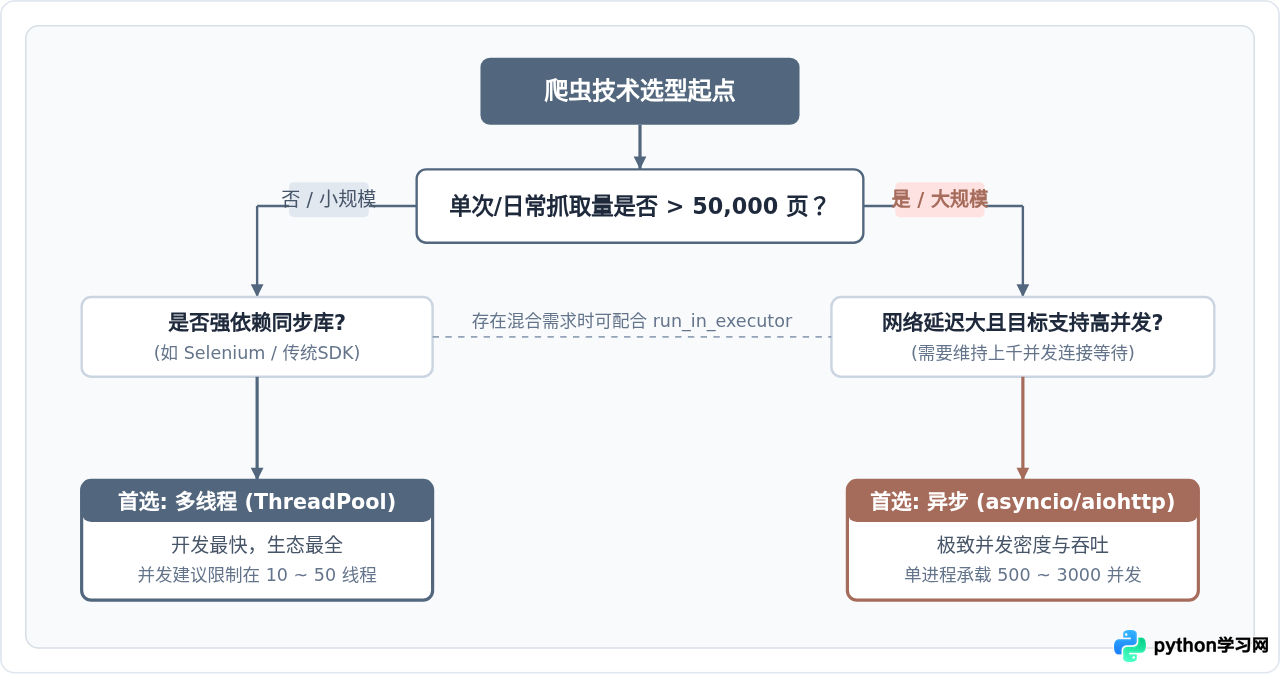
做出正确选择的核心在于:权衡你的开发维护时间与程序的吞吐规模需求。不要在只有几百个页面要抓的时候,为了“显得高级”去强行引入复杂的异步框架;也不要在每天数百万级的数据采集任务中死守多线程。
四、落地实操:构建稳健爬虫的四步法
无论是使用多线程还是异步架构,构建生产环境的高可靠爬虫,都必须遵循相同的分层演进逻辑。千万不要把网络拉取、数据解析与存储写入挤在一个函数里。
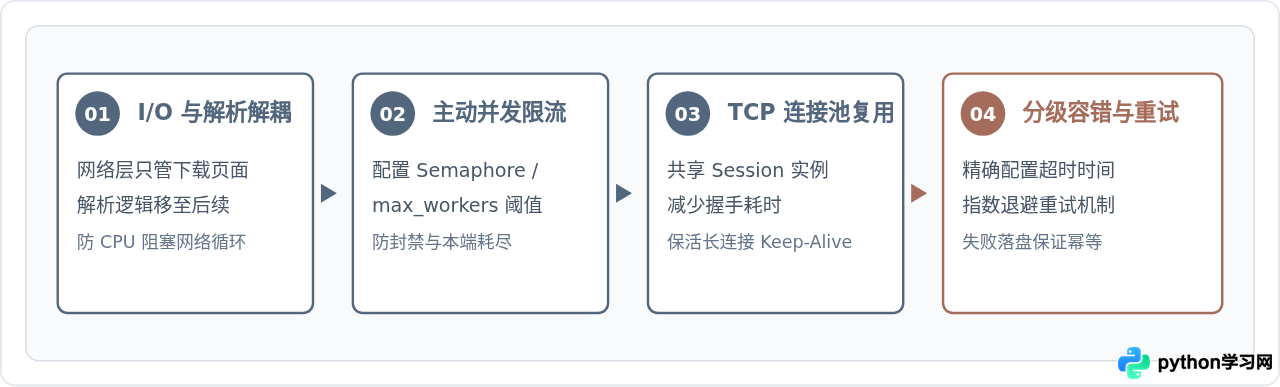
- I/O 拉取与 CPU 解析彻底解耦:如果抓取回来的 HTML 包含大量结构复杂的标签(如用 BeautifulSoup 或复杂正则解析),解析本身会大量占用 CPU。如果把这些耗时计算直接写在异步协程内,会严重拖慢事件循环调度。正确做法是将抓取到的原始数据扔给队列,由独立的处理工作池去解析。
- 严格控制最大并发:不要误以为异步性能好就可以直接
asyncio.gather(*[fetch(u) for u in 100000])。这会瞬间向目标站点发出十万个 TCP SYN 包,不仅会导致目标服务将你直接拉黑,还会导致本机因打开过多文件句柄而抛出OSError: [Errno 24] Too many open files错误。必须通过信号量(Semaphore)将同时活跃的并发限制在安全范围内。 - 复用全局 Session 与长连接:在循环内部反复创建
requests.Session()或aiohttp.ClientSession()是初学者最常犯的错误。创建 Session 涉及连接池管理与握手,必须在整个爬虫生命周期内全局复用同一个 Session 对象。 - 设定硬性超时与指数退避:网络请求随时可能因为对方反爬机制或丢包而挂起。任何请求都必须加上
timeout,并且在遇到 429(Too Many Requests)或 503 时,采取指数退避(Exponential Backoff)策略等待后再重试。
五、综合对比矩阵与总结建议
为了在方案评审或日常开发中快速参考,我们将关键维度的量化与定性对比总结如下:
| 对比维度 | 多线程爬虫 (ThreadPoolExecutor) | 异步爬虫 (asyncio + aiohttp) |
|---|---|---|
| 并发上限(单进程) | 建议 20 ~ 100 左右;过多会导致严重上下文切换 | 单机轻松支持 500 ~ 3000+ 高并发连接 |
| 内存消耗 | 较高(每个线程独占调用栈,数百线程占数百MB) | 极低(协程仅几百字节,数千协程仅占用数十MB) |
| 编码与心智负担 | 低。符合自上而下的同步思维,代码易读易写 | 高。必须严格区分 async/await,不能有阻塞调用 |
| 调试排查难度 | 中等。堆栈信息直观,普通断点调试即可支持 | 较难。跨协程上下文追踪较繁琐,日志追踪需传参 |
| 第三方生态支持 | 极为成熟。requests、playwright、各类SDK直接使用 | 稍有割裂。必须寻找异步驱动或通过适配器包装 |
| 最佳适用场景 | 中小规模任务(<5万)、敏捷原型开发、重依赖第三方同步库 | 大规模批量采集(>5万)、高频心跳探测、长连接监控 |
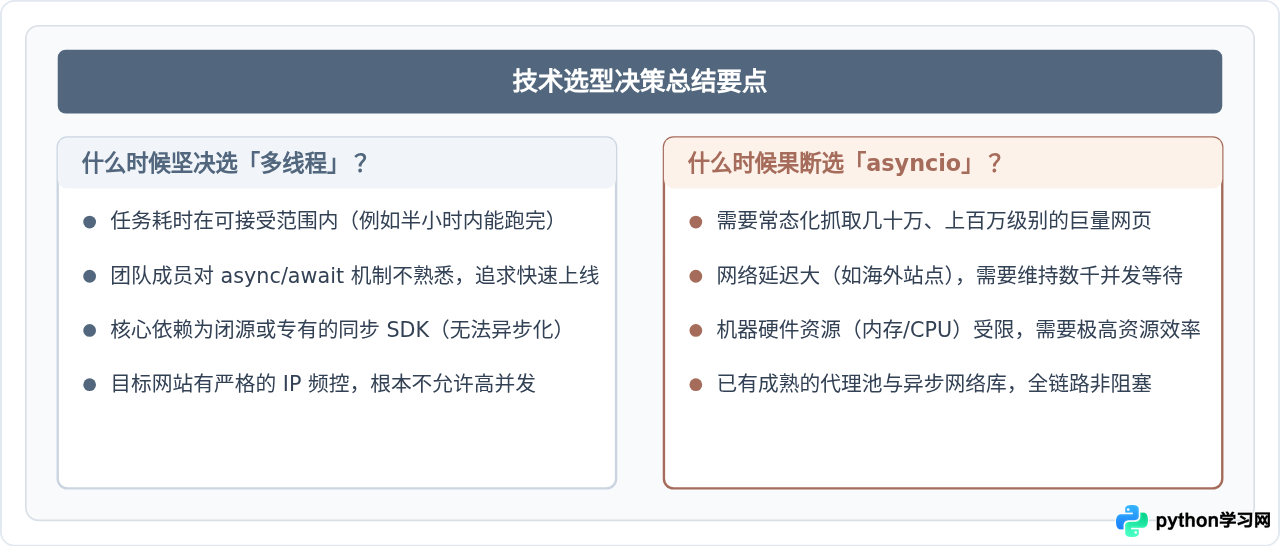
综上所述,技术选型从来不是非此即彼的“站队”。在实际工程项目中,最成熟的方案往往是混合架构:利用 asyncio 负责网络链路的高并发调度与原始 HTML 拉取,再通过 loop.run_in_executor 将计算密集型的解密、页面解析交给多进程或线程池处理。理解了多线程与异步协程在资源管理上的本质区别,就能在面对不同规模的数据采集任务时,做出兼具开发效率与运行性能的最优决策。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









