

Python字典合并时键冲突怎么处理?保留旧值或新值的策略
深入解析Python字典合并时发生键冲突的处理策略。详细讲解保留新值(右值覆盖)、保留旧值(原值优先)、零拷贝ChainMap视图以及嵌套字典递归合并的具体方案与代码实践。
假设你正在编写一个应用程序模块,系统内置了一组默认配置字典,同时允许用户传入自定义配置字典。当用户传入的字典与默认字典出现同名配置项(例如 timeout)时,合并两个字典就会触发键冲突。此时,究竟是让用户的自定义参数覆盖默认值,还是严格保护默认设置不受外部影响?在不同的业务场景中,这种选择截然不同。
在 Python 中,字典基于哈希表实现,天然具备键的唯一性。当两个字典存在相同的键时,单次映射无法容纳两份不同的值。因此,“键冲突处理”的本质并不是让冲突共存,而是根据需求选择保留左侧的旧值、保留右侧的新值,亦或是按特定逻辑合成复合值。本文将深入讲解不同策略下的语法实现、底层逻辑以及适用边界。
一、键冲突产生的机制与数据覆盖原理
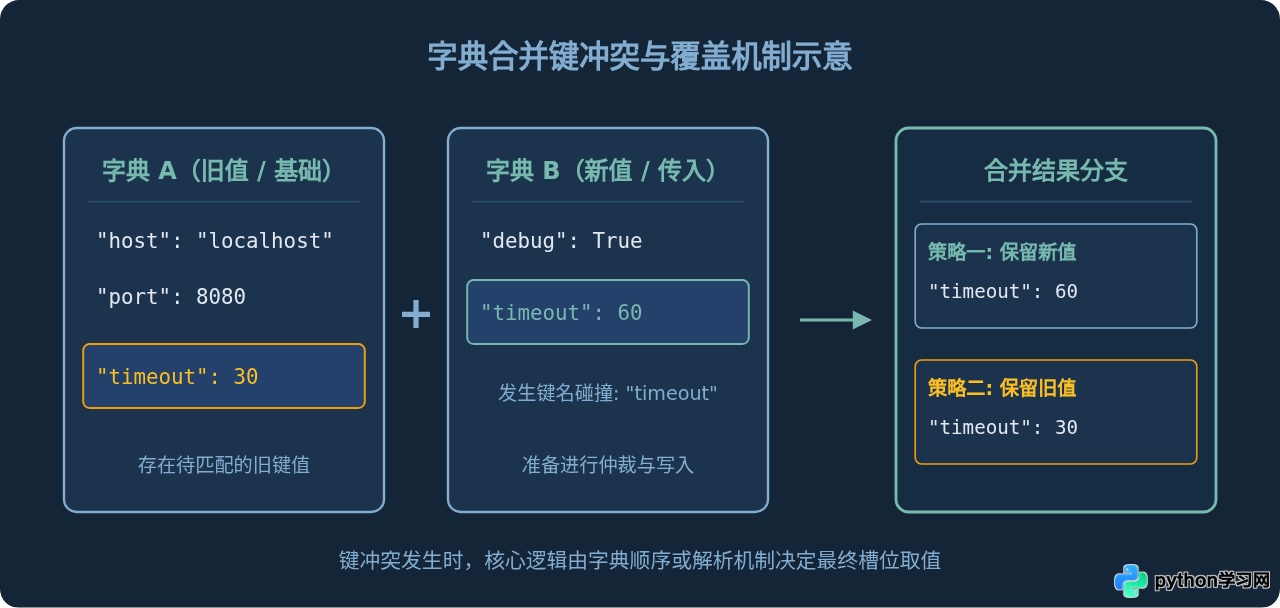
Python 字典的散列表存储结构决定了每个键只对应一个槽位(Slot)。当向字典写入一个已存在的键时,新值会直接替换关联的旧值指针。当进行字典合并时,如果两个字典分别拥有键 "timeout": 30 与 "timeout": 60,合并结果必然面临二选一的抉择。
理解合并机制的核心在于明确“评估顺序”。在绝大多数 Python 原生合并语法中,求值都是按顺序从左至右进行的。这意味着处于后方(右侧)的键值对具有更高的写入优先级。只要调整字典在表达式中的相对位置,就能从根本上控制是新值覆盖旧值,还是旧值保留下来。
二、保留新值策略:右侧操作数覆盖方案
在大多数配置覆盖或增量同步场景中,“保留新值”是最符合直觉的做法。即:当右侧字典拥有与左侧字典相同的键时,右侧字典的值无条件覆盖左侧字典。在 Python 中,有三种标准且常用的实现方式。
1. 字典合并运算符 |(Python 3.9+ 推荐)
自 Python 3.9 起,官方引入了 PEP 584 规范,为 dict 类型原生支持了合并运算符 | 以及就地更新运算符 |=。在表达式 d1 | d2 中,计算顺序遵循自左向右原则,因此 d2 中的同名键会自动覆盖 d1。
# 基础配置与用户传入的新配置
default_cfg = {"host": "localhost", "port": 8080, "timeout": 30}
user_cfg = {"timeout": 60, "debug": True}

# 使用 | 运算符生成新字典,新值覆盖旧值
merged = default_cfg | user_cfg

print(merged)
# 示例输出:
# {'host': 'localhost', 'port': 8080, 'timeout': 60, 'debug': True}
这种写法语法干净、语义明确,且直接返回一个崭新的字典对象,不会对原始的 default_cfg 造成任何副作用。
2. 双星号解包语法 {**d1, **d2}(Python 3.5+ 兼容方案)
如果运行环境仍处于较旧的 Python 版本(如 3.6 - 3.8),解包语法是保留新值的通用标准方式。同样地,后出现的解包项拥有更高的写入权:
base_dict = {"mode": "test", "level": 1}
override_dict = {"level": 5, "verbose": True}

# 解包合并,override_dict 的键值后写入
result = {**base_dict, **override_dict}

print(result)
# 示例输出:
# {'mode': 'test', 'level': 5, 'verbose': True}
3. 原地方法 dict.update()
如果你不需要保留原字典,或者希望直接修改已有的字典对象以减少内存分配,调用 update() 是性能最高的操作。它直接将目标字典的键值写入调用方:
config = {"theme": "light", "fontSize": 14}
patch = {"theme": "dark"}

# 直接在 config 上修改,新值写入
config.update(patch)

print(config)
# 示例输出:
# {'theme': 'dark', 'fontSize': 14}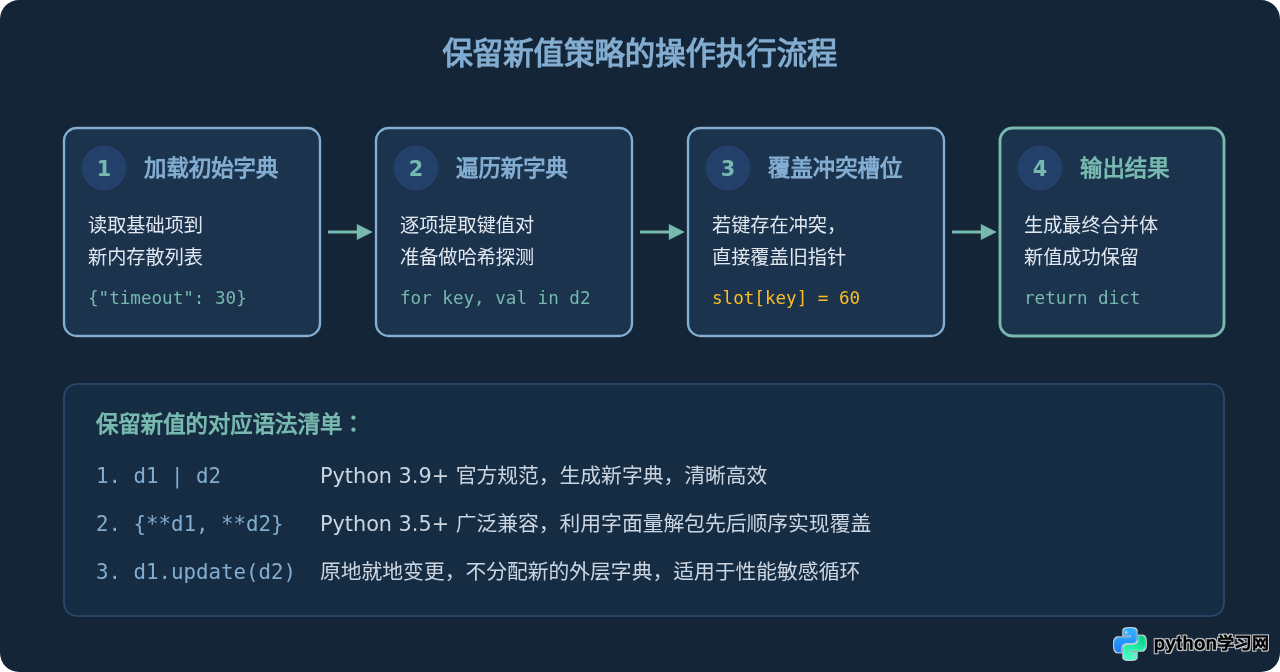
三、保留旧值策略:保护既有数据不被覆盖
与覆盖场景相反,很多时候我们需要“保护既有数据”。例如读取了只读的基础配置,或者多层继承关系中优先使用本地高优先级缓存,而只从外部补充缺失的数据项。此时如果发生键冲突,必须坚决保留旧值。
1. 交换操作数顺序(最简实现)
既然 d1 | d2 是右侧覆盖左侧,那么只需将两个字典的位置调换为 d2 | d1,就能巧妙实现“保留旧值”:
old_data = {"id": 101, "status": "active", "level": "VIP"}
incoming = {"id": 999, "status": "inactive", "notes": "New user"}

# 将旧数据放在右侧,让旧数据“覆盖”新数据
result = incoming | old_data

print(result)
# 示例输出:
# {'id': 101, 'status': 'active', 'notes': 'New user', 'level': 'VIP'}
解析过程如下:先将 incoming 的所有键值写入中间字典;随后将 old_data 的键值写入,同名键 id 和 status 重新被 old_data 的值覆盖回初始值,而新字典独有的 notes 则保留下来。其效果完全等价于“只合并不冲突的新键,冲突项保留旧值”。
2. 使用 collections.ChainMap(零拷贝视图)
在处理超大字典或高频只读查找场景中,重新构建一个新字典不仅耗费时间,还会成倍占用内存。Python 标准库的 collections.ChainMap 能够将多个字典逻辑上串联起来,形成一个统一的映射视图。
当查询一个键时,ChainMap 会按照传入字典的先后顺序依次检索,一旦在靠前的字典中命中,立刻返回该值,绝不会继续向后查找:
from collections import ChainMap

primary_dict = {"api_key": "KEY_AAA", "timeout": 15}
fallback_dict = {"api_key": "KEY_BBB", "timeout": 60, "region": "ap-east"}

# primary_dict 置于最前,享有最高查找优先权
chained = ChainMap(primary_dict, fallback_dict)

# 查询冲突键,返回 primary_dict 中的旧值
print(chained["timeout"])
# 示例输出: 15

# 查询独有键,正常 fallback 到后方字典
print(chained["region"])
# 示例输出: ap-east
重要特点与注意事项
ChainMap 是原始字典的底层引用视图,不会复制底层键值数据。如果后续修改了 primary_dict,视图中的查询结果会实时同步变化。这在管理分层作用域(如系统环境变量、命令行参数与默认配置文件)时极其优雅。
3. 原地补全:setdefault() 与循环保护
如果希望在原字典 old_dict 上直接扩展缺失键,而绝对不改变已有键的内容,可以使用字典的 setdefault() 方法:
target = {"role": "admin", "theme": "system"}
defaults = {"role": "guest", "theme": "dark", "locale": "zh-CN"}

for key, val in defaults.items():
    # 仅当 key 不存在时才设置,若存在则完全忽略 val
    target.setdefault(key, val)

print(target)
# 示例输出:
# {'role': 'admin', 'theme': 'system', 'locale': 'zh-CN'}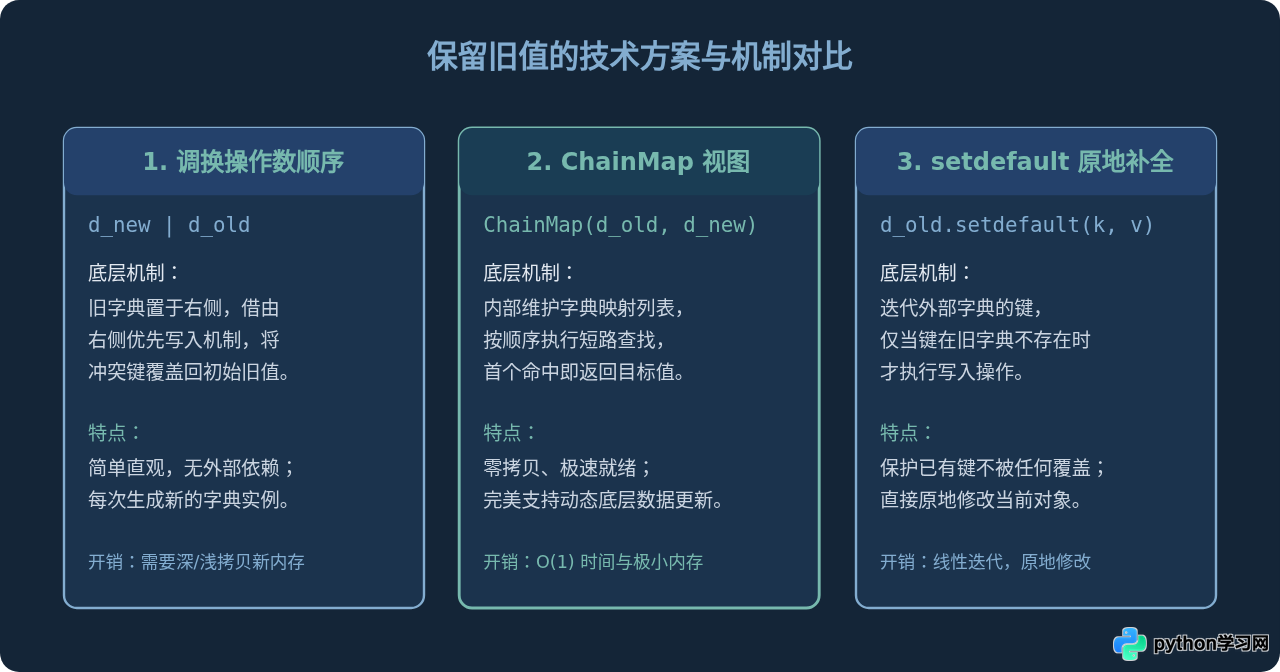
四、进阶场景:非简单二选一的冲突定制处理
现实开发中,键冲突的处理往往不仅限于“保留旧值”或“保留新值”。当字典包含多层嵌套,或者冲突的值本身属于数值累加型、列表合并型时,简单的键覆盖会导致子层级数据丢失。此时需要使用针对性的冲突处理函数。
1. 嵌套字典的递归深度合并(Deep Merge)
如果两个字典的冲突键所对应的值仍然是字典,常规的 | 运算会将整个子字典粗暴替换。要保留两个层级的全部内容,必须采用递归合并:
def deep_merge(dict_a, dict_b, prefer_new=True):
    """
    递归深度合并两个字典。
    当键冲突且两者均为字典时,递归合并子字典;
    若为普通值,根据 prefer_new 决定保留新值或旧值。
    """
    result = dict_a.copy()
    for key, val in dict_b.items():
        if key in result:
            # 当双方都是子字典时,进入递归合并
            if isinstance(result[key], dict) and isinstance(val, dict):
                result[key] = deep_merge(result[key], val, prefer_new=prefer_new)
            else:
                # 普通值冲突,按策略选择
                result[key] = val if prefer_new else result[key]
        else:
            result[key] = val
    return result

# 示例:多层嵌套字典合并
base_env = {
    "database": {"host": "10.0.0.1", "port": 3306},
    "logging": {"level": "INFO"}
}
patch_env = {
    "database": {"port": 3307, "user": "root"},
    "logging": "disabled"
}

# 深度合并,保留嵌套结构且新值优先
final_env = deep_merge(base_env, patch_env, prefer_new=True)

print(final_env)
# 示例输出:
# {'database': {'host': '10.0.0.1', 'port': 3307, 'user': 'root'}, 'logging': 'disabled'}
2. 冲突键值的聚合运算
当需要将重复键的指标相加(如购物车数量累计、日志统计)时,可以使用 collections.Counter 或循环推导:
from collections import Counter

batch_1 = {"apple": 10, "banana": 5}
batch_2 = {"apple": 8, "orange": 12}

# 使用 Counter 处理数值累加
total_counts = dict(Counter(batch_1) + Counter(batch_2))

print(total_counts)
# 示例输出:
# {'apple': 18, 'banana': 5, 'orange': 12}
五、常见误区与避坑建议
- 误区一:混淆浅拷贝与深度隔离。 无论是
d1 | d2还是{**d1, **d2},生成的都是浅拷贝。如果字典内部包含列表或嵌套字典,合并后新字典依然共享内部对象的引用。若需要完全隔离,务必配合copy.deepcopy()使用。 - 误区二:在大量字典合并的循环中滥用
|运算符。 如果在一个拥有上万项的列表中执行for d in list_of_dicts: acc = acc | d,每次循环都会分配一个新的临时字典并拷贝所有旧数据,时间复杂度骤升为 $O(N^2)$。此时应当先建立空字典,在循环中使用acc.update(d)原地写入。 - 误区三:误认为
ChainMap会生成独立的持久化字典。ChainMap是由指针维系的视图,并不能阻止后续外部代码直接修改原始字典。如果需要将合并视图固化,应显式执行dict(chained)。
六、策略选型与全场景速查指南
为了帮助你在具体编码时快速决断,下表汇总了所有常见合并方式的核心行为:
| 处理策略 | 推荐代码语法 | 冲突时结果 | 副作用 / 原地变更 | 适用 Python 版本 |
|---|---|---|---|---|
| 保留新值 | d1 | d2 |
右侧 d2 覆盖 d1 |
无(返回新字典) | Python 3.9+ |
| 保留新值 (兼容) | {**d1, **d2} |
右侧 d2 覆盖 d1 |
无(返回新字典) | Python 3.5+ |
| 保留新值 (原地) | d1.update(d2) |
d2 写入并覆盖 d1 |
d1 产生变更 |
Python 2.7 / 3.0+ |
| 保留旧值 | d2 | d1 |
左侧 d1 反向覆盖 d2 |
无(返回新字典) | Python 3.9+ |
| 保留旧值 (零拷贝) | ChainMap(d1, d2) |
优先查找并返回 d1 |
无(返回动态视图) | Python 3.3+ |
| 保留旧值 (原地补齐) | d1.setdefault(k, v) |
已有键跳过,新键插入 | d1 产生变更 |
Python 2.7 / 3.0+ |
| 深度嵌套合并 | 自定义 deep_merge() |
子字典递归,普通值按配置 | 可配置 | 全版本通用 |
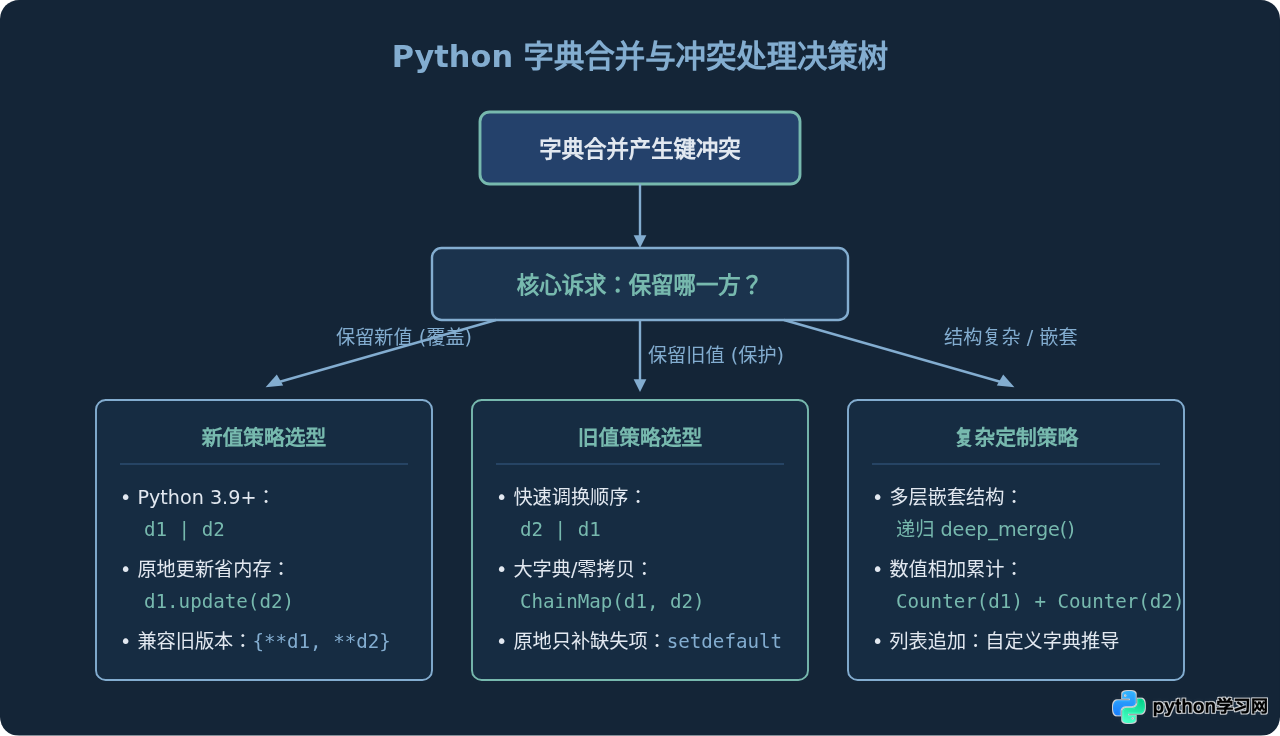
总结
处理 Python 字典合并中的键冲突,关键在于明确业务对数据的“优先权定义”:
如果业务以“配置更新、参数覆盖”为主导,优先选用 Python 3.9+ 的 d1 | d2 语法,既清晰又符合现代 Python 代码规范;若在海量数据循环中,则使用 d1.update(d2) 原地执行以保护计算资源。
如果业务以“旧值优先、基准保护”为主导,反向操作 d2 | d1 是最直接的代码写法;对于需要分层检索、避免内存翻倍的性能敏感场景,collections.ChainMap 则是最具工程价值的利器。当涉及多层嵌套字典时,切记不可直接浅层合并,编写或引用成熟的递归深度合并函数才能彻底规避子层级数据被意外抹除的风险。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









