

Python必背100源代码下载:分类整理与运行指南
提供Python必背100个经典核心源码的规范分类整理与本地下载运行指南。涵盖基础语法、核心数据结构、文件IO、算法逻辑及自动化脚本五大维度,包含完整的解压部署、虚拟环境配置、依赖安装及常见排错流程。
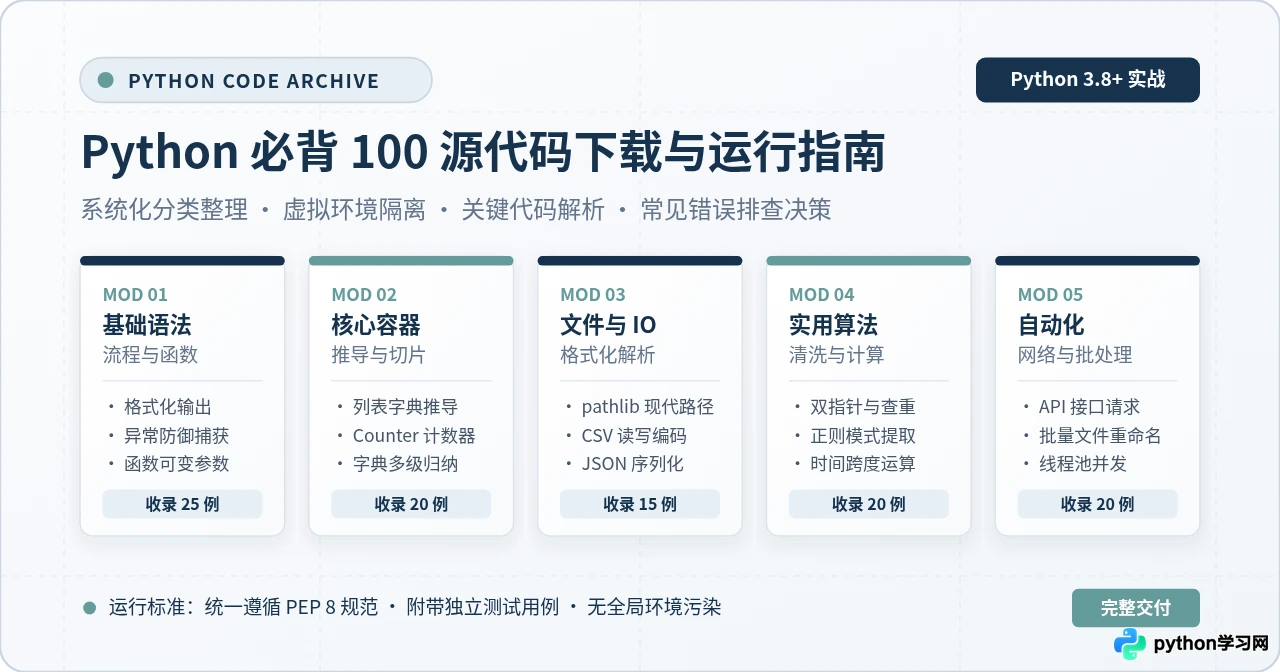
一、为什么需要结构化的“必背 100 源代码”?
很多开发者在学习 Python 时,常常在网上保存过大量碎片化的代码截图或散落的记事本片段。然而当实际面临具体任务时,却经常出现“看着眼熟,脱稿写不出,下载下来跑不通”的困境。
所谓“必背源代码”,并不是要求死记硬背每个标点符号,而是掌握那些在日常业务、数据分析或脚本编写中反复出现的地道写法(Pythonic Idioms)。这 100 个代码片段的核心价值在于:
- 精简聚焦:每个用例只解决一个具象的语言机制或实际场景,单个文件通常在 15 至 40 行之间,阅读负荷极低;
- 自洽可运行:所有源码均自带模拟输入与测试调用,不依赖外部黑盒数据,开箱即测;
- 标准规范:完全遵循 PEP 8 命名规范,规避初学者常见的变量命名随意与异常裸露隐患。
二、源代码标准目录结构与规范下载途径
建议避免从网盘下载来路不明的 .exe 安装包或二次打包的带密码压缩包。标准的源码合集应以纯文本 .py 脚本的形式托管在代码仓库或标准 ZIP 归档中。
下载解压后的标准项目工程应具备清晰的树形目录结构,如下所示:
python-top100/
├── README.md               # 100 个源码索引目录及功能描述表
├── requirements.txt        # 极轻量三方库依赖清单 (如 requests 等)
├── 01_basics/              # 模块一:基础语法与流程控制 (25例)
│   ├── 01_fstring_format.py
│   ├── 02_unpack_variable.py
│   └── ...
├── 02_containers/          # 模块二:数据结构与推导技巧 (20例)
│   ├── 26_list_comprehension.py
│   ├── 30_counter_stat.py
│   └── ...
├── 03_files_io/            # 模块三:文件系统与 IO 解析 (15例)
│   ├── 46_pathlib_operate.py
│   ├── 50_csv_dict_reader.py
│   └── ...
├── 04_algorithms/          # 模块四:实用算法与数据清洗 (20例)
│   ├── 61_quick_sort.py
│   ├── 68_regex_extract.py
│   └── ...
└── 05_automation/          # 模块五:自动化脚本与网络请求 (20例)
    ├── 81_requests_json.py
    ├── 92_batch_rename.py
└── ...D:\projects\python-top100 或 macOS/Linux 的 ~/workspace/python-top100),这能直接消除后续 50% 以上因编码和路径转义导致的玄学报错。
三、五大核心分类矩阵与精选代表代码解析
为了让读者形成清晰的技术图谱,我们将 100 个代码用例严格归入五大维度。每一维度均承担明确的技能训练任务。
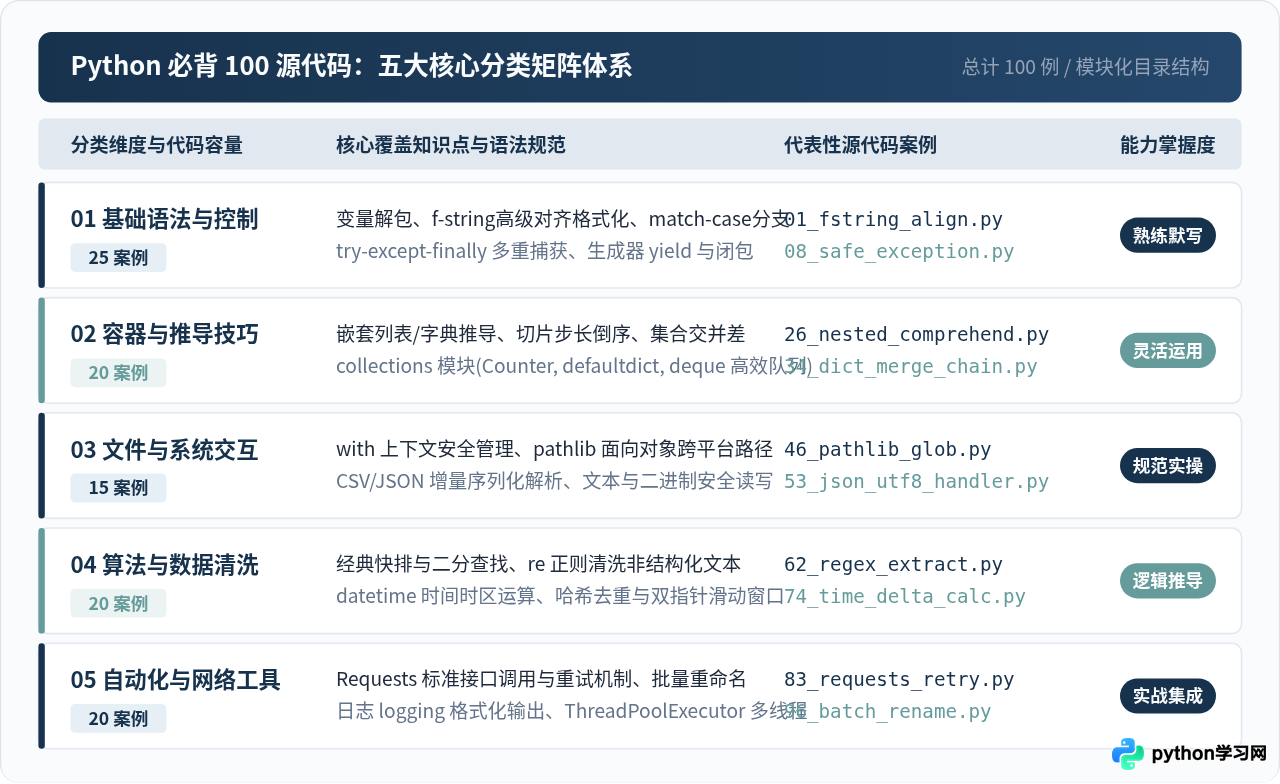
1. 模块一:基础语法与控制流(25 例)
涵盖字符串格式化、模式匹配、多重异常捕获及生成器。以下为第 05 例“带类型提示与自愈回退的安全类型转换”示范:
# 01_basics/05_safe_convert.py
def safe_int_convert(value: str, default: int = 0) -> int:
    """安全转换为整数,遇到脏数据回退到默认值"""
    try:
        return int(value.strip())
    except (ValueError, TypeError, AttributeError) as err:
        # 记录轻量日志或直接返回防御值
        return default

# 示例验证
test_cases = ["  42  ", "abc", None, "108px", "99"]
cleaned = [safe_int_convert(item, default=-1) for item in test_cases]
print("转换结果:", cleaned)2. 模块二:数据结构与推导式(20 例)
重点考察列表推导、字典多条件过滤以及标准库 collections 的实战技巧。以下为第 31 例“利用 defaultdict 进行一对多键值分组”:
# 02_containers/31_group_by_key.py
from collections import defaultdict

raw_records = [
    ("开发部", "张三"), ("市场部", "李四"),
    ("开发部", "王五"), ("市场部", "赵六"), ("测试部", "钱七")
]

# 传统写法需显式判断 key 是否在 dict 中,defaultdict 一行初始化
grouped = defaultdict(list)
for dept, name in raw_records:
    grouped[dept].append(name)

# 转换为标准字典并输出
for dept, members in sorted(grouped.items()):
print(f"{dept} ({len(members)}人): {', '.join(members)}")开发部 (2人): 张三, 王五
市场部 (2人): 李四, 赵六
测试部 (1人): 钱七
3. 模块三:文件与 IO 系统交互(15 例)
摆脱过时的 os.path 拼接字符串,全面采用现代跨平台标准库 pathlib.Path,搭配 with 上下文管理器确保句柄安全释放。以下为第 48 例“现代跨平台目录递归扫描与筛选”:
# 03_files_io/48_pathlib_scan.py
from pathlib import Path

def list_python_files(target_dir: str):
    base_path = Path(target_dir).resolve()
    print(f"正在扫描目录: {base_path}")

    # rglob 实现跨子目录递归检索
    py_files = list(base_path.rglob("*.py"))
    for idx, f in enumerate(py_files[:3], 1):
        print(f"[{idx}] {f.name} (大小: {f.stat().st_size} bytes)")
    return len(py_files)

# 示例验证 (检索当前项目根目录)
total = list_python_files(".")
print(f"Python 脚本总数: {total}")
4. 模块四:实用算法与数据清洗(20 例)
包含数据分析常见的时间计算、正则表达式清洗非结构化文本、双指针去重。以下为第 65 例“基于正则从混合文本中精准清洗结构化数据”:
# 04_algorithms/65_regex_clean.py
import re

log_entry = "2026-11-20 12:00:00 [ERROR] user_id=10829 ip=192.168.1.101 api=/order/create"

# 具名捕获组提高代码可读性
pattern = r"(?P<datetime>\d{4}-\d{2}-\d{2} \d{2}:\d{2}:\d{2}) \[(?P<level>\w+)\] user_id=(?P<uid>\d+) ip=(?P<ip>[\d\.]+)"
match = re.search(pattern, log_entry)

if match:
    data = match.groupdict()
    print("提取成功:", data)
print("用户ID:", data["uid"], "| 客户端IP:", data["ip"])提取成功: {'datetime': '2026-11-20 12:00:00', 'level': 'ERROR', 'uid': '10829', 'ip': '192.168.1.101'}
用户ID: 10829 | 客户端IP: 192.168.1.101
5. 模块五:自动化与网络工具(20 例)
包含 API 接口安全调用、轻量并发线程池及文件批量自动化。以下为第 85 例“带超时、状态码校验与优雅重试的 HTTP 请求工具”:
# 05_automation/85_safe_request.py
import requests
from requests.adapters import HTTPAdapter
from urllib3.util import Retry

def create_resilient_session(retries: int = 3) -> requests.Session:
    """构建带重试退避机制的高可靠 Session 客户端"""
    session = requests.Session()
    retry_strategy = Retry(
        total=retries,
        backoff_factor=1,
        status_forcelist=[429, 500, 502, 503, 504],
        allowed_methods=["HEAD", "GET", "OPTIONS"]
    )
    adapter = HTTPAdapter(max_retries=retry_strategy)
    session.mount("https://", adapter)
    session.mount("http://", adapter)
    return session

# 示例验证 (调用公共健康检查地址)
session = create_resilient_session()
try:
    resp = session.get("https://httpbin.org/get", timeout=5)
    print("请求状态码:", resp.status_code)
except requests.exceptions.RequestException as err:
    print("网络请求终止:", err)
四、从解压到运行:本地标准操作流水线
为了保证这 100 个脚本能够顺畅跑通,切忌直接双击 .py 文件打开,也不要随意将全局 Python 环境安装大量混乱的三方包。推荐采用标准虚拟环境流水线进行管理。
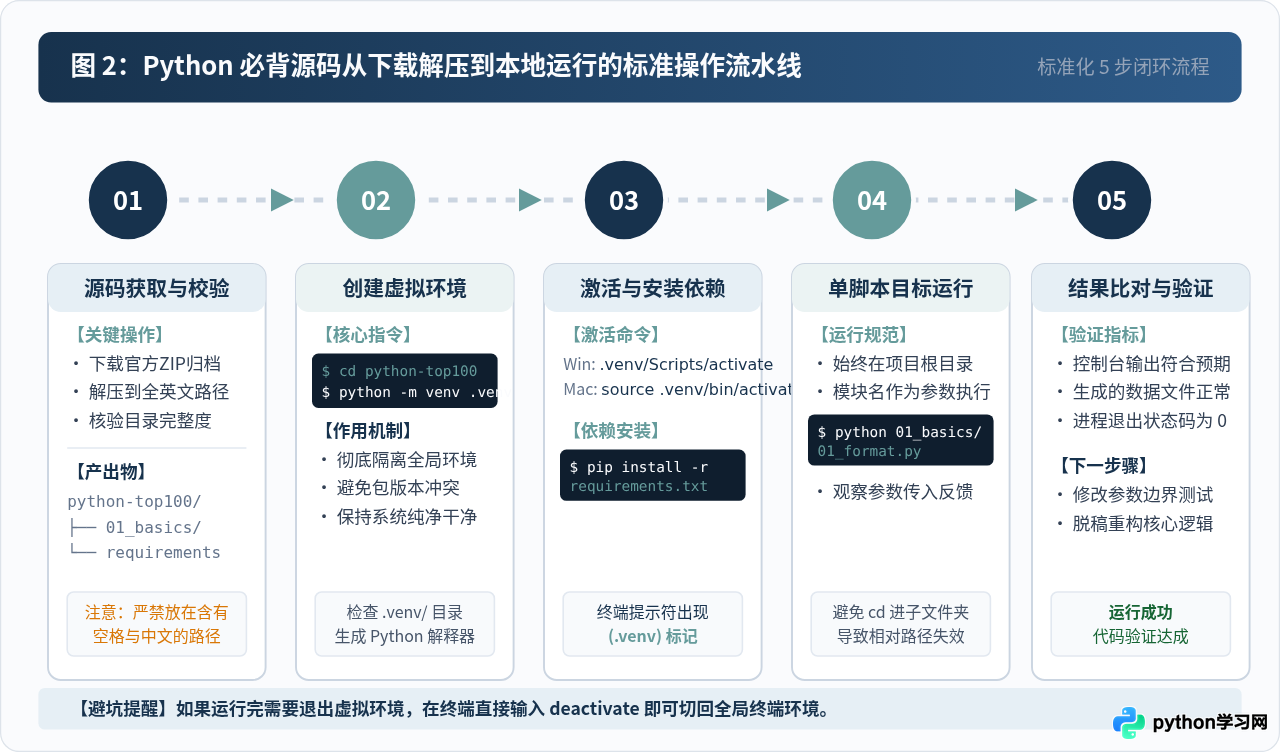
步骤 1:打开终端并进入解压目录
在系统终端(Windows 的 PowerShell,macOS 的 Terminal,或 VS Code 内置终端)中,使用 cd 命令进入解压后的源码根目录:
cd /path/to/python-top100步骤 2:创建本地独立虚拟环境
使用 Python 内置的 venv 模块创建一个名为 .venv 的独立沙盒。这一步不会对你原本的系统 Python 造成任何影响:
python3 -m venv .venvpython3 提示未找到命令,请替换为 python -m venv .venv。
步骤 3:激活虚拟环境并安装极简依赖
不同操作系统的激活命令略有不同,请按照下表执行:
| 操作系统 | 激活命令 | 成功标识 |
|---|---|---|
| Windows (PowerShell) | .\.venv\Scripts\Activate.ps1 |
命令行最前端出现 (.venv) |
| Windows (CMD) | .\.venv\Scriptsctivate.bat |
命令行最前端出现 (.venv) |
| macOS / Linux (Bash/Zsh) | source .venv/bin/activate |
命令行最前端出现 (.venv) |
激活成功后,安装项目中少数脚本依赖的基础库:
pip install -r requirements.txt步骤 4:执行指定代码文件
始终在项目根目录下发起调用,通过传递相对路径来执行脚本:
python 01_basics/05_safe_convert.py观察控制台的输出是否与注释中的预期结果一致。测试完毕后,如果需要离开虚拟环境,在终端直接输入 deactivate 即可。
五、常见运行报错排查决策与解决方案
初学者在本地跑代码时,几乎都会撞上几类高频报错。只要掌握根本诱因,排查和修复均可在数十秒内完成。
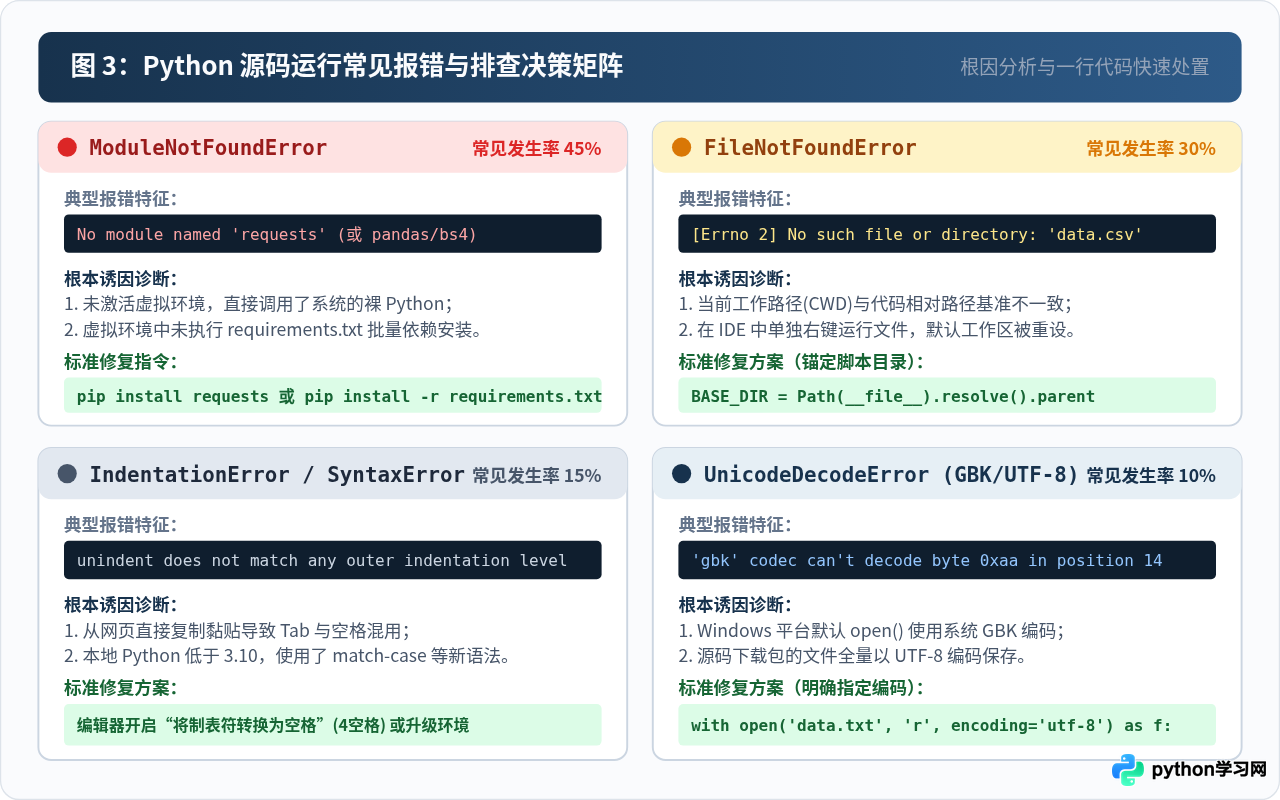
1. ModuleNotFoundError: No module named 'xxx'
根本原因:当前执行命令的 Python 解释器并非安装了依赖的虚拟环境解释器,或者尚未执行 pip install。
排查与修复:
- 在终端输入
which python(macOS/Linux) 或where python(Windows),检查是否指向.venv路径; - 如果显示为系统全局路径,重新执行
source .venv/bin/activate激活环境; - 若是单一缺失库,直接执行
pip install xxx即可。
2. FileNotFoundError: [Errno 2] No such file or directory
根本原因:代码中使用了类似 open("data.csv") 的相对路径,但你的终端当前所在位置并不是脚本所在的目录,导致基准工作区(Current Working Directory)偏差。
优雅解决方案:不要改动终端路径,而在代码内部使用 Path(__file__).resolve().parent 锚定当前脚本所在物理目录:
from pathlib import Path

# 无论终端在哪个目录执行,均能精准寻址
CURRENT_DIR = Path(__file__).resolve().parent
target_file = CURRENT_DIR / "data.csv"

with open(target_file, "r", encoding="utf-8") as f:
    content = f.read()
3. UnicodeDecodeError: 'gbk' codec can't decode byte...
根本原因:Windows 系统的默认文本解码器是 ANSI/GBK,当读取采用 UTF-8 编码的现代开源代码或数据文本时,就会在遇到中文字符时抛出异常。
防御准则:在所有涉及 open() 的代码中,永远显式声明 encoding="utf-8":
with open("sample.txt", "r", encoding="utf-8") as f:
    text = f.read()
六、从“跑通源码”到“能力内化”的四阶进阶路径
把 100 个脚本跑完一遍只是第一步。要真正将这些代码转化为自己的编程直觉,建议遵循循序渐进的四阶进阶模型。
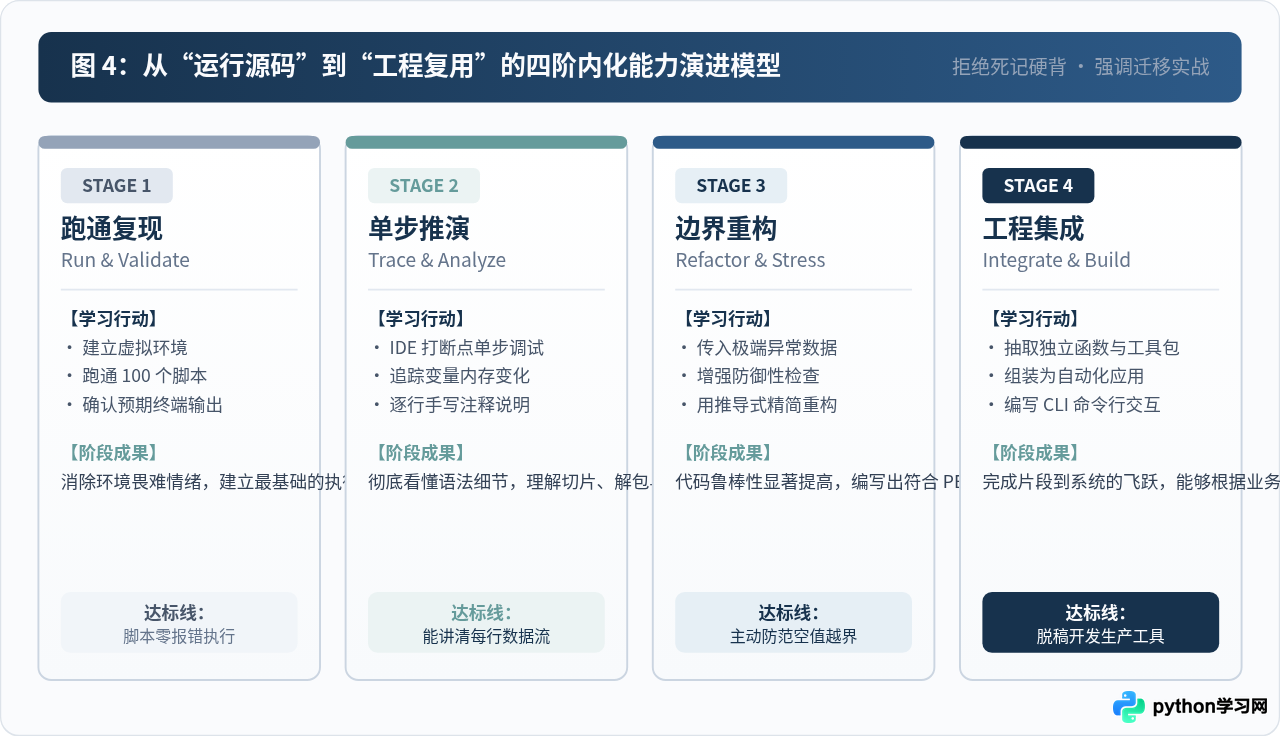
- 第一阶段:跑通验证(Run & Validate)
不改动任何核心代码,依照运行指南在本地搭设虚拟环境,确保 100 个脚本在终端中全量无报错执行,熟悉标准输出的模式。 - 第二阶段:单步推演(Trace & Analyze)
借助 VS Code 或 PyCharm 的 Debugger 功能,在每个脚本的关键逻辑处打上断点,单步观察局部变量在每一轮循环、分支、解包中的数值流动。 - 第三阶段:边界改造(Refactor & Stress)
故意输入极端数据(如空字符串、超长数组、包含特殊符号的字典键),观察脚本是否会发生崩溃,并尝试加入try-except或推导式进行更健壮的重构。 - 第四阶段:工程集成(Integrate & Build)
将多个模块的代码进行拼装。例如:将模块三的文件遍历、模块四的正则清洗和模块五的 HTTP 请求组合在一起,快速写出一个自动扫描本地日志并上传告警的完整工程小工具。
七、总结
高质量学习 Python 的捷径不是浮躁地收藏数千页教程,而是踏踏实实吃透 100 个具有代表性的地道代码用例。掌握本文介绍的标准工程结构、虚拟环境隔离运行技巧与常见报错排查矩阵后,你就可以放心下载并本地演练这批核心代码,将其逐步转化为自己项目中的生产力。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









