

Python标准库urllib怎么发送GET请求(无需安装第三方库)
本文详细讲解如何使用 Python 自带的标准库 urllib 发送 HTTP GET 请求,包括基础请求、URL 参数规范编码、自定义 Headers 请求头伪装、连接超时设置与网络异常处理,无需安装任何第三方库。
requests 且不允许随时使用 pip 安装第三方依赖。此时,使用 Python 自带的标准库 urllib 是发起 HTTP GET 请求最直接且最可靠的解决方案。本文将围绕 urllib.request 模块,具体演示从最基础的单行请求、URL 查询参数编码,到伪装请求头(Headers)、超时控制与分层网络异常捕获的完整落地流程。
一、发送最简单的 GET 请求
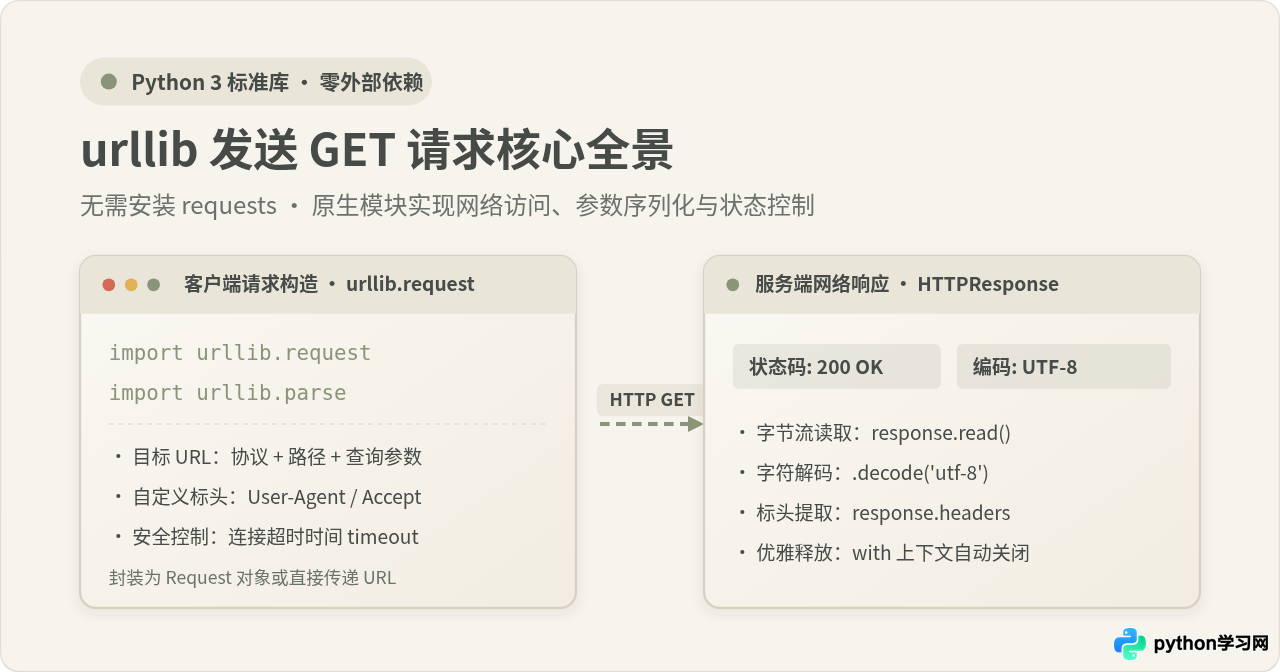
如果只需向某个固定的 URL 发起一次无特殊要求的 GET 请求,标准库中最核心的入口函数是 urllib.request.urlopen()。它负责建立网络连接并向目标地址发送请求,返回一个类似于文件流的 HTTPResponse 对象。
需要特别注意的是,通过 response.read() 读取出来的响应体是未经解码的原生字节流(bytes 类型),而不是普通的字符串。因此在实际处理文本或 JSON 数据时,必须显式调用 .decode('utf-8') 将其还原为 Python 字符串。
import urllib.request

# 1. 目标地址
url = "https://httpbin.org/get"

# 2. 发起 GET 请求并获取响应对象
# 使用 with 上下文管理器,确保网络套接字在使用完毕后被自动关闭
with urllib.request.urlopen(url) as response:
    # 读取原生字节流并指定 UTF-8 编码解码为字符串
    content = response.read().decode('utf-8')
    status_code = response.status  # HTTP 状态码,如 200

    print(f"状态码: {status_code}")
print(f"响应正文长度: {len(content)} 字符")响应正文长度: 308 字符
在上面的代码中,with 语句扮演了关键的资源释放角色。网络连接属于稀缺的系统 I/O 资源,若不借助 with 或显式调用 response.close(),在高频请求的循环体中容易引发文件描述符或套接字泄漏。
二、携带查询参数与 URL 规范编码
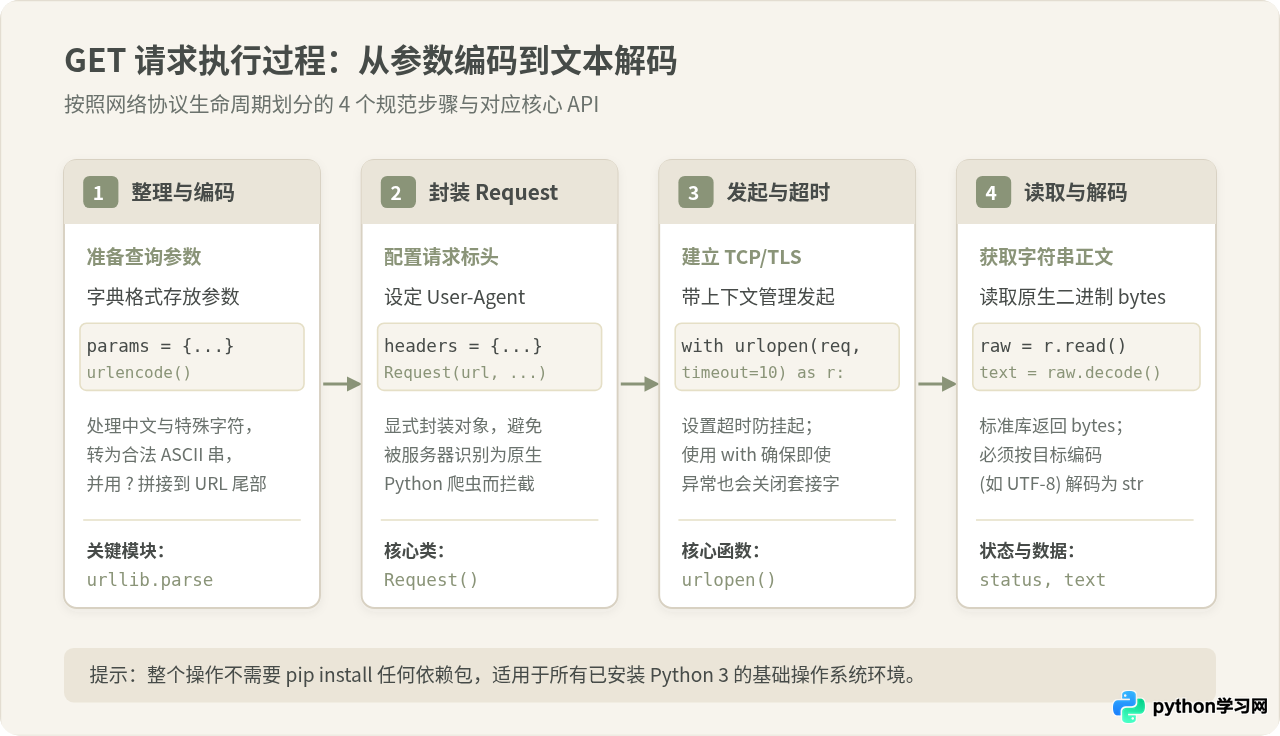
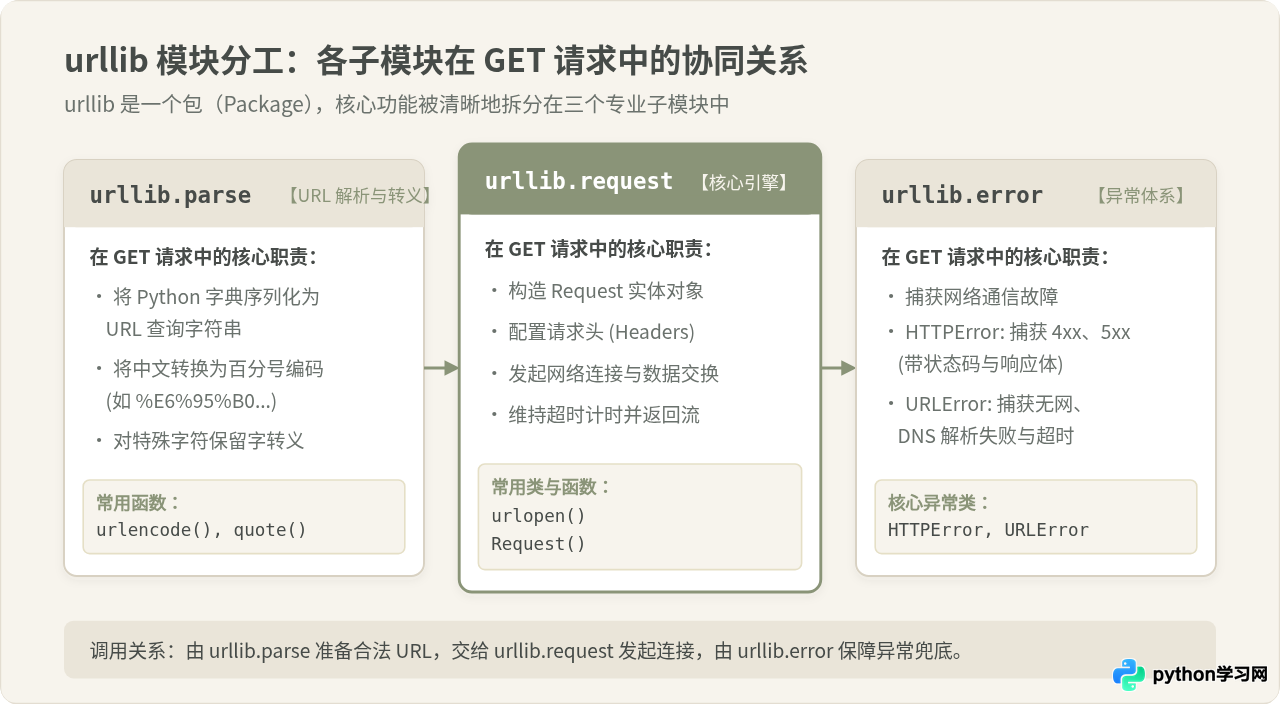
实际开发中的 GET 请求通常需要在 URL 后面附带查询参数(Query String),例如分页页码、检索关键词或筛选分类。在标准库中,参数的处理需要借助另一个子模块:urllib.parse。
易混淆说法辨析:直接用加号拼接参数是否可行?
部分开发者在初学时习惯直接拼接字符串,例如 url = base_url + "?kw=" + keyword。这种做法在参数仅为纯英文和数字时看似正常运作,但存在极大的潜在隐患:
- 非 ASCII 字符解析失败:当
keyword包含中文时(如"教程"),直接传入urlopen会引发UnicodeEncodeError或InvalidURL异常,因为 HTTP 协议要求 URL 中的非 ASCII 字符必须按照特定规则转换为百分号转义编码。 - 保留字符语义冲突:如果参数内容本身包含
&、=、?或空格,直接拼接会导致服务端误将一个参数值拆分成多个键值对,破坏请求语义。
因此,标准规范的做法始终是将查询参数统一保存在字典中,并调用 urllib.parse.urlencode() 进行序列化转义,再拼接到 URL 尾部。
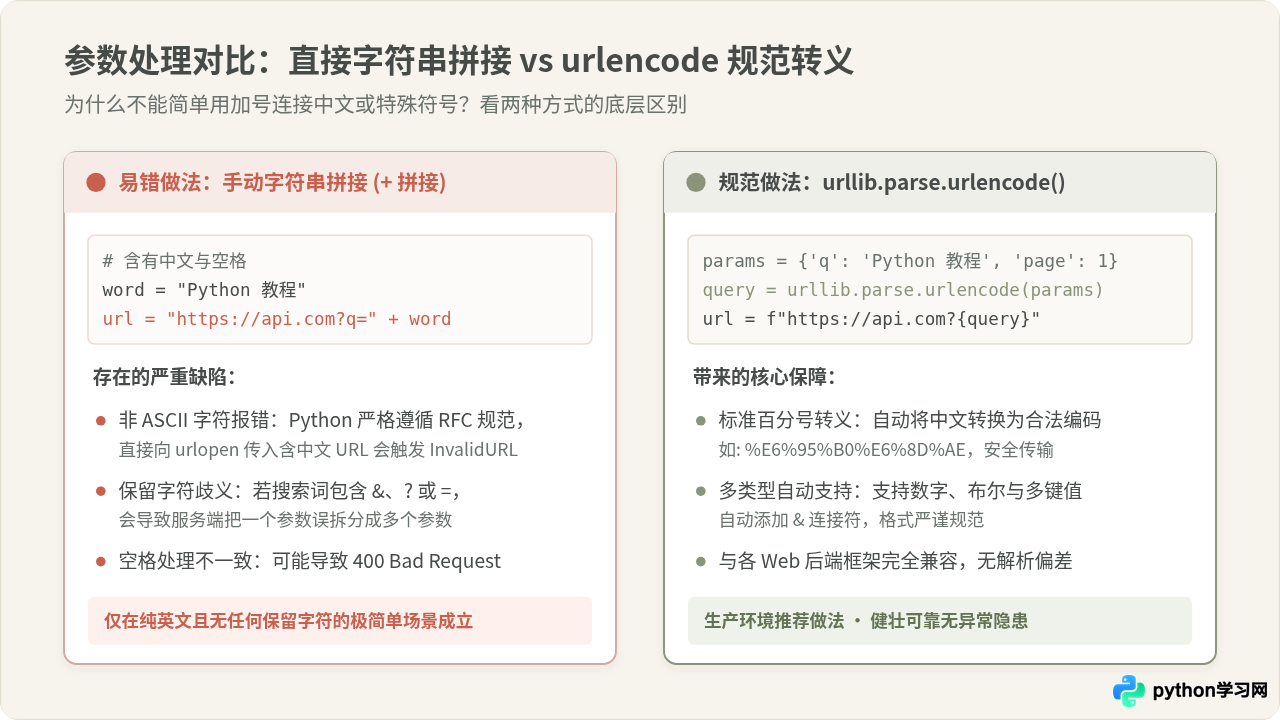
以下是携带中文与复合查询参数的标准范例:
import urllib.request
import urllib.parse

base_url = "https://httpbin.org/get"

# 1. 将查询参数定义为字典
params = {
    "query": "Python教程",
    "page": 1,
    "tag": "urllib&web"
}

# 2. 将字典转为符合 RFC 3986 规范的 URL 编码字符串
query_string = urllib.parse.urlencode(params)
print(f"编码后的查询参数: {query_string}")

# 3. 拼装为完整的请求地址
full_url = f"{base_url}?{query_string}"

# 4. 发起请求
with urllib.request.urlopen(full_url) as response:
    result = response.read().decode('utf-8')
    print("请求成功,响应前 120 字符:")
print(result[:120])请求成功,响应前 120 字符:
{
"args": {
"page": "1",
"query": "Python教程",
"tag": "urllib&web"
},
通过 urllib.parse.urlencode() 处理后,中文 "Python教程" 被正确转义为 Python%E6%95%99%E7%A8%8B,特殊符号 & 也被转义为 %26,从而确保参数原汁原味地被服务端接收。
三、自定义请求头 (Headers) 伪装与 Request 对象
默认情况下,如果直接向 urlopen 传入字符串类型的 URL,urllib 会在发送底层 TCP 数据包时附带默认的 User-Agent 标头:Python-urllib/3.x。许多网站与 API 服务器出于安全防护或防爬考虑,会直接阻断此类请求并返回 403 Forbidden。
为了向请求中添加自定义的 HTTP 请求头(如伪装浏览器 User-Agent 或携带身份令牌 Authorization),需要使用 urllib.request.Request 类来显式构建请求对象。
构建带有自定义 Headers 的 GET 请求完整代码如下:
import urllib.request
import urllib.parse

target_url = "https://httpbin.org/headers"

# 1. 准备请求头字典
custom_headers = {
    # 模拟标准现代浏览器标头
    "User-Agent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/120.0.0.0 Safari/537.36",
    "Accept": "application/json, text/plain, */*",
    "Accept-Language": "zh-CN,zh;q=0.9,en;q=0.8"
}

# 2. 构造 Request 对象(注意:不要传 data 参数,传 data 会让 urllib 转为 POST 请求)
req = urllib.request.Request(url=target_url, headers=custom_headers)

# 3. 将 Request 对象交由 urlopen 执行
with urllib.request.urlopen(req) as response:
    body = response.read().decode('utf-8')
    print("服务器端实际收到的标头内容:")
print(body)urllib.request.Request 类的构造函数同时包含 url、data、headers 等参数。在发送 GET 请求时,千万不要给 data 参数传值(保持其为默认值 None)。一旦向 data 传递了字节数据,urllib 将自动把 HTTP 方法切换为 POST。
四、设置超时时间与异常分层捕获
在任何需要实际运行的代码中,发起网络请求都必须做好两件事:必须设置超时与必须捕获网络异常。
若在调用 urlopen() 时省略 timeout 参数,Python 将使用操作系统的全局套接字默认超时(可能长达数分钟甚至永久挂起)。一旦目标服务器宕机或发生路由死循环,程序主线程将被彻底卡死。
此外,urllib.error 提供了两层主要的异常类型:
urllib.error.HTTPError:当服务器能够正常建立连接,但返回了4xx(客户端错误,如 403、404)或5xx(服务器故障,如 500、502)状态码时抛出。该异常本身就是一个特殊的响应对象,包含了e.code(状态码)与e.read()(错误详情)。urllib.error.URLError:当底层网络根本无法建立通信时抛出,例如目标域名 DNS 解析失败、网络断开或请求超时。HTTPError是URLError的子类。
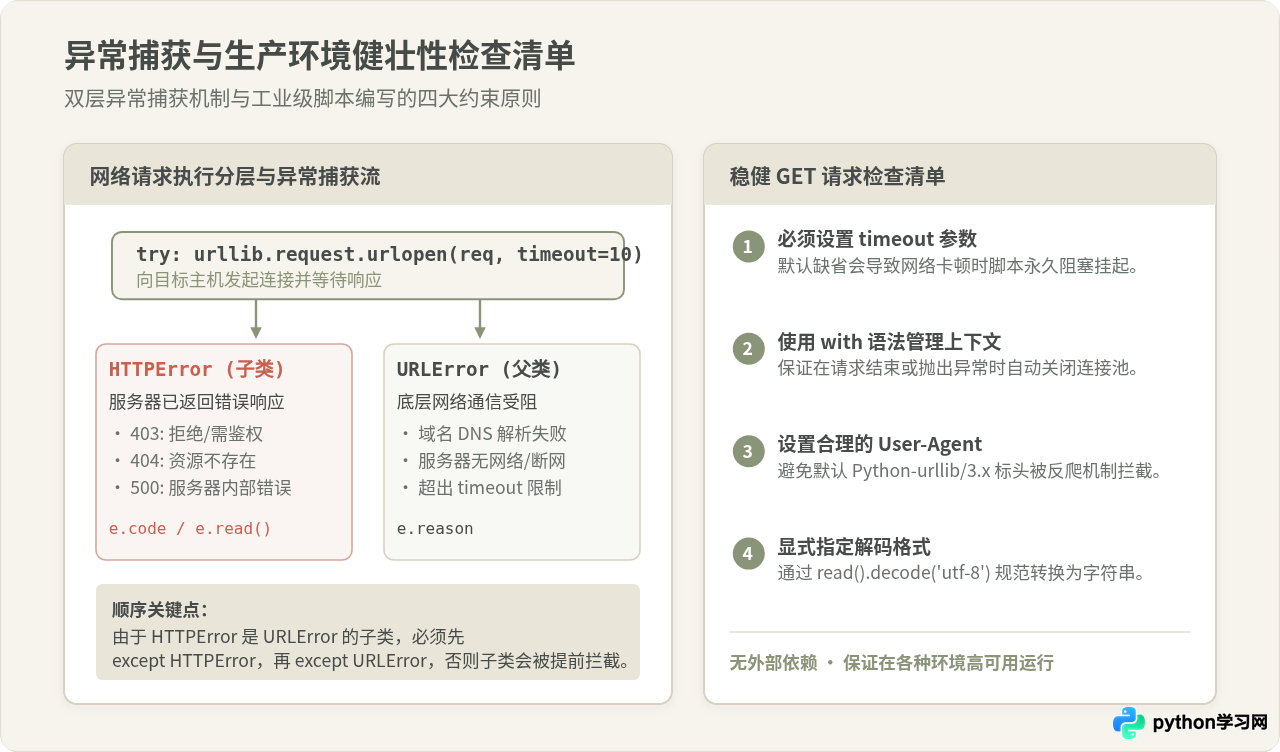
下面是一份包含双层异常捕获与超时控制的工业级完整范例:
import urllib.request
import urllib.parse
import urllib.error
import socket

def safe_get_request(url: str, params: dict = None, timeout: int = 10):
    # 1. 处理查询参数
    if params:
        query_string = urllib.parse.urlencode(params)
        separator = '&' if '?' in url else '?'
        url = f"{url}{separator}{query_string}"

    # 2. 封装 Request 对象
    headers = {
        "User-Agent": "Mozilla/5.0 (compatible; Python-Standard-Urllib/3.x)"
    }
    req = urllib.request.Request(url=url, headers=headers)

    # 3. 带超时与异常分层处理
    try:
        with urllib.request.urlopen(req, timeout=timeout) as response:
            status = response.status
            encoding = response.headers.get_content_charset() or 'utf-8'
            body = response.read().decode(encoding)
            return {"success": True, "status": status, "data": body}

    except urllib.error.HTTPError as e:
        # 先捕获子类 HTTPError: 服务器返回了 4xx/5xx
        error_msg = e.read().decode('utf-8', errors='replace')
        return {"success": False, "error_type": "HTTPError", "code": e.code, "reason": e.reason, "body": error_msg}

    except urllib.error.URLError as e:
        # 再捕获父类 URLError: DNS错误、断网或超时
        if isinstance(e.reason, socket.timeout):
            reason_text = "网络请求超时"
        else:
            reason_text = str(e.reason)
        return {"success": False, "error_type": "URLError", "reason": reason_text}

# 测试调用正常接口
res_ok = safe_get_request("https://httpbin.org/get", params={"status": "ok"})
print("正常请求结果:", res_ok["success"], "HTTP状态码:", res_ok.get("status"))

# 测试捕获 404 状态码
res_404 = safe_get_request("https://httpbin.org/status/404")
print("404 请求结果:", res_404["success"], "状态码:", res_404.get("code"))404 请求结果: False 状态码: 404
五、标准库 urllib 与 requests 的核心差异对比
为了帮助你在具体项目中选择最恰当的技术路线,下表梳理了 urllib 与第三方库 requests 在典型特性上的直观区别:
| 特性维度 | Python 标准库 urllib | 第三方库 requests |
|---|---|---|
| 安装依赖 | 完全内置,开箱即用,无需 pip 安装 | 需运行 pip install requests |
| 查询参数处理 | 需手动调用 urllib.parse.urlencode 序列化 |
支持向 params 参数直接传入字典 |
| 响应体编码解码 | 返回 bytes,需手动 .decode('utf-8') |
response.text 自动推断编码还原字符串 |
| JSON 数据解析 | 需结合 import json; json.loads(...) 解析 |
原生集成 response.json() 方法 |
| 状态码非 200 行为 | 抛出 HTTPError 异常(需在 try-except 中捕获) |
直接保存在 status_code,不主动中断流程 |
| 连接池与复用 | 单次连接默认随连接对象释放,复用较复杂 | 默认通过 Session 维护底层持久连接池 |
| 适用场景 | 基础系统工具、无外网权限环境、微型自动化脚本 | 复杂业务开发、爬虫工程、大型分布式系统 |
六、总结与开发备忘清单
使用 Python 标准库 urllib 发送 GET 请求虽然在语法上略显冗长,但它具有零依赖、强便携、原生随 Python 解释器分发的无可替代的优势。只要严格遵守以下四条核心准则,就能写出高可用、高稳定的网络交互代码:
- 字典参数务必编码:所有 URL 动态参数统一使用
urllib.parse.urlencode()转换为安全 ASCII 串,避免编码歧义与报错。 - 伪装 User-Agent:涉及外部公网接口时,优先通过
urllib.request.Request显式指定浏览器头,防止被对端网关直接拒绝。 - 设定超时防挂起:调用
urlopen(req, timeout=...)时务必显式指定超时秒数,避免脚本陷入永久阻塞。 - 双层异常捕获:先捕获具体的
HTTPError获取服务端的错误状态与内容,再捕获父级URLError兜底底层连接或 DNS 故障。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









