

Python标准库常用模块详解:从文件处理到网络请求的最佳实践

很多工程任务在受限运行环境(如容器镜像轻量化、内网安全沙箱或紧急维护脚本)中,无法自由安装 pip 第三方扩展。Python 素以“自带电池”(Batteries Included)著称,其原生标准库历经数十次版本演进,早已具备处理严苛工业场景的坚实能力。从基于面向对象范式的路径操作,到高防御性的子进程调度,再到无依赖的原生 HTTP 管道,掌握标准库不仅是摆脱依赖膨胀的捷径,也是写出高性能、强韧性 Python 程序的必修内功。
一、现代文件与路径工程:全面转向 pathlib 与 shutil
在 Python 3.4 之前,文件路径处理高度依赖 os.path,代码中充斥着割裂的字符串拼接、平台斜杠转义和凌乱的判断语句。现代 Python 最佳实践要求全面迁移到面向对象的 pathlib 模块,辅以 shutil 处理高阶目录归档与复制。
1.1 面向对象路径操作与安全读写
pathlib.Path 将操作系统差异封装在对象内部,通过 / 运算符直接实现符合 POSIX 与 Windows 规范的语义拼接。更关键的是,它直接集成了文本与二进制读写方法,省去了手动 open() 上下文的冗余代码,并要求开发者明确指定编码。
from pathlib import Path

# 构造基准路径并确保其绝对化
base_dir = Path("./workspace").resolve()
target_file = base_dir / "logs" / "audit.json"

# 自动递归创建多层父级目录,防并发竞争
target_file.parent.mkdir(parents=True, exist_ok=True)

# 显式指定 UTF-8 编码写入内容
target_file.write_text('{"status": "initialized"}', encoding="utf-8")

# 文本读取与属性探查
if target_file.is_file():
    content = target_file.read_text(encoding="utf-8")
    file_size = target_file.stat().st_size
    print(f"读取成功,大小: {file_size} 字节,内容: {content}")
1.2 生产级原子写入模式
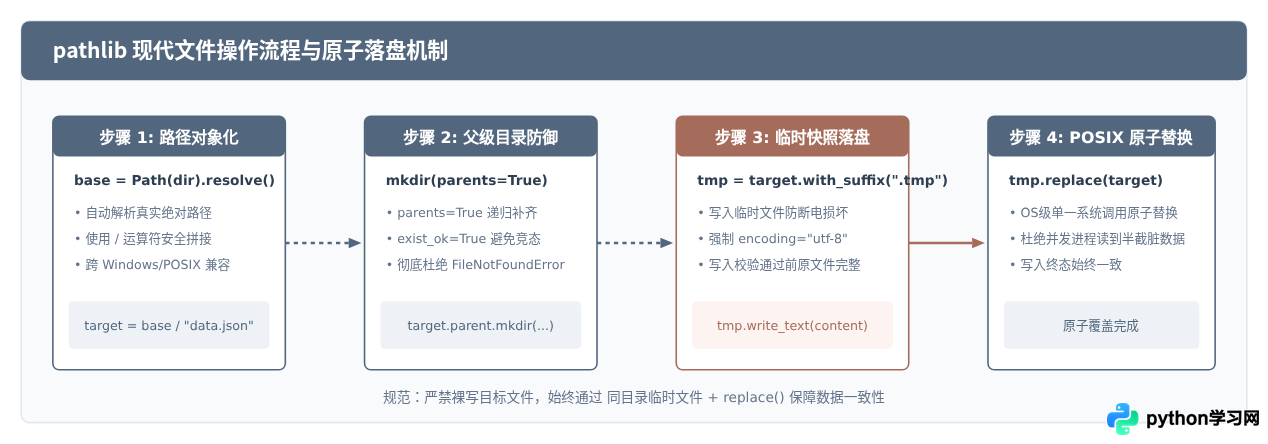
直接对生产环境的关键文件调用 write_text() 存在隐患:如果写入过程中程序崩溃或系统断电,目标文件会被截断为空或损坏。利用同目录下的临时文件结合 Path.replace(),可以利用操作系统的底层原子重命名特性,确保目标文件要么完整更新,要么保持原状。
二、结构化数据序列化:json 模块的高可靠性处理
处理本地配置或 API 载荷时,json 模块是使用频率最高的工具。然而,常见代码中往往忽略了中文转义破坏可读性、非标准键类型反序列化失败以及大文件内存爆仓的问题。
2.1 防御性 json 序列化范式
在导出 JSON 数据时,务必将 ensure_ascii 设为 False,否则所有中文字符都会被转义为 \uXXXX 形式,增加体积并降低排查排障效率。此外,针对可能出现非原生类型的场景,应当使用 default 处理器兜底。
import json
from datetime import datetime
from pathlib import Path

def safe_json_serializer(obj):
    """兜底日期与路径对象的序列化"""
    if isinstance(obj, datetime):
        return obj.isoformat()
    if isinstance(obj, Path):
        return str(obj)
    raise TypeError(f"无法序列化类型: {type(obj)}")

payload = {
    "project": "自动化脚本引擎",
    "timestamp": datetime.now(),
    "config_path": Path("/etc/app/conf.d"),
    "retry_limit": 3
}

# 格式化输出:关闭 ascii 强制转义,保持紧凑或缩进对齐
json_str = json.dumps(
    payload,
    ensure_ascii=False,
    indent=2,
    default=safe_json_serializer
)
三、系统调用与子进程管理:subprocess 的安全边界
当标准库功能不足以覆盖某些底层能力(如调用 git、系统 tar、或硬件探针命令)时,很多初学者习惯使用过时的 os.system() 或 os.popen()。这是严重的工程隐患,极易导致 Shell 注入攻击或子进程僵死。
3.1 subprocess.run 的现代标准规范
生产环境调用外部命令,应唯一指定使用 subprocess.run()。牢记三大红线原则:
- 严禁
shell=True:参数必须以列表传递(如["git", "status", "-s"]),杜绝拼接字符串导致的指令注入。 - 强制配置
timeout:子进程挂起或等待交互输入时,防止主程序永久卡死。 - 显式接管流与编码:设置
capture_output=True与text=True(或encoding="utf-8"),以便在内存中直接获取解码后的字符串。
import subprocess

def execute_system_task(command_args: list[str], timeout_sec: int = 15) -> str:
    """安全执行外部命令并返回标准化 stdout"""
    try:
        result = subprocess.run(
            command_args,
            shell=False,               # 防注入:禁用 shell 解析
            capture_output=True,       # 捕获 stdout 与 stderr
            text=True,                 # 自动使用系统默认文本编码解码
            encoding="utf-8",          # 明确 UTF-8 避免 Windows GBK 乱码
            timeout=timeout_sec,       # 设定超时强杀窗口
            check=True                 # 状态码非零自动抛出 CalledProcessError
        )
        return result.stdout.strip()
    except subprocess.TimeoutExpired as e:
        # 超时处理:进程已被自动终止
        raise RuntimeError(f"命令执行超时(限制 {timeout_sec} 秒): {command_args}") from e
    except subprocess.CalledProcessError as e:
        # 错误码非零处理:提取 stderr 精确定位
        err_msg = e.stderr.strip() if e.stderr else "无详细错误输出"
        raise RuntimeError(f"命令失败 (退出码 {e.returncode}): {err_msg}") from e
    except FileNotFoundError as e:
        # 二进制可执行文件不存在
        raise RuntimeError(f"未找到可执行程序: {command_args[0]}") from e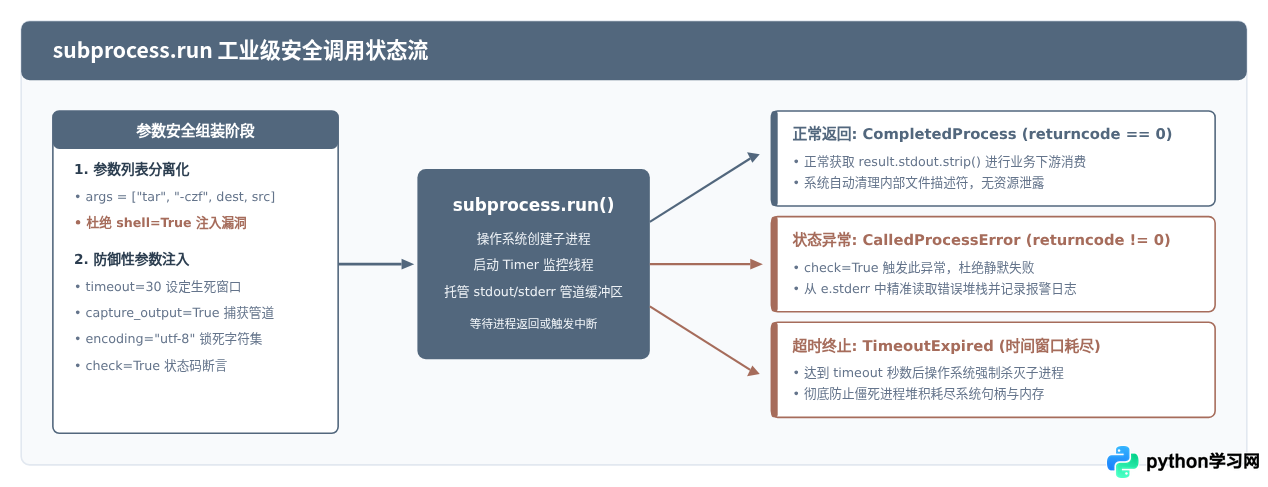
四、网络通信与 API 交互:urllib.request 健壮工程实践
虽然社区广泛推崇 requests 或 httpx,但在无外网访问的基础镜像、内网安全合规流水线以及自包含部署脚本中,标准库的 urllib 依然是唯一合法的依赖项。掌握 urllib.request 与 urllib.parse 的深层用法,是编写自给自足脚本的核心能力。
4.1 构建专业 HTTP 请求载荷
默认情况下,urllib.request.urlopen("url") 会携带类似 Python-urllib/3.x 的 User-Agent 头,绝大多数反爬网关与 WAF 都会直接拦截此类请求并返回 403 Forbidden。此外,默认情况下该调用没有超时限制,网络波动时会导致线程无限等待。
import json
from urllib.request import Request, urlopen
from urllib.error import HTTPError, URLError
from urllib.parse import urlencode

def safe_http_fetch(url: str, params: dict = None, timeout: int = 10) -> dict:
    """基于 urllib 的工业级防御性 GET 请求函数"""

    # 1. 规范拼接 Query 字符串
    if params:
        query_string = urlencode(params)
        url = f"{url}?{query_string}" if "?" not in url else f"{url}&{query_string}"

    # 2. 伪装标准客户端请求头
    headers = {
        "User-Agent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/120.0.0.0 Safari/537.36",
        "Accept": "application/json, text/plain, */*",
        "Connection": "close"  # 脚本式短连接,避免连接池挂起
    }

    req = Request(url=url, headers=headers, method="GET")

    # 3. 严格捕获双层网络异常
    try:
        with urlopen(req, timeout=timeout) as response:
            status_code = response.status
            # 优先从 Header 提取字符编码,默认降级为 UTF-8
            charset = response.headers.get_content_charset() or "utf-8"
            raw_data = response.read()
            text_data = raw_data.decode(charset)

            if status_code == 200:
                return json.loads(text_data)
            raise RuntimeError(f"非预期响应状态码: {status_code}")

    except HTTPError as e:
        # HTTP 状态码错误 (4xx, 5xx),此时仍可读取服务端返回的 Body
        err_body = e.read().decode("utf-8", errors="replace")
        raise RuntimeError(f"HTTP 服务端响应异常 (状态码 {e.code}): {err_body}") from e
    except URLError as e:
        # 协议、DNS 解析或底层 Socket 超时错误
        raise RuntimeError(f"网络底层通信故障 (原因: {e.reason})") from e
    except TimeoutError as e:
        # 兜底超时捕获
        raise RuntimeError(f"连接或读取超时 (限制 {timeout} 秒)") from e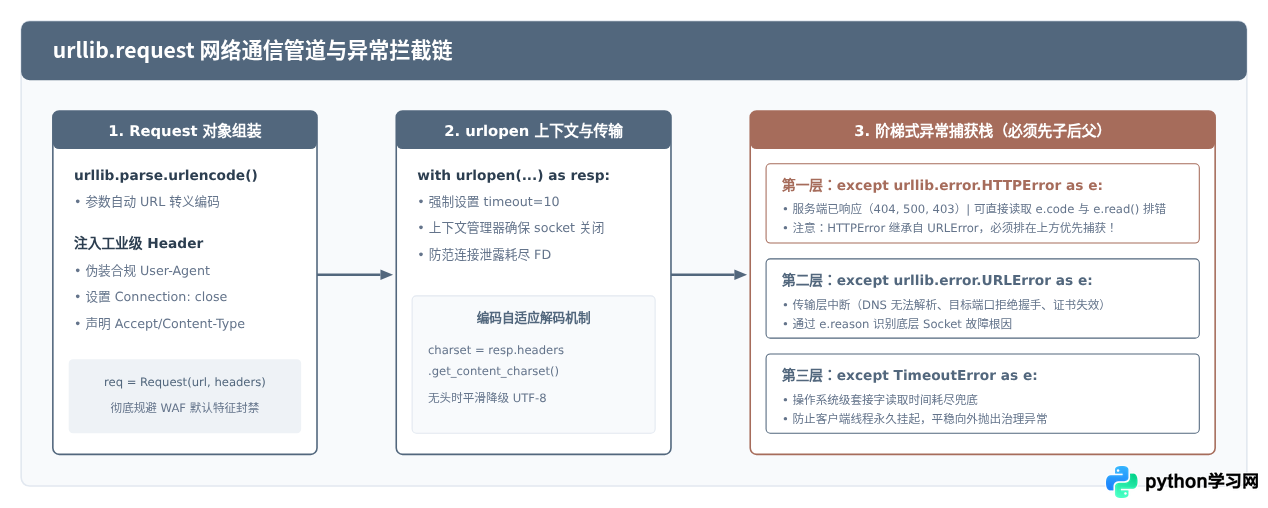
五、端到端最佳实践:从远程下载到本地落盘执行
为了让读者直观理解上述核心模块如何协同工作,以下展示一个无任何第三方库依赖的完整生产运维案例:从内网配置中心拉取一份任务清单,经过安全校验后原子落盘,并调用系统工具执行。
import json
import subprocess
from pathlib import Path
from urllib.request import Request, urlopen
from urllib.error import URLError, HTTPError

def sync_and_execute_task(api_url: str, working_dir: Path) -> None:
    """标准库协同流:网络请求 -> 原子落地 -> 进程调度"""

    # 1. 网络拉取任务元数据
    req = Request(
        api_url,
        headers={"User-Agent": "OpsEngine/1.0", "Accept": "application/json"}
    )

    try:
        with urlopen(req, timeout=10) as resp:
            task_payload = json.loads(resp.read().decode("utf-8"))
    except (HTTPError, URLError) as e:
        print(f"[错误] 无法拉取远程任务: {e}")
        return

    # 2. 本地目录与文件准备
    working_dir.mkdir(parents=True, exist_ok=True)
    target_conf = working_dir / "current_task.json"
    temp_conf = working_dir / "current_task.tmp"

    # 3. 结构化安全写入(原子替换)
    content_str = json.dumps(task_payload, ensure_ascii=False, indent=2)
    temp_conf.write_text(content_str, encoding="utf-8")
    temp_conf.replace(target_conf)
    print(f"[成功] 任务配置已原子落盘至: {target_conf}")

    # 4. 安全调度外部校验程序
    try:
        proc = subprocess.run(
            ["python3", "-m", "json.tool", str(target_conf)],
            capture_output=True,
            text=True,
            timeout=5,
            check=True
        )
        print("[成功] 格式校验通过,下游任务正常激活")
    except subprocess.CalledProcessError as e:
        print(f"[失败] 任务校验异常: {e.stderr}")
    except subprocess.TimeoutExpired:
        print("[超时] 校验任务执行超时被强杀")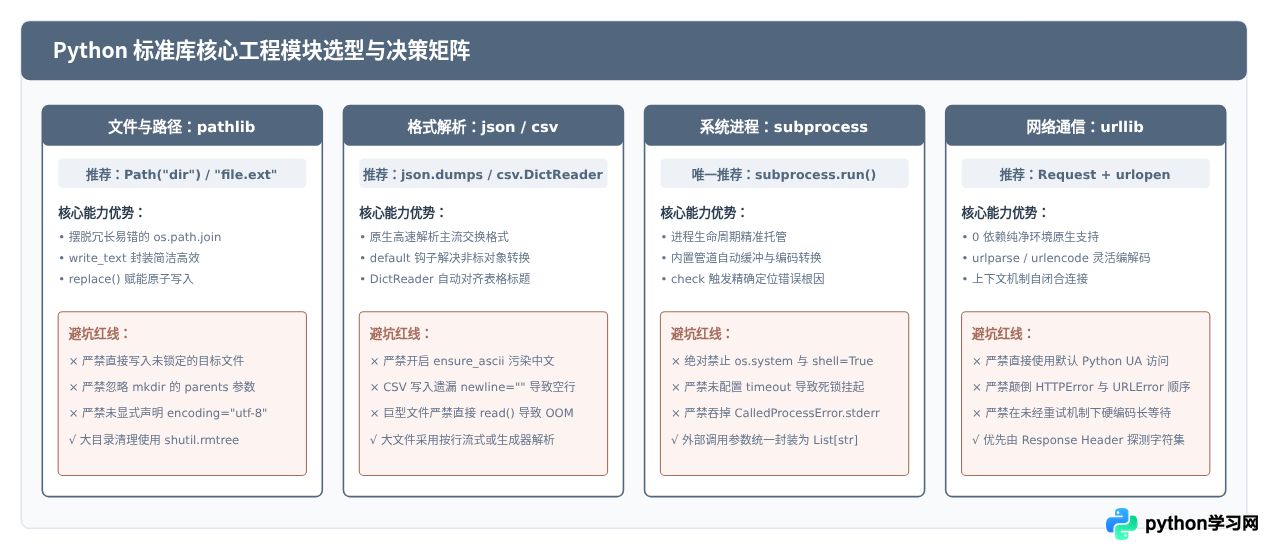
六、标准库高频陷阱与最佳实践备查表
为了在实际编码中快速查阅,以下将常见反模式(Bad Practice)与工业标准范式(Best Practice)进行对照归纳:
| 维度 | 高风险反模式 | 工业级最佳实践 | 收益与核心原因 |
|---|---|---|---|
| 路径拼接 | os.path.join(a, b) 或字符串 f"{a}/{b}" |
Path(a) / b |
跨系统路径规范化,支持链式属性提取与直接读写。 |
| 数据写入 | open("data.txt", "w").write(...) |
Path("data.tmp").write_text(...) 然后 replace() |
POSIX 原子替换,防止写入中断导致数据损坏。 |
| 系统调用 | os.system("rm -rf " + user_input) |
subprocess.run(["rm", "-rf", path], shell=False, timeout=10) |
杜绝 Shell 注入漏洞,避免进程无响应无限卡死。 |
| 网络请求 | urllib.request.urlopen(raw_url) 且无头信息 |
封装 Request、注入 User-Agent、配置 timeout |
防止被服务端 WAF 拦截 403,防御网络震荡挂死主进程。 |
| 字符编码 | 不传 encoding 依赖平台默认值 |
所有文件读写和字节解码显式声明 encoding="utf-8" |
杜绝 Windows 系统在 GBK 编码下的非法字符崩溃。 |
总结:Python 标准库的生命力在于其稳定性和零环境依赖。在业务代码开发中,熟练运用 pathlib、json、subprocess 和 urllib,不仅能在受限环境下迅速建立稳健的基础能力,更能促使开发者站在操作系统底层机制(如文件描述符、POSIX 原子替换、管道缓冲区、套接字超时)的角度去思考工程健壮性。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









