

Python 常用标准库模块分类汇总:os,sys,json,re 核心方法指南
全面解析 Python 开发中最常用的四大内置标准库模块:os、sys、json 与 re。涵盖文件与路径管理、解释器环境交互、结构化数据序列化以及文本正则匹配的核心方法、代码示例与工程避坑指南。
在 Python 开发实践中,并不总是需要引入庞大的第三方依赖包。Python 内置的丰富标准库足以覆盖绝大多数日常任务。其中,os、sys、json 和 re 是使用频次最高、工程应用最广泛的四大基础模块。本文将对这四个模块按职责分类,拆解其核心方法、应用范式与关键边界,帮助开发者构建清晰的标准库调用习惯。
一、四大标准库的架构定位与职责边界
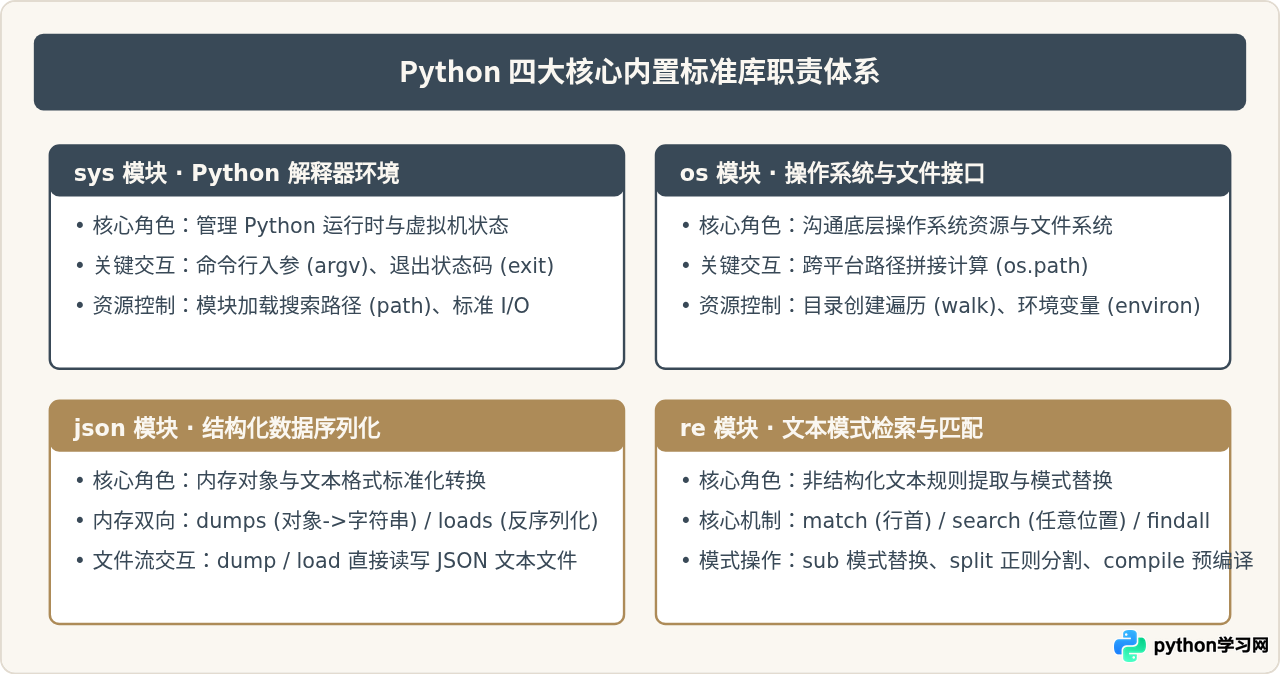
理解标准库的第一步是分清它们各自在系统软件栈中所处的层级。初学者常容易混淆 os 与 sys 的分工,或者在面对文本抽取与数据持久化时难以抉择。简要来说:
- sys 属于“解释器级”,关注 Python 虚拟机本身的运行状态、运行时参数、模块导入路径以及标准输入输出通道;
- os 属于“操作系统级”,直接与底层主机环境对接,涵盖文件路径解析、目录树遍历、环境变量读写及进程控制;
- json 属于“数据格式级”,专注于结构化数据(键值对、数组)在内存对象与文本流之间的跨语言编解码;
- re 属于“文本模式级”,提供基于正则表达式的高性能字符串搜索、模式捕获、替换与语法拆分功能。
二、os 模块:操作系统交互与文件系统管理
os 模块为 Python 提供了与底层系统解耦的统一调用方式。无论在 Windows 还是 Linux、macOS 环境中,编写涉及文件路径与目录操作的代码时,均应优先使用 os 提供的跨平台函数。
1. 路径操作的核心方法(os.path 子模块)
绝对不要使用普通的加号 + 或 f-string 手工拼接文件路径。Windows 使用反斜杠 \,而 POSIX 系统使用正斜杠 /。使用 os.path.join 可以自动补齐或适配系统分隔符。
os.path.join(*paths):根据当前运行系统的规则智能连接一个或多个路径片段;os.path.abspath(path):返回指定路径的绝对规范化路径;os.path.exists(path):判断目标文件或目录是否存在,返回布尔值;os.path.isfile(path)与os.path.isdir(path):精准判断路径究竟是常规文件还是目录;os.path.split(path):将路径切分为目录路径与文件名组成的元组(dirname, basename);os.path.splitext(path):将文件名与其扩展名分离,如('data', '.json')。
import os

# 获取当前脚本所在绝对目录
current_dir = os.path.dirname(os.path.abspath(__file__))
target_file = os.path.join(current_dir, "configs", "app.json")

print("绝对路径:", target_file)
print("文件是否存在:", os.path.exists(target_file))

if os.path.exists(target_file):
    base_name, ext = os.path.splitext(target_file)
    print("文件名:", os.path.basename(target_file))
    print("后缀名:", ext)
2. 目录创建与文件树遍历
在批量处理任务中,动态创建多层目录与递归扫描是常见操作:
os.makedirs(name, exist_ok=False):递归创建目标目录。工程实践中强烈建议显式传入exist_ok=True,以避免在目录已存在或多进程并发创建时抛出FileExistsError;os.listdir(path):返回目标目录下直接包含的所有文件及文件夹名称列表(非递归);os.walk(top):深度优先递归遍历目录树,每次迭代返回三元组(root, dirs, files)。
import os

# 确保多级日志目录存在
log_dir = os.path.join("output", "logs", "daily")
os.makedirs(log_dir, exist_ok=True)

# 递归遍历目录下的全部 .txt 文件
search_root = "./data"
if os.path.exists(search_root):
    for root, dirs, files in os.walk(search_root):
        for file in files:
            if file.endswith(".txt"):
                full_path = os.path.join(root, file)
                print("匹配到文件:", full_path)
3. 环境变量获取与设置
os.environ 是一个映射当前系统环境变量的对象。读取配置时建议使用 os.environ.get("KEY", default) 而非直接下标访问,以防止因键缺失而触发 KeyError 异常。
os.environ 的修改仅影响当前 Python 进程及其随后派生的子进程,不会永久持久化到宿主机操作系统的注册表或环境配置文件中。
三、sys 模块:掌控解释器状态与命令行交互
与 os 面向外部系统不同,sys 模块深入 Python 虚拟机本身。它负责提供程序与解释器通信的窗口。
1. 命令行参数捕获(sys.argv)
sys.argv 是一个字符串列表,包含传递给 Python 脚本的所有命令行参数。其中 sys.argv[0] 恒为当前脚本的名称或完整路径,真正的传参从下标 1 开始。
import sys

# 基础入参检查
if len(sys.argv) < 2:
    print("用法提示: python runner.py <目标任务名>")
    sys.exit(1)

task_name = sys.argv[1]
print(f"正在执行任务: {task_name}")
2. 脚本终止与状态码传递(sys.exit)
sys.exit(code) 用于在任意代码位置安全终止脚本。传入 0 表示程序正常执行完成;传入非零整数(例如 1)表示由于错误提前退出。
sys.exit() 的实质是在内部抛出 SystemExit 异常。这意味着如果你外层使用了宽泛的 try...except BaseException:,该异常会被捕获并导致退出失效。因此业务捕获异常时应限定为 except Exception:。
3. 模块搜索路径(sys.path)
sys.path 是 Python 寻找被导入模块(import xxx)时的目录列表。如果需要在没有安装为全局包的情况下引入自定义子模块,可以通过 sys.path.append() 或 sys.path.insert(0, custom_path) 动态扩展寻址范围。
四、四模块实战:CLI 脚本协同处理流程
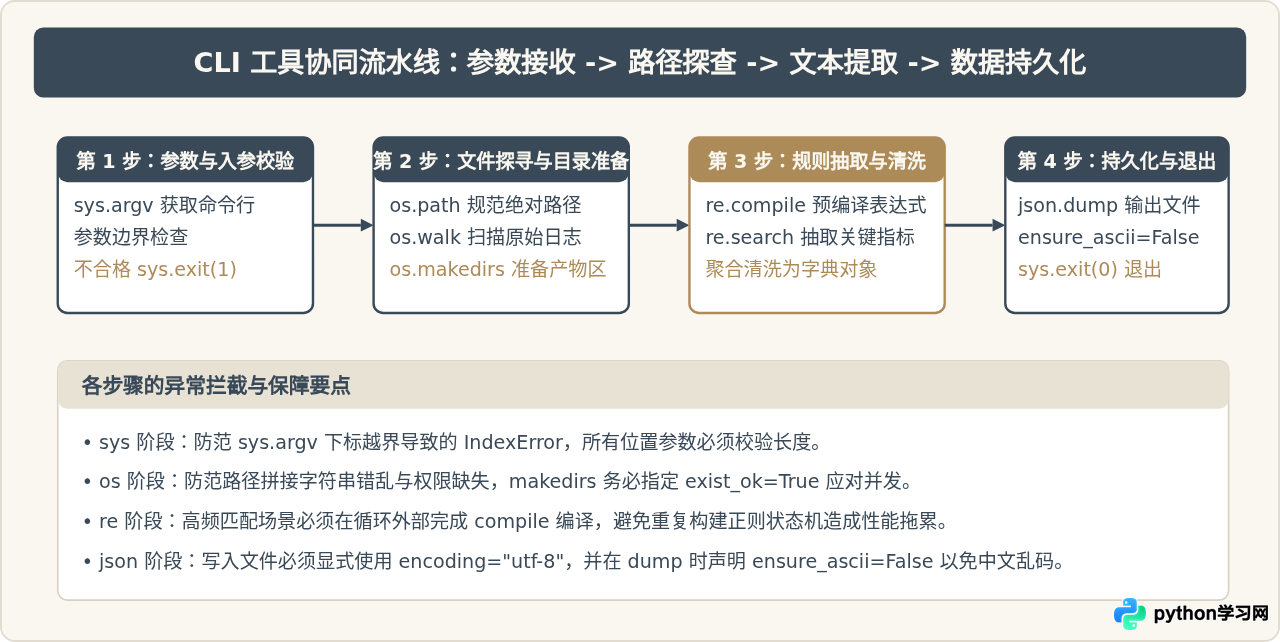
在实际工程项目中,标准库模块很少单独孤立运作,而是按顺序协作形成一条清晰的数据流。下面的流程图展示了一个工业级 Python 自动化工具的标准执行链路:
五、json 模块:数据序列化与持久化交互
JSON 格式是当前网络协议传输与本地配置存储的事实标准。Python 的 json 模块提供了四种操作函数,初学者需要先看清名称末尾是否有带 s:
- 带 s 的函数(dumps / loads):用于字符串(String)与 Python 对象的相互转换,全部在内存中完成;
- 不带 s 的函数(dump / load):用于文件对象(File-like Stream)与 Python 对象的交互,直接读写磁盘。
1. 内存转换操作
import json

user_data = {
    "uid": 10086,
    "username": "张三",
    "is_active": True,
    "tags": ["python", "backend"],
    "profile": None
}

# 序列化为 JSON 字符串
json_str = json.dumps(user_data, ensure_ascii=False, indent=2)
print("JSON 文本输出:")
print(json_str)

# 反序列化回 Python 原生字典
restored_dict = json.loads(json_str)
print("用户状态:", restored_dict["is_active"])
2. 核心参数剖析
在调用 json.dumps() 或 json.dump() 时,以下三个参数对中文和生产格式至关重要:
ensure_ascii=False:默认情况下该值为True,所有的非 ASCII 字符(包括中文字符)都会被转义为\uXXXX形式。在处理中文时,务必设置为False以保留原始中文字符;indent=2或indent=4:控制缩进空格数,美化排版,便于人类查看排查;sort_keys=True:强制按字典键的字母顺序排序输出,这在生成哈希比对校验时极其有用。
3. 直接读写文件流
import json

# 直接写入文件
config = {"env": "production", "workers": 4, "timeout": 30}
with open("config.json", "w", encoding="utf-8") as f:
    json.dump(config, f, indent=2, ensure_ascii=False)

# 直接从文件读取
with open("config.json", "r", encoding="utf-8") as f:
    loaded_config = json.load(f)
print("超时时间配置:", loaded_config["timeout"])
六、re 模块:正则表达式与文本模式处理
re 模块封装了底层正则匹配引擎。处理复杂格式、日志分析或文本提取时,正则往往是效率最高的利器。
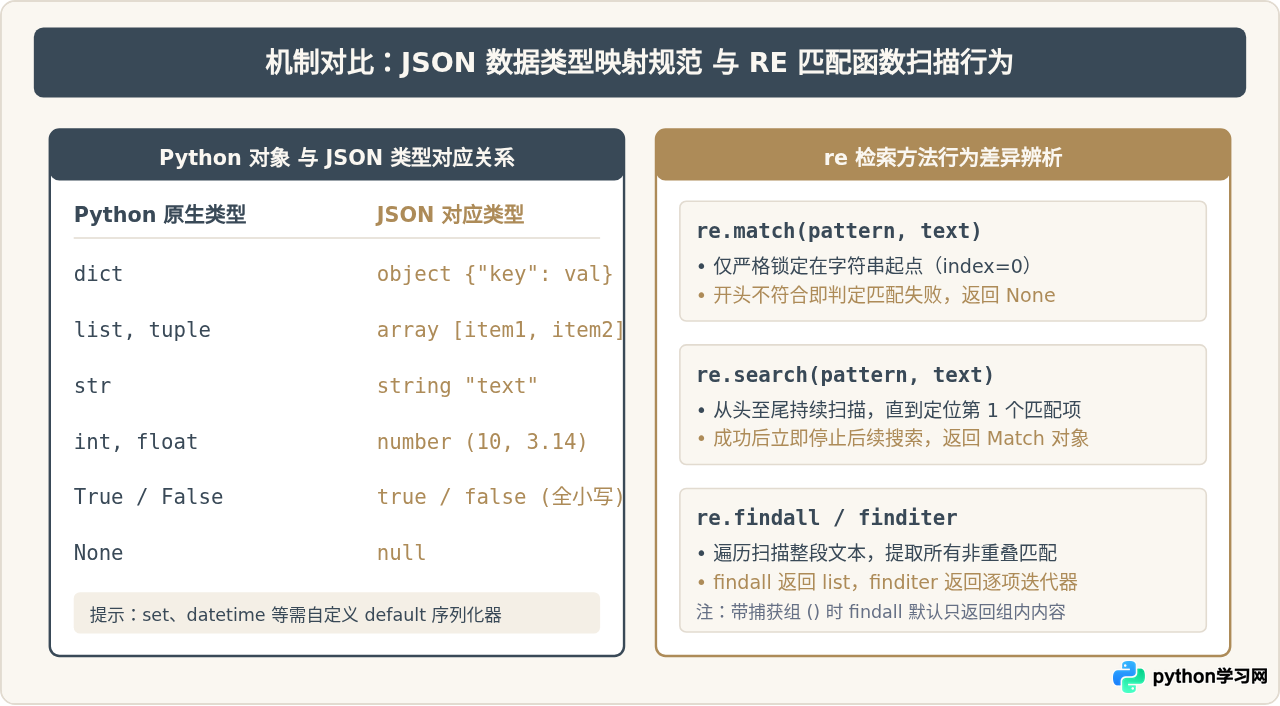
1. 匹配函数辨析:match、search 与 findall
这三者在匹配策略上存在关键差异:
re.match(pattern, string):仅从字符串的开头位置开始匹配。即使目标子串在第 2 个字符出现,若开头不匹配也会立刻返回None;re.search(pattern, string):扫描整个字符串,返回找到的第一个匹配结果(Match 对象),找不到则返回None;re.findall(pattern, string):扫描整个字符串,以字符串列表形式返回所有非重叠匹配项;re.finditer(pattern, string):以迭代器方式返回所有 Match 对象,在大文本流中内存占用更低。
import re

text = "Error Code 404: Page Not Found, Retry in 30s. Code 500: Server Error."

# match 尝试从头匹配(开头是 Error,匹配数字将失败)
m = re.match(r"\d+", text)
print("match 结果:", m)  # None

# search 寻找第一个出现的连续数字
s = re.search(r"\d+", text)
if s:
    print("search 捕获:", s.group())  # 404

# findall 捕获全文所有连续数字
all_numbers = re.findall(r"\d+", text)
print("findall 列表:", all_numbers)  # ['404', '30', '500']
2. 高性能预编译(re.compile)与命名捕获组
如果在密集循环、网络爬虫遍历或千万级日志分析中使用正则表达式,每次调用 re.search() 都会触发内部的模式字符串解析与状态机编译。提前通过 re.compile() 构建 Pattern 对象能显著削减 CPU 开销。
import re

# 预编译日志行解析规则,使用命名捕获组 (?P<name>...)
LOG_PATTERN = re.compile(r"^\[(?P<level>\w+)\]\s+(?P<ip>\d+\.\d+\.\d+\.\d+)\s+-\s+(?P<msg>.*)$")

log_line = "[INFO] 192.168.1.100 - 用户登录成功"
match = LOG_PATTERN.search(log_line)

if match:
    # 提取命名组
    data = match.groupdict()
    print("日志级别:", data["level"])
    print("来源IP:", data["ip"])
    print("正文内容:", data["msg"])
3. 模式替换与正则拆分(re.sub 与 re.split)
内置的 str.replace() 只能做精确子串替换,而 re.sub(pattern, repl, string) 允许基于动态规则进行批量脱敏或重构;re.split(pattern, string) 则支持按多种空白符或复合标点对文本进行切片。
import re

# 手机号码脱敏替换:保留前3后4,中间4位替换为 ****
raw_phone = "客服联系电话:13812345678 与 13987654321"
masked = re.sub(r"(\d{3})\d{4}(\d{4})", r"\1****\2", raw_phone)
print("脱敏结果:", masked)

# 多种标点符号混合切分句子
text = "苹果,香蕉;橘子 葡萄,芒果"
items = re.split(r"[,;,\s]+", text)
print("切分后列表:", items)
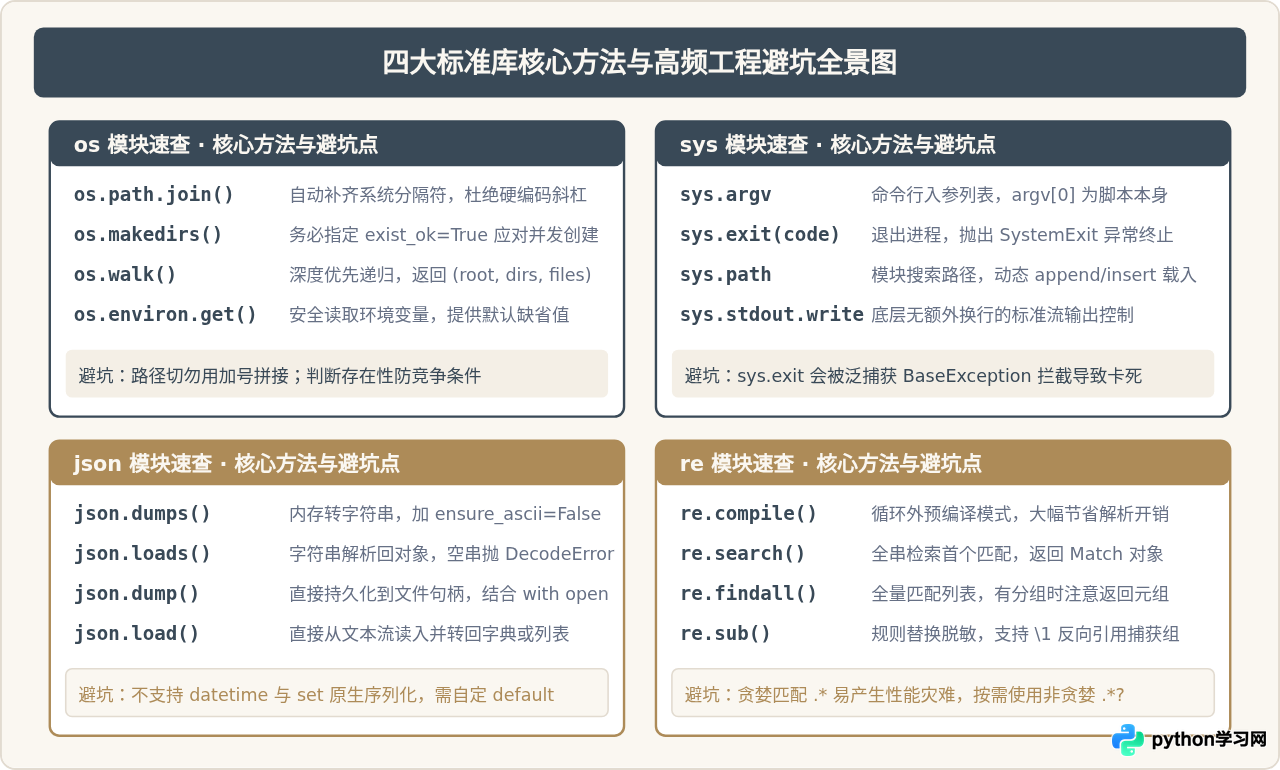
七、核心方法速查矩阵与避坑汇总
为了帮助开发者在编码时快速查阅四者的关键方法及其参数规范,特将四大标准库高频方法提炼如下表:
| 模块名 | 核心方法 / 属性 | 推荐调用模式 | 避坑防错要点 |
|---|---|---|---|
| os | os.path.join() |
os.path.join(base_dir, "file.txt") |
杜绝使用 + 拼接,兼容 Windows 与 POSIX |
os.makedirs() |
os.makedirs(dir_path, exist_ok=True) |
必须加 exist_ok=True 避免已存在报错 |
|
os.walk() |
for r, d, f in os.walk(root): |
深度优先遍历整个目录树,适用于递归扫描 | |
| sys | sys.argv |
if len(sys.argv) > 1: ... |
防范 IndexError,下标 0 为自身脚本名 |
sys.exit() |
sys.exit(0) 或 sys.exit(1) |
触发 SystemExit 异常退出,非普通 return |
|
sys.path |
sys.path.insert(0, pkg_path) |
修改模块搜索路径,生命周期仅限于当前进程 | |
| json | json.dumps() |
json.dumps(d, ensure_ascii=False) |
处理中文必须置 ensure_ascii=False |
json.loads() |
json.loads(text) |
入参为空字符串时会抛出 JSONDecodeError |
|
json.dump() / load() |
json.dump(data, f, indent=2) |
需在 open(..., encoding="utf-8") 语境下使用 |
|
| re | re.search() |
m = re.search(pat, text) |
提取单处匹配,取值前需判断 if m: |
re.findall() |
res = re.findall(pat, text) |
若包含括号分组,仅提取分组;不包含时返回整串 | |
re.compile() |
P = re.compile(pat) |
在循环外部提前编译,减少高频正则构建开销 |
八、总结
os、sys、json 和 re 共同构成了 Python 编写自动化脚本、后台服务与运维工具的坚实基础。熟练掌握这四个模块的本质在于建立“体系化协作思维”:以 sys 控制入口与出口,用 os 稳健调度文件与系统资源,借助 re 完成非结构化文本的清洗提取,最后通过 json 实现跨系统的数据标准化交互。在编写代码时,注重跨平台兼容性、正确处理异常边界与编码细节,就能编写出无需冗余依赖、健壮且高效的 Python 工程脚本。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









