

Python嵌套字典怎么遍历?递归处理多层数据
详细讲解在Python中如何使用递归遍历多层嵌套字典,涵盖基础键值提取、完整路径拼接、列表混合嵌套处理以及防止死循环的避坑指南。
在处理接口返回的 JSON、解析复杂的配置文件或统计多维数据时,字典中嵌套字典是极为常见的数据形态。当嵌套深度不固定时,常规的单层或固定循环无法满足需求;而使用“递归”模式,只要当前节点仍为字典就继续向深层推进,遇到具体数据即完成收集,是遍历多层结构最清晰、通用的解法。
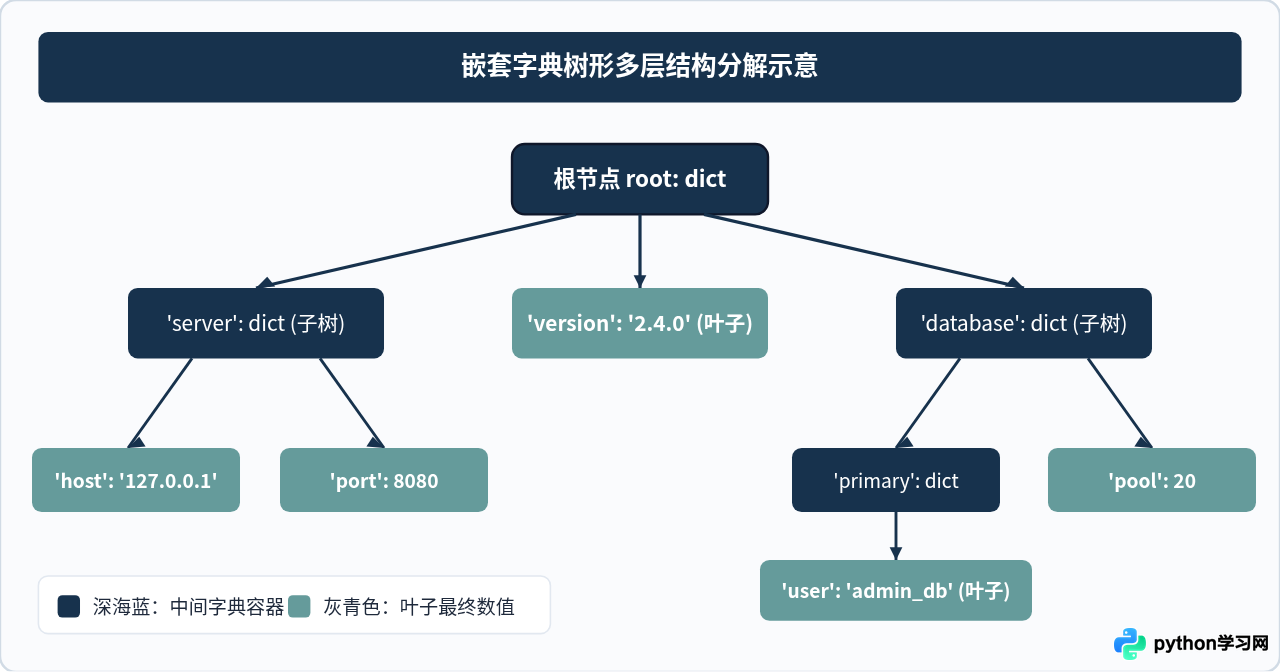
一、理解嵌套字典的树形结构
嵌套字典本质上是一个“多叉树”。最外层是根节点,字典的键充当分支,而对应的值可能是另一个字典(子树节点),也可能是字符串、整数等具体数据(叶子节点)。如果使用双重或三重 for 循环硬编码访问,不仅代码难以维护,而且一旦数据层级动态增加,程序就会漏掉深层内容。
递归遍历的核心逻辑十分简单:定义一个函数接收当前字典,遍历它的每一个键值对;检查当前值是否为字典类型——如果是,就再次调用该函数去处理这个值;如果不是,说明已经到达叶子节点,执行取值或打印操作。
二、基础递归遍历:提取所有叶子节点
最直接的需求是访问多层字典里的每一个键值。我们使用 isinstance(value, dict) 区分分支节点与叶子节点:
# 示例多层字典
nested_data = {
    "server": {
        "host": "127.0.0.1",
        "port": 8080
    },
    "version": "2.4.0",
    "database": {
        "primary": {
            "user": "admin_db"
        },
        "pool": 20
    }
}

def walk_dict(data):
    """基础递归遍历:遇到字典则下钻,遇到数值则打印"""
    for key, value in data.items():
        if isinstance(value, dict):
            # 发现嵌套字典,递归调用自身
            walk_dict(value)
        else:
            # 基准情况:到达叶子节点
            print(f"键: {key:10} | 值: {value}")

# 执行遍历
walk_dict(nested_data)
运行该函数的输出示例:
键: host       | 值: 127.0.0.1
键: port       | 值: 8080
键: version    | 值: 2.4.0
键: user       | 值: admin_db
键: pool       | 值: 20
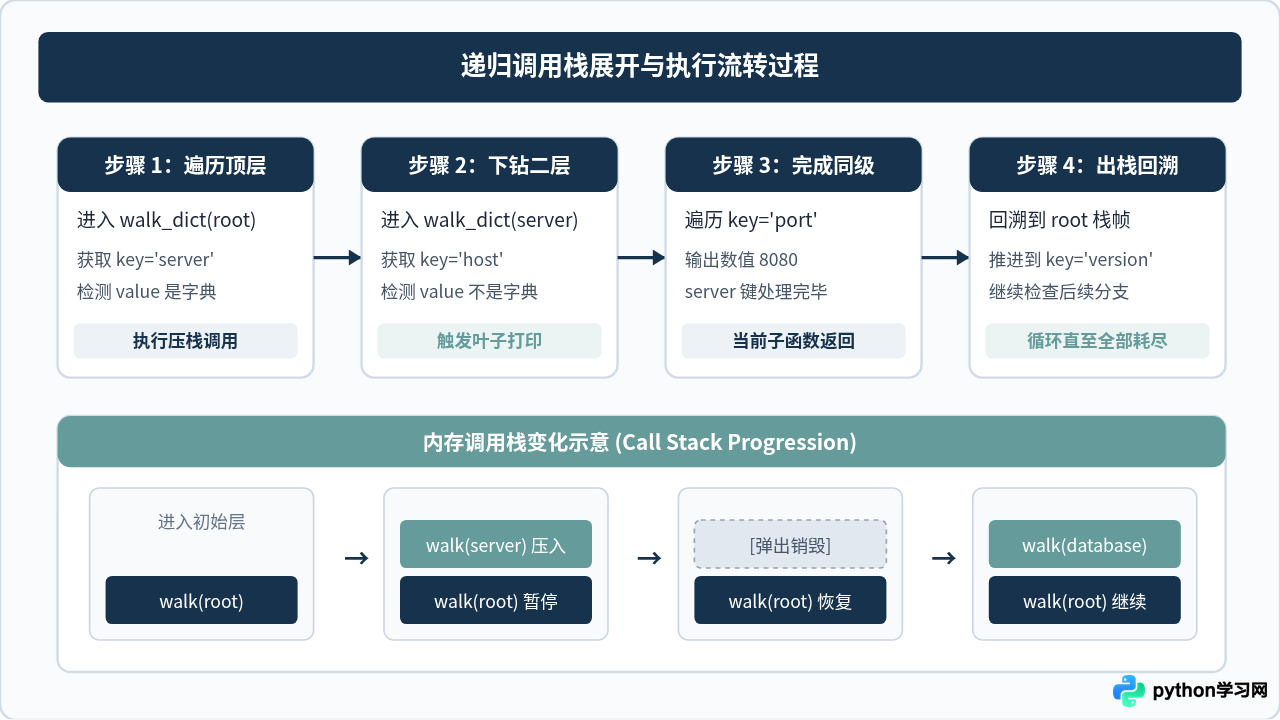
代码要点说明:
- 终止条件(Base Case): 当
value不是字典时,代码不触发递归,直接输出并返回上一层循环。 - 递归步骤(Recursive Step): 当
value是字典时,程序将当前函数的局部状态保存在调用栈中,转而进入子字典。
三、进阶场景一:保留完整键路径并扁平化数据
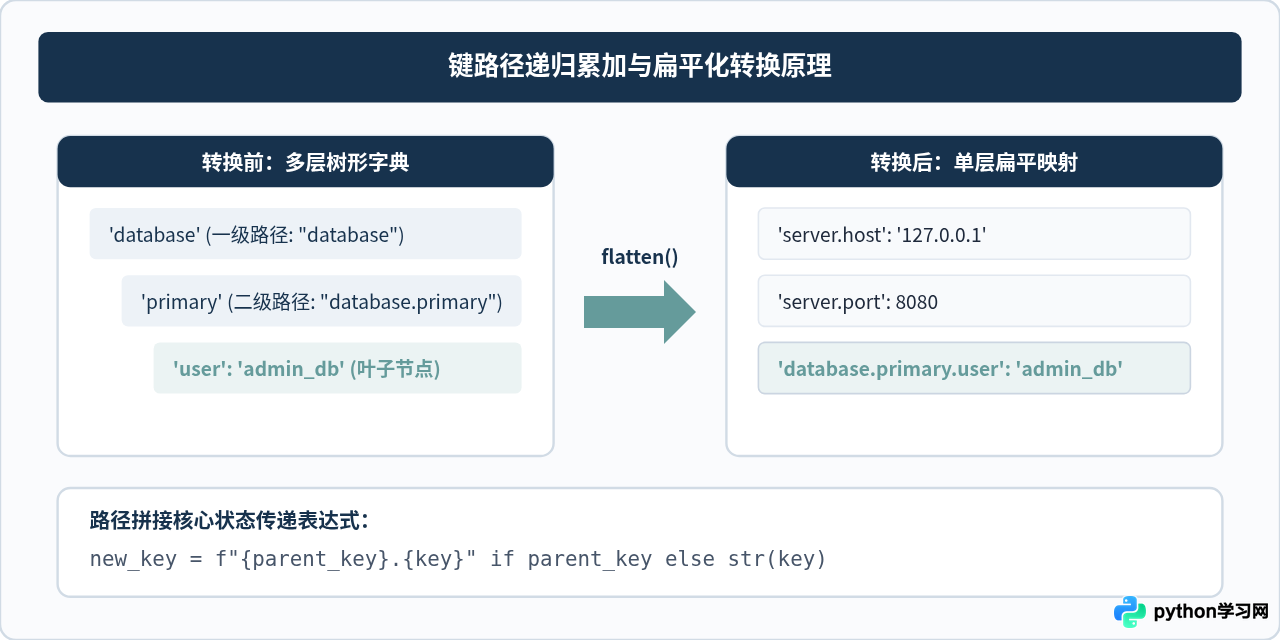
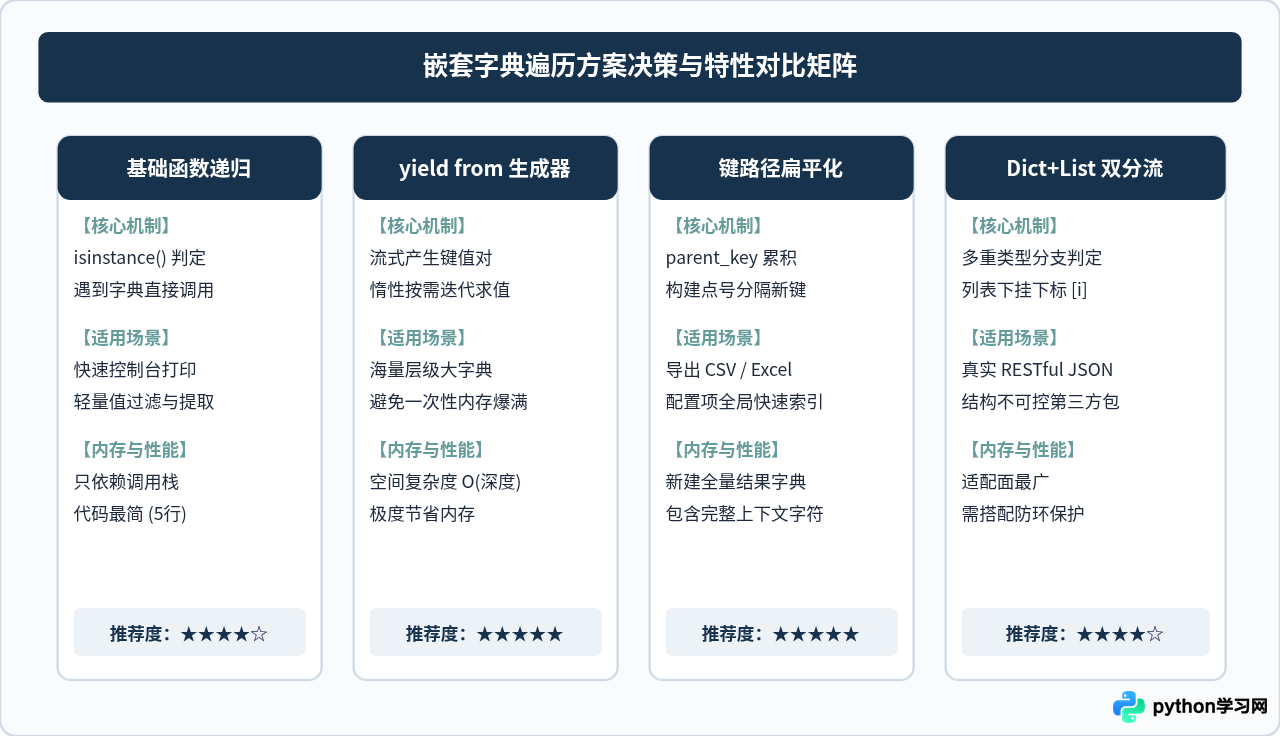
单纯打印叶子节点往往不够。例如在解析配置或转存到扁平表格时,常常需要完整追溯层级路径,例如将 {"server": {"host": "127.0.0.1"}} 转换为 "server.host": "127.0.0.1"。这可以通过在递归时传递累加的 parent_key 实现。
def flatten_dict(data, parent_key="", sep="."):
    """递归将多层嵌套字典扁平化为一层字典"""
    items = {}
    for key, value in data.items():
        # 如果存在父路径则使用连接符拼接,否则为当前键名
        new_key = f"{parent_key}{sep}{key}" if parent_key else str(key)

        if isinstance(value, dict):
            # 递归调用深层字典,将返回的字典合并到当前结果集
            items.update(flatten_dict(value, parent_key=new_key, sep=sep))
        else:
            items[new_key] = value

    return items

# 测试扁平化
flat_result = flatten_dict(nested_data)
for path, val in flat_result.items():
    print(f"{path} = {val}")
扁平化后的输出结果清晰直观:
server.host = 127.0.0.1
server.port = 8080
version = 2.4.0
database.primary.user = admin_db
database.pool = 20
四、进阶场景二:处理包含列表的混合复杂结构
真实生产环境的 JSON 数据往往不仅包含字典,还夹杂着列表(list)。例如一个用户配置可能包含 "roles": [{"name": "admin"}, {"name": "editor"}]。此时递归函数必须具备“分流能力”,同时处理 dict 与 list 两种容器类型:
def walk_nested_data(data, path=""):
    """兼容字典与列表的通用多层递归遍历"""
    if isinstance(data, dict):
        for key, value in data.items():
            new_path = f"{path}.{key}" if path else str(key)
            walk_nested_data(value, new_path)
    elif isinstance(data, list):
        for index, item in enumerate(data):
            # 将列表索引以 [0]、[1] 形式拼接到当前路径中
            new_path = f"{path}[{index}]"
            walk_nested_data(item, new_path)
    else:
        # 叶子节点
        print(f"{path} => {data}")

# 混合数据测试
complex_payload = {
    "app": "portal",
    "cluster": [
        {"node": "alpha", "ip": "10.0.0.1"},
        {"node": "beta",  "ip": "10.0.0.2"}
    ]
}

walk_nested_data(complex_payload)
输出示例明确呈现了列表下标:
app => portal
cluster[0].node => alpha
cluster[0].ip => 10.0.0.1
cluster[1].node => beta
cluster[1].ip => 10.0.0.2
五、实战注意事项与常见陷阱
Python 字典允许将自身或上级对象作为值赋值给下属键(例如 a["child"] = a)。若直接递归遍历,会导致无限循环并抛出 RecursionError: maximum recursion depth exceeded。
防范方法: 引入一个 seen = set() 集合,记录已访问字典的唯一内存标识 id(obj)。每次进入子字典前检查其是否已在集合中。
def safe_walk_dict(data, seen=None):
    """带循环引用保护的安全遍历"""
    if seen is None:
        seen = set()

    dict_id = id(data)
    if dict_id in seen:
        print(f"[跳过] 检测到循环引用,对象 ID: {dict_id}")
        return
    seen.add(dict_id)

    for key, value in data.items():
        if isinstance(value, dict):
            safe_walk_dict(value, seen)
        else:
            print(f"{key}: {value}")
在遍历过程中直接修改原字典(如 del data[k] 或新增键),Python 解释器会抛出 RuntimeError: dictionary changed size during iteration。建议在原地修改时采用 list(data.items()) 制作浅拷贝视图,或构建新的字典返回。
如果嵌套字典庞大,在内存中一次性拼接并返回整个列表或大字典会消耗较多内存。推荐使用生成器配合 yield from 进行按需流式消费:
def iterate_leaf_nodes(data, current_path=()):
    """基于 yield from 的生成器式遍历,内存开销极低"""
    for key, value in data.items():
        path = current_path + (key,)
        if isinstance(value, dict):
            yield from iterate_leaf_nodes(value, path)
        else:
            yield path, value

# 使用生成器迭代
for path_tuple, value in iterate_leaf_nodes(nested_data):
    full_path = ".".join(path_tuple)
    print(f"流式读取 -> {full_path}: {value}")
六、总结
遍历 Python 嵌套字典的精髓在于以“递归”替代“硬编码循环”:
- 标准范式: 遍历
data.items(),使用isinstance(value, dict)区分内部节点与叶子节点。 - 溯源路径: 在形参中设置
parent_key携带上一层的键名,即可在递归过程中动态拼装出完整的调用路径。 - 安全防线: 面对不受信的深层数据源,务必使用
set()记录访问过的对象id,阻断可能出现的死循环与递归越界。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









