

Python怎么在遍历字典时筛选特定键值对

for k, v in d.items() 循环中附加 if 条件即可。如果需要在遍历时直接修改原字典(删除不符合条件的元素),则必须遍历字典键的静态快照(例如 list(d.keys())),以避免触发迭代器修改异常。
一、首选方案:使用字典推导式快速过滤
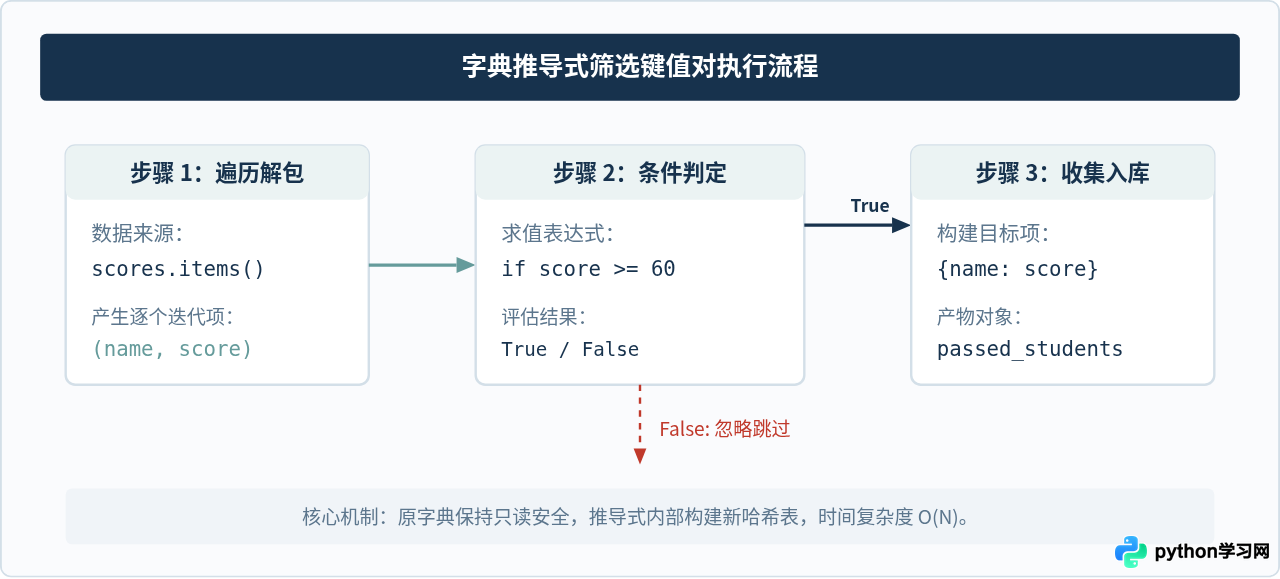
在大多数日常业务中,筛选字典的目的都是为了提取满足条件的数据并生成一个干净的新字典。Python 的字典推导式不仅代码紧凑、可读性强,而且在底层 CPython 虚拟机中经过了专门优化,执行速度显著优于手动追加循环。
语法结构非常直观:{k: v for k, v in original_dict.items() if condition}。通过 .items() 方法同时解包出键与值,并在末尾附加布尔判定条件。
# 示例:根据分数过滤出及格的学生名单
scores = {"Alice": 85, "Bob": 58, "Charlie": 92, "David": 45}

# 仅保留成绩大于等于 60 的键值对
passed_students = {name: score for name, score in scores.items() if score >= 60}

# 示例输出:{'Alice': 85, 'Charlie': 92}
print(passed_students)
除了针对值(Value)进行过滤,同样可以基于键(Key)或者键值组合进行复合判断。例如仅保留以特定前缀开头的配置项,或者同时要求键名合法且数值不为空:
config = {
    "app_port": 8080,
    "app_debug": True,
    "db_host": "localhost",
    "db_user": "root"
}

# 筛选以 "app_" 开头的配置项
app_config = {k: v for k, v in config.items() if k.startswith("app_")}
# 示例输出:{'app_port': 8080, 'app_debug': True}
print(app_config)
二、直接使用 for 循环做即时消费
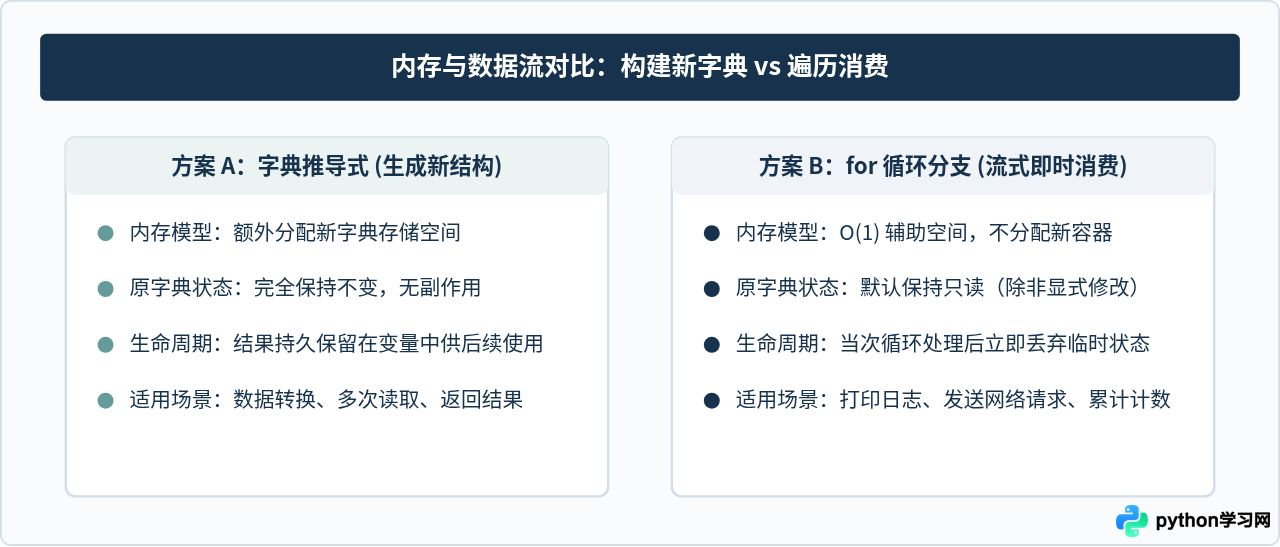
如果在遍历时不需要将筛选出的项汇总成一个新字典,而是需要立即触发某些操作(例如打印输出、写入数据库、调用外部接口或进行数值累加),则无需创建中间容器,直接在标准的 for 循环中添加分支判断即可。
inventory = {"apple": 120, "banana": 45, "cherry": 0, "durian": 15}

# 场景:仅针对库存告急(少于 50 件)且仍有货的商品发出补货预警
for fruit, stock in inventory.items():
    if 0 < stock < 50:
        print(f"告警提示:{fruit} 剩余库存仅 {stock} 件,请及时补货。")
这种处理方式直接利用了迭代器按需产出数据的特性,避免了在内存中开辟额外的字典存储空间,属于典型的流式消费模式。
三、常见陷阱:在遍历中原地删除字典项
许多初学者在遇到“清理字典中不合规数据”的需求时,会直觉性地写出如下代码:
# 错误示例:禁止直接遍历字典的同时修改大小
data = {"a": 1, "b": 2, "c": 3, "d": 4}

for k, v in data.items():
    if v % 2 != 0:
        del data[k]  # 触发 RuntimeError!
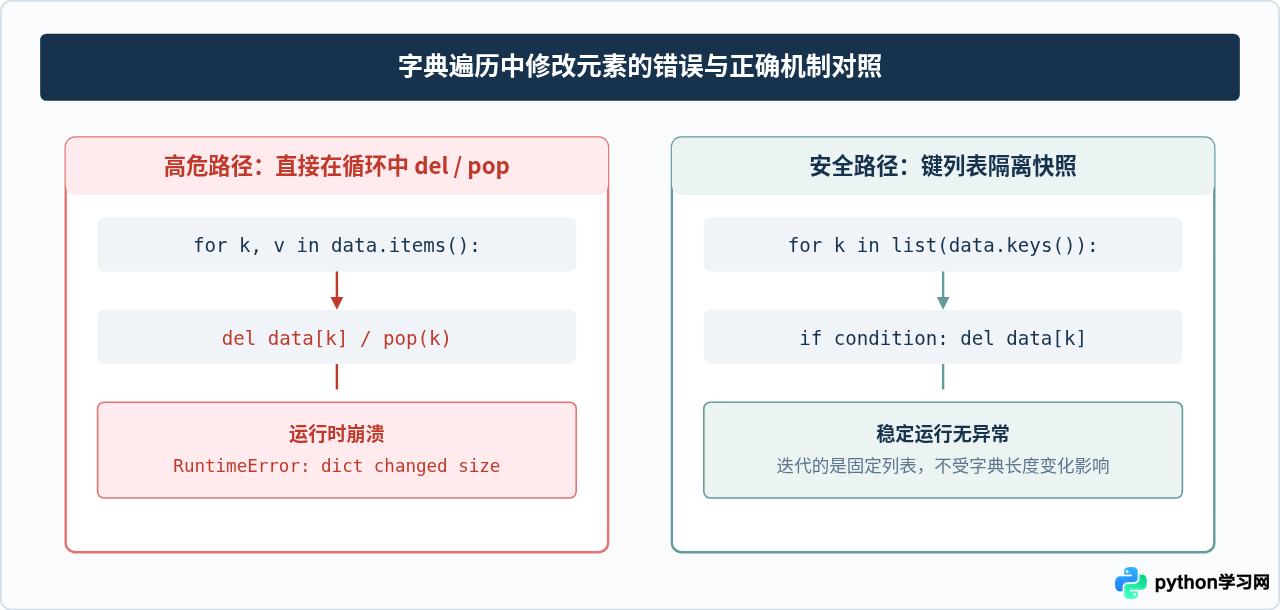
运行上述代码会立即抛出异常:RuntimeError: dictionary changed size during iteration。
Python 的字典基于哈希表实现。在遍历
data.items() 或 data.keys() 时,Python 底层维护着一个指向哈希槽的迭代状态。如果在迭代周期内执行 del 或 pop(),字典的大小(size)以及哈希桶的分布结构可能被改变,这会导致迭代指针错位或陷入不可预测的状态。为了保障数据完整性,Python 解释器在每次迭代推进时都会校验字典的变更计数器,一旦发现大小在迭代中发生变化,便会主动抛出 RuntimeError。
安全解法 1:使用键列表快照 list(d.keys()) 进行迭代
如果确实必须在原字典对象本身上进行剔除(例如原字典被外部多个模块直接引用,不能替换为新实例),正确做法是先用 list() 将键固定成一个独立的内存列表,然后再遍历该列表修改原字典:
data = {"a": 1, "b": 2, "c": 3, "d": 4}

# list(data.keys()) 会在内存中生成一个独立的列表快照
for k in list(data.keys()):
    if data[k] % 2 != 0:
        del data[k]  # 安全操作,迭代的是列表而不是字典本身

# 示例输出:{'b': 2, 'd': 4}
print(data)
安全解法 2:推导式过滤后原址重置 (clear + update)
如果既想享受推导式的高效率,又要保持原字典对象的内存地址(ID)不变,可以结合 clear() 与 update():
cache = {"token_1": 100, "token_2": 0, "token_3": 50}

# 1. 过滤出满足条件的项
valid_entries = {k: v for k, v in cache.items() if v > 0}

# 2. 原址清空并注入新数据
cache.clear()
cache.update(valid_entries)

# 示例输出:{'token_1': 100, 'token_3': 50}
print(cache)
四、函数式风格:filter() 与 dict 构造器
在某些函数式编程场景下,也可以使用内置的 filter() 函数配合 dict() 完成筛选。它接受一个判定函数和一个可迭代对象:
raw_records = {"user_a": 10, "user_b": 0, "user_c": 25, "user_d": 0}

# filter 接收一个接收键值元组的匿名函数
filtered_records = dict(filter(lambda item: item[1] > 0, raw_records.items()))

# 示例输出:{'user_a': 10, 'user_c': 25}
print(filtered_records)
虽然 filter() 能够达到同样的效果,但在可读性与执行效率上:
- 可读性:推导式
{k: v for k, v in d.items() if ...}能够直接对变量名进行直观解包,而filter(lambda item: ...)需要通过下标item[0]、item[1]访问,语法层级较为隐晦。 - 执行性能:推导式在字节码层面是由解释器直接优化的循环指令,而
filter + lambda涉及额外的 Python 函数调用栈开销,耗时通常高出 20%~40%。
五、综合选型与技术决策指南
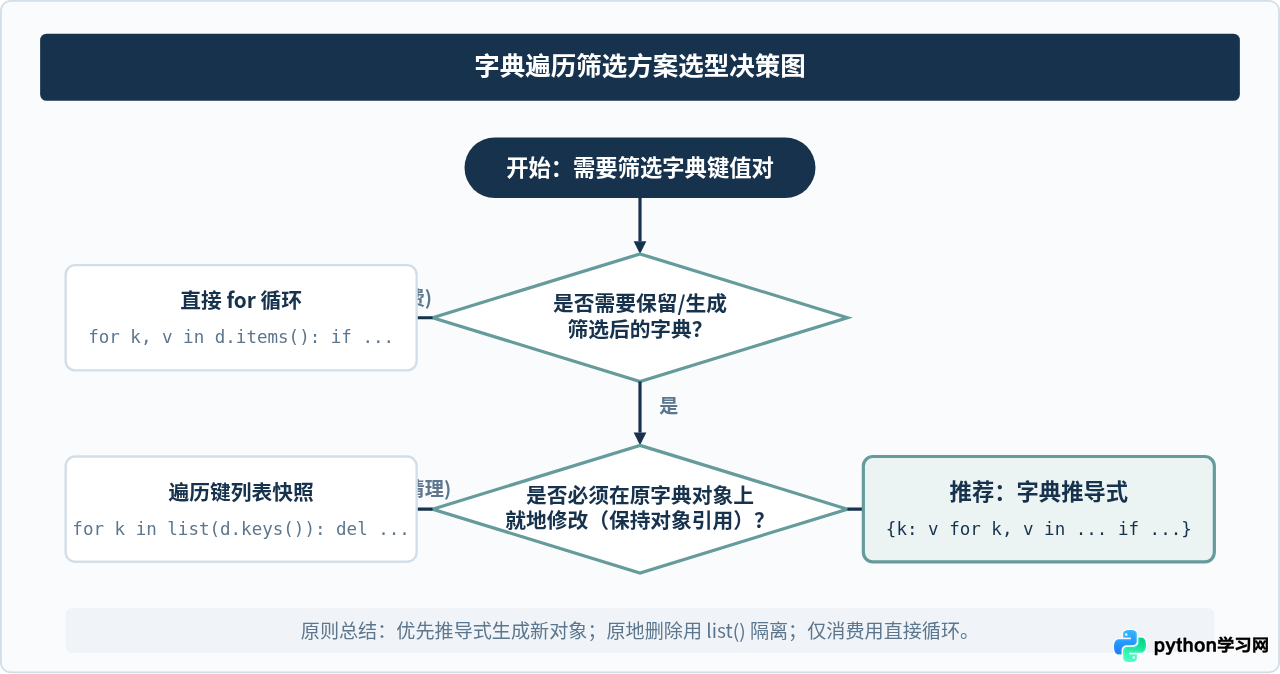
面对不同的业务上下文,选择最匹配的技术方案能够兼顾代码整洁度与系统性能:
| 应用场景 | 推荐方案 | 主要优势 | 注意事项 |
|---|---|---|---|
| 提取数据生成新字典 | 字典推导式 | 可读性最优、执行速度快、无副作用 | 大数据量下会有短暂的新内存开销 |
| 流式触发操作(如打印/入库) | for 循环 + if 条件 | 内存开销恒定 O(1)、逻辑解耦 | 若需汇总结果,不建议在循环外手动 update |
| 必须原址删除脏数据 | list(d.keys()) 快照循环 | 确保不破坏原有对象引用、避免崩溃 | 需创建一次键列表快照 |
| 已有高阶过滤函数 | filter() + dict() | 天然契合函数式管道链式调用 | 匿名函数存在额外的函数栈开销 |
六、关键注意事项与性能边界
- Python 3.7+ 的有序性保证:无论是直接遍历还是使用字典推导式生成新字典,Python 均严格保留原字典中键的插入顺序。筛选后的字典同样维持原有键的先后次序。
- 键不可变性与哈希一致性:筛选过程中不要尝试在迭代内部直接修改正在遍历的键本身;字典的值可以随时变更,但键必须是可哈希(hashable)的不可变对象。
- 大数据量下的内存权衡:如果源字典包含数千万条记录,生成新字典会带来成倍的内存峰值。此时若内存吃紧,可优先考虑分批遍历、生成器表达式(Generator Expression)结合消费,或者使用键快照按需原地清理。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









