

哪里可以下载到高质量的Python网络爬虫实战代码包
系统介绍高质量Python网络爬虫实战代码包的权威下载渠道、甄别评估标准与安全部署步骤,帮助开发者获取结构严谨、依赖明确且持续维护的优质爬虫项目。
寻找高质量的 Python 网络爬虫实战代码包,核心原则是优先选择具备完整依赖锁定、包含错误重试机制且近期持续维护的公开工程仓库,而非下载陈旧的网盘打包合集。可靠的下载途径主要有三类:GitHub 与 Gitee 上带有规范测试的开源合辑、正规技术出版社出版的爬虫专著配套开源仓库,以及主流爬虫框架(如 Scrapy、Playwright)的官方 Example 示例库。本文将依次梳理各渠道的具体检索方式、甄别优质代码包的客观标准,并给出从克隆到安全运行的完整操作流程。
一、核心下载渠道与精准获取方法
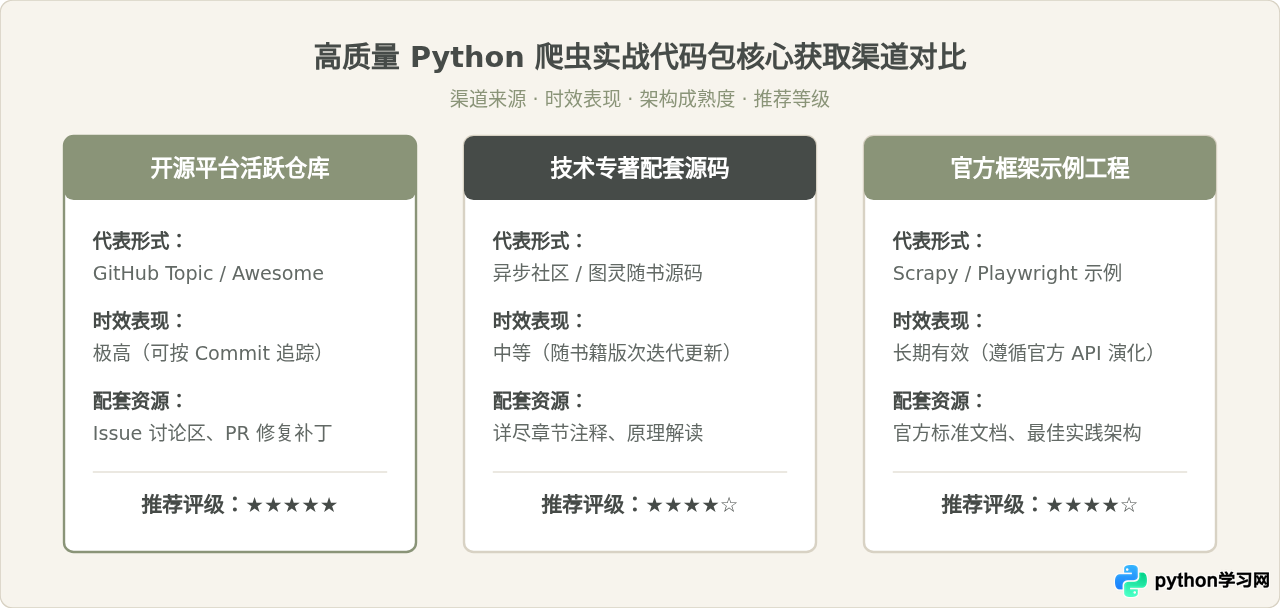
网络爬虫代码与常规算法库不同,目标网站的前端架构与反爬规则随时可能变化,因此“高质量”的首要前提是代码源头清晰、维护状态可追溯。以下三个途径是目前获取合规且高质量爬虫代码包的主流选择:
1. 代码托管平台的精选合辑(GitHub / Gitee)
代码托管平台是获取新鲜实战代码的第一阵地。搜索时应避免使用过于宽泛的关键词(如单纯搜索 爬虫代码),而应结合专题标签和框架进行精确定位:
- 精选列表(Awesome 仓库):在搜索栏输入
awesome-spider或awesome-python-crawler,可以找到由资深开发者维护的精选索引。这类仓库会对收录的项目进行分门别类,标注项目针对的场景(如电商、社交媒体、文献检索等)。 - 主题标签检索(Topic):访问 GitHub 的 Topics 页面,直接检索
topic:crawler、topic:scraping并按Most stars或Recently updated排序,重点观察近 3 到 6 个月内仍有 Commit 记录的项目。 - 国内镜像与中文支持:若网络访问受限,可在 Gitee 上搜索
Python 爬虫 实战,优先筛选带有“开源推荐”或“GVP(最有价值开源项目)”标签的仓库,中文注释和配置文档相对更完整。
2. 权威出版机构的技术专著配套仓库
由专业技术出版社(如图灵教育、异步社区、机械工业出版社等)出版的 Python 爬虫实战类图书,通常会在随书介绍页提供 GitHub 或 Gitee 的公开配套代码仓库。例如崔庆才老师的《Python 3网络爬虫开发实战》配套代码库:
- 质量特点:代码结构按照章节循序渐进,从基础
requests到进阶的Scrapy-Redis分布式架构均有独立模块,代码规范性高。 - 获取路径:打开图书官网对应的书籍详情页,在“资料下载”或“随书源码”栏目中,可直接跳转至公开代码仓库的 Release 压缩包下载地址。
3. 官方框架与自动化工具示例库
对于希望掌握工程级爬虫架构的开发者,官方框架的示例项目是最具权威性的学习来源:
- Scrapy 官方 Examples:Scrapy 团队在官方仓库中提供了完整的 quotes、books 等抓取示例工程,涵盖了中间件(Middleware)、管道处理(Pipeline)以及异步存储的规范写法。
- Microsoft Playwright 官方用例:针对动态渲染与复杂 SPA 站点的抓取,Playwright 的官方 Python 仓库中包含大量端到端测试与页面数据提取案例,代码严谨且无冗余逻辑。
二、认知辨析:为什么“网盘一键打包源码”往往无法直接使用?
许多初学者倾向于在搜索平台检索“100套精选爬虫源码打包下载”,期望一键解压后直接批量运行。这种想法具有一定的直观吸引力,但在实际工程中几乎必然会遇到严重阻碍。
辨析核心:打包下载的静态源码看似“案例丰富”,但忽略了网络爬虫的时效对抗性与环境强依赖性。未经持续维护的代码包,在真实网络环境下极易沦为无法运行的“死代码”。
我们可以从以下三个维度来理解这种做法的合理部分与必然缺陷:
- 为什么看似合理:单份打包合集确实整理了多种网站类型(如资讯、图片、问答社区),初学者可以快速查阅不同解析模块的语法写法,例如如何用 BeautifulSoup 提取表格,或者如何用正则表达式清洗文本。
- 在哪些条件下成立:只有当目标站点为完全静态、多年未改版、且无任何动态 Token 或频率限制时,陈旧代码才能正常提取到数据。或者该代码包主要用于“离线语法学习”,不直接对实时网页发起请求。
- 哪里必须修正:现代网页前端普遍采用单页面渲染、混淆 CSS 命名与反爬风控机制(如滑动验证码、TLS 指纹检测、接口请求签名)。两年前打包的爬虫代码,其目标 URL、接口签名算法或 HTML 标签层级 90% 以上已经失效,强行运行通常只会得到
403 Forbidden或空字典。此外,未经安全审计的第三方压缩包内可能携带恶意外部加载脚本或私有代理投毒。
三、高质量爬虫代码包的四维评估模型
在 GitHub 或其他平台下载代码前,不应只看 Star 数量,而需要从工程角度对其进行客观甄别。一个能够作为实战参考的高质量爬虫包,应满足以下四个维度的技术指标:
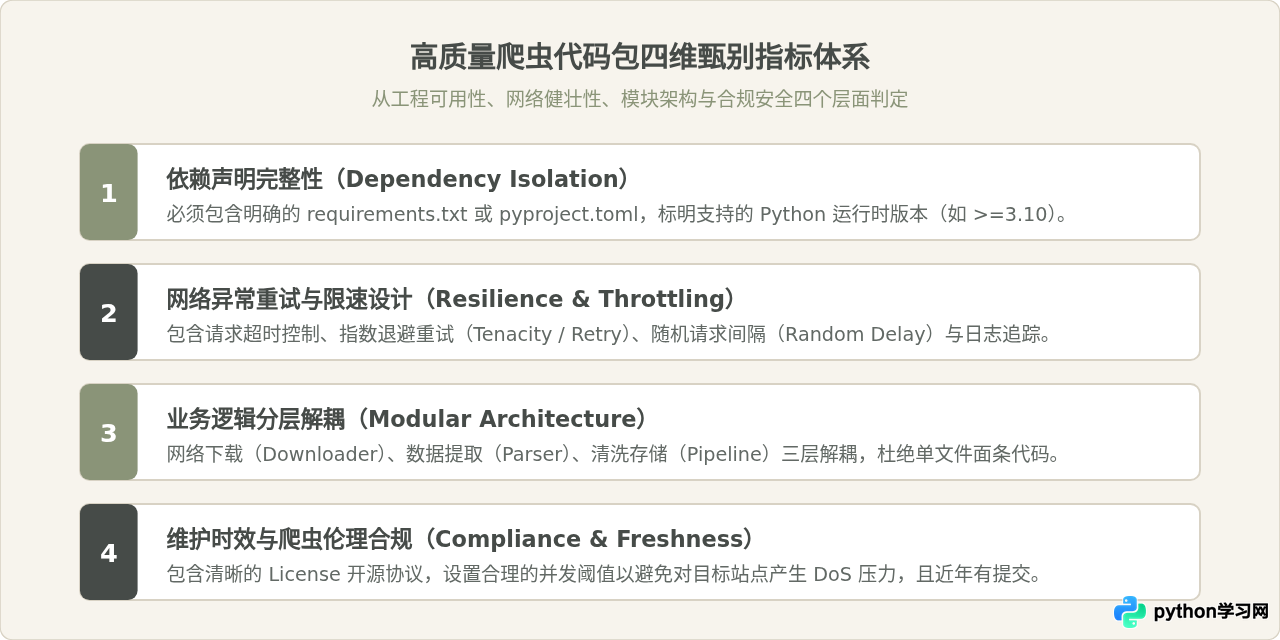
具体来看,优质的实战代码包通常具备以下文件组织形态:
spider_project/
├── pyproject.toml / requirements.txt   # 严格的版本依赖锁定
├── README.md                           # 详细的运行说明与反爬适配声明
├── config.py                           # 请求头、代理池与存储路径配置
├── downloader.py                       # 封装超时重试、会话保持与指纹伪装
├── parsers/                            # 按目标网站拆分的独立解析器
│   ├── base_parser.py
│   └── target_parser.py
├── pipelines.py                        # 数据清洗、入库或写入本地文件
└── main.py                             # 调度启动与并发速率控制器
四、从下载到安全部署运行的实战操作步骤
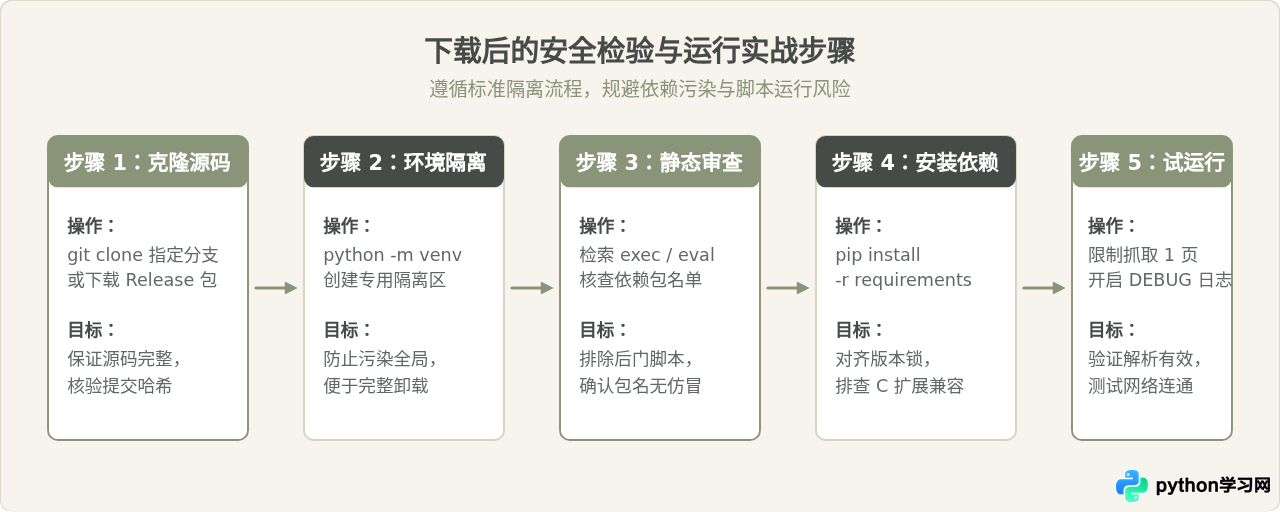
获取到心仪的代码包后,不能直接全局安装运行。规范的实操应遵循“获取源码 → 环境隔离 → 静态审计 → 依赖安装 → 单步验证”的顺序展开。
步骤 1:获取源代码包
推荐直接使用 git clone 获取,以便保留仓库的提交历史,并在原作者更新反爬补丁时快速同步:
# 示例:克隆指定分支或标签代码
git clone --depth 1 https://github.com/example-author/example-crawler.git
cd example-crawler
步骤 2:创建并激活隔离的 Python 虚拟环境
切忌在操作系统的默认全局环境直接运行下载的第三方爬虫脚本。使用标准库的 venv 创建专属隔离区:
# Linux / macOS
python3 -m venv .venv
source .venv/bin/activate

# Windows (PowerShell)
python -m venv .venv
.\.venv\Scripts\Activate.ps1
步骤 3:静态安全审查与依赖分析
在安装依赖前,建议先对 requirements.txt 及核心代码进行两分钟的快速审查:
- 检查是否有可疑的同音或形似知名库的恶意包(Typosquatting)。
- 在项目目录全局搜索
eval(、exec(或对未知外部 IP 的通信代码,确保代码不存在反弹 Shell 或上传本地凭据等恶意行为。
步骤 4:安装依赖并执行最小化测试
安装依赖后,不要立即开启多线程全量抓取,务必将请求数量限制为 1 次,并打印完整的响应与解析字典:
pip install -r requirements.txt

# 运行前检查:仅以单页为目标执行试运行
python main.py --max-pages 1 --log-level DEBUG
五、运行开源代码包的常见报错与适配调整
由于目标网站随时在调整反爬策略,下载的高质量代码包在首次执行时可能会遇到以下典型问题,掌握对应的排查方法即可快速恢复运行:
| 报错现象 / HTTP 状态码 | 根本原因排查 | 具体修复与调整措施 |
|---|---|---|
403 Forbidden / 401 Unauthorized |
静态 User-Agent 已被目标服务器拦截,或缺少必要的 Cookie / 防盗链 Referer 标头。 | 在 downloader.py 中更新真实浏览器的请求头,或集成 fake-useragent 动态轮换合法客户端标头。 |
IndexError / AttributeError (返回 None) |
目标网站进行了改版或前端样式重构,原有 XPath / CSS 选择器无法匹配到节点。 | 在浏览器中按 F12 审查最新 DOM 树,使用 parsel 或 BeautifulSoup 更新选择器路径。 |
SSL: CERTIFICATE_VERIFY_FAILED |
本地 Python 运行环境根证书不完整,或目标网站使用了自签名证书。 | 确认已安装 certifi 依赖,并在请求中显式指定证书路径,避免直接粗暴设置 verify=False。 |
Max retries exceeded with url |
触发了目标站点的 IP 频控限制或连接超时。 | 调整请求间歇时间(添加 time.sleep(random.uniform(1.5, 3.0))),并配置合规代理出口。 |
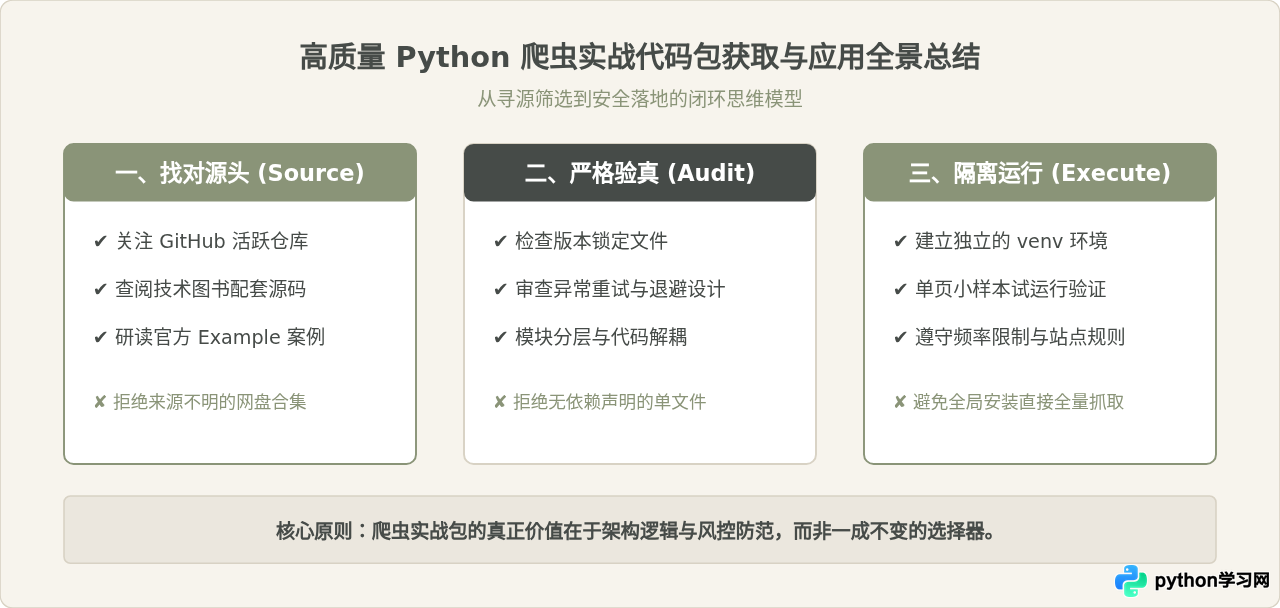
六、选型与应用总结
高质量的 Python 网络爬虫实战代码包,其核心价值在于工程架构示范与反爬治理思维,而非一份永不失效的选择器清单。网页结构变化是网络爬虫必然面临的常态,能够解耦网络请求与数据清洗、具备完善重试降级设计的工程,才是真正值得下载和参考的优质资产。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









