

Python常见的数据结构有哪些
全面梳理Python常见的数据结构,包括内置的列表、元组、字典、集合,以及标准库中的双端队列、计数器等进阶结构。结合底层原理、操作示例与决策图示,帮助读者准确选型与高效开发。
在 Python 中,数据结构是组织、管理和存储数据的具体格式。Python 既提供了使用频率极高的四大内置基础数据结构(列表、元组、字典、集合),也在标准库中封装了针对特定性能瓶颈的高阶容器(如双端队列、计数器、堆等)。掌握这些数据结构的核心区别、底层原理与时间复杂度,不仅能写出更优雅的代码,更能直接避免不必要的内存与算力开销。
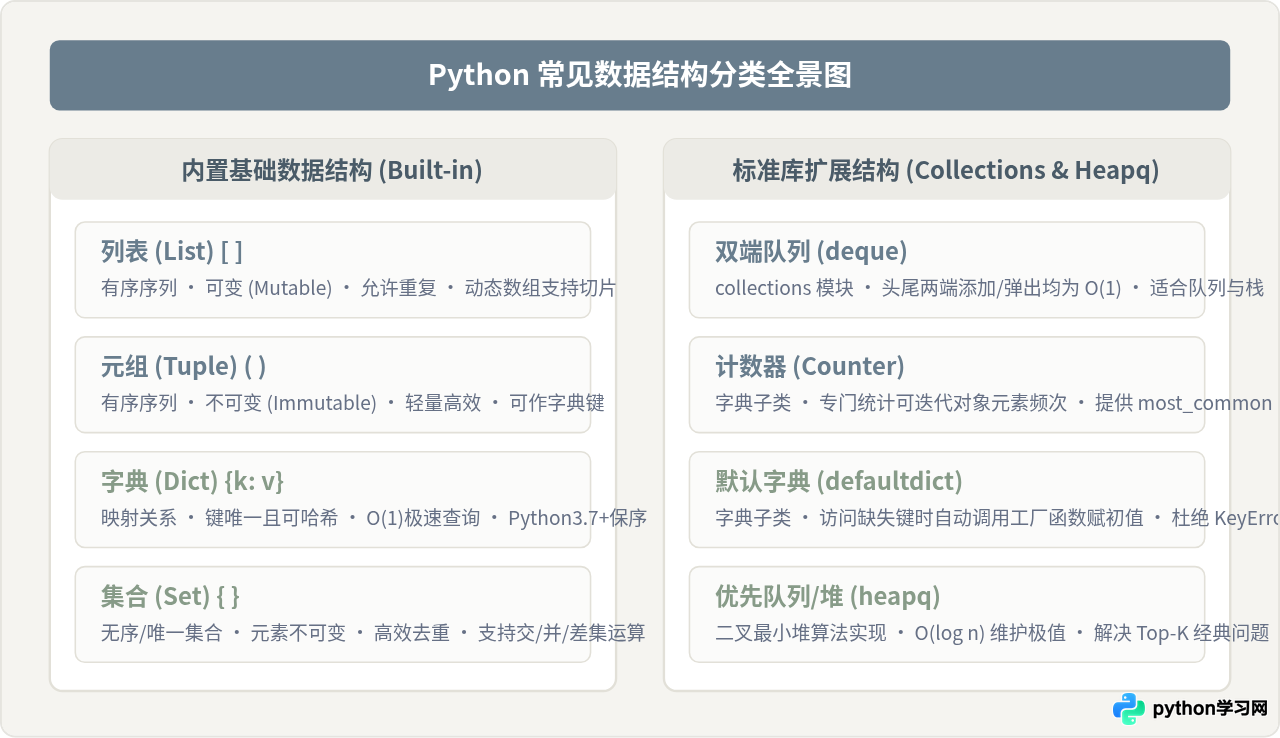
一、基础序列类型:列表(List)与元组(Tuple)
序列(Sequence)是 Python 中最符合直觉的线性结构,元素按固定顺序排列,每个元素拥有从 0 开始的非负整数索引。
1. 列表(List):通用的动态容器
列表使用方括号 [] 定义,属于可变(Mutable)对象。其底层由连续的引用指针数组构成,在末尾追加元素效率极高,且容量能够自动扩容。
# 列表常用操作示例
fruits = ["apple", "banana", "orange"]
fruits.append("pear")           # 末尾追加元素: O(1)
fruits.insert(1, "grape")       # 指定位置插入: O(n)
removed_item = fruits.pop()     # 弹出末尾元素: O(1)
fruits[0] = "strawberry"        # 按索引修改元素: O(1)

# 切片操作获取子列表
sub_list = fruits[1:3] # 返回 ['grape', 'banana']remove() 或 pop() 剔除原列表元素。这会导致列表长度缩短、游标错位,从而漏掉部分元素的检查。正确做法是使用列表推导式生成新列表,或倒序遍历。
2. 元组(Tuple):不可变的轻量只读序列
元组使用圆括号 () 定义,属于不可变(Immutable)对象。一旦创建,其包含的元素引用便不能被替换、增加或删除。当元组内部所有元素均不可变时,该元组本身是可哈希的(Hashable),因此可以安全地作为字典的键或集合的元素。
# 元组常用操作与解包
point = (10, 20)
server_config = ("127.0.0.1", 8080, "HTTP")

# 多变量解包
host, port, protocol = server_config
print(f"主机: {host}, 端口: {port}")  # 输出: 主机: 127.0.0.1, 端口: 8080

# 单元素元组末尾必须加逗号,否则会被解析为普通运算括号
single = (42,)
3. 关键差异分析:为什么不可变的元组仍然不可替代?
列表功能看似完全覆盖了元组,但元组的存在有其独特价值:
- 内存占用与分配效率:列表为了支持随时追加元素,会采用过量分配(Over-allocation)策略预留缓冲槽位;而元组在实例化时直接分配精确长度的内存,不产生预留开销。此外,Python 对小元组存在内部缓存复用机制,创建与销毁速度均快于列表。
- 数据安全与意图表达:元组明确传达了“这段数据是一组固定维度的整体,不应被外部函数随意篡改”的代码契约,能有效避免协同开发中的隐式副作用。
二、映射与集合类型:字典(Dict)与集合(Set)
如果说序列类型擅长按位置存取,那么字典与集合则依托哈希表(Hash Table),专注于极速的按值检索与唯一性维护。
1. 字典(Dictionary):高效的键值对映射
字典使用花括号 {key: value} 定义。在底层实现上,字典通过对键执行哈希计算直接定位存储槽,使得查找、插入和删除的平均时间复杂度均达到 O(1)。自 Python 3.7 起,标准字典官方保证保留元素的插入顺序。
user_profile = {
    "id": 1001,
    "username": "coder_alex",
    "role": "admin"
}

# 安全访问与默认值
email = user_profile.get("email", "not_set@example.com")

# 字典推导式快速构造映射
squares = {x: x**2 for x in range(1, 5)}
# 结果: {1: 1, 2: 4, 3: 9, 4: 16}
2. 集合(Set):去重与数学集合运算
集合使用花括号 {item} 或 set() 构造,本质是一个只有键、没有值的哈希表。它天然具备去重属性,并且能够以极其简洁的语法执行交集、并集和差集等数学运算。
set_a = {1, 2, 3, 4}
set_b = {3, 4, 5, 6}

# 集合关系运算
intersection = set_a & set_b   # 交集: {3, 4}
union = set_a | set_b          # 并集: {1, 2, 3, 4, 5, 6}
difference = set_a - set_b     # 差集 (A中有而B中没有): {1, 2}

# 常用场景:列表去重
raw_tags = ["python", "code", "python", "ai"]
unique_tags = list(set(raw_tags)) # 去除重复标签三、标准库进阶结构:破解性能与场景瓶颈
在工程实践中,仅靠内置基础类型有时会遇到性能瓶颈。Python 标准库 collections 与 heapq 模块提供了高针对性的专业数据结构。
1. 列表与双端队列(Deque)的性能权衡
在算法或业务中实现先进先出(FIFO)队列时,若使用普通列表调用 list.pop(0) 或 list.insert(0, val),由于底层是连续内存块,每次操作都会触发后续所有元素的整块内存位移,时间复杂度高达 O(n)。当数据规模达到数万级别时,程序会明显卡顿。
collections.deque 基于双向块链表实现,无论在队列头部还是尾部进行入队(appendleft / append)或出队(popleft / pop),耗时恒定为 O(1)。
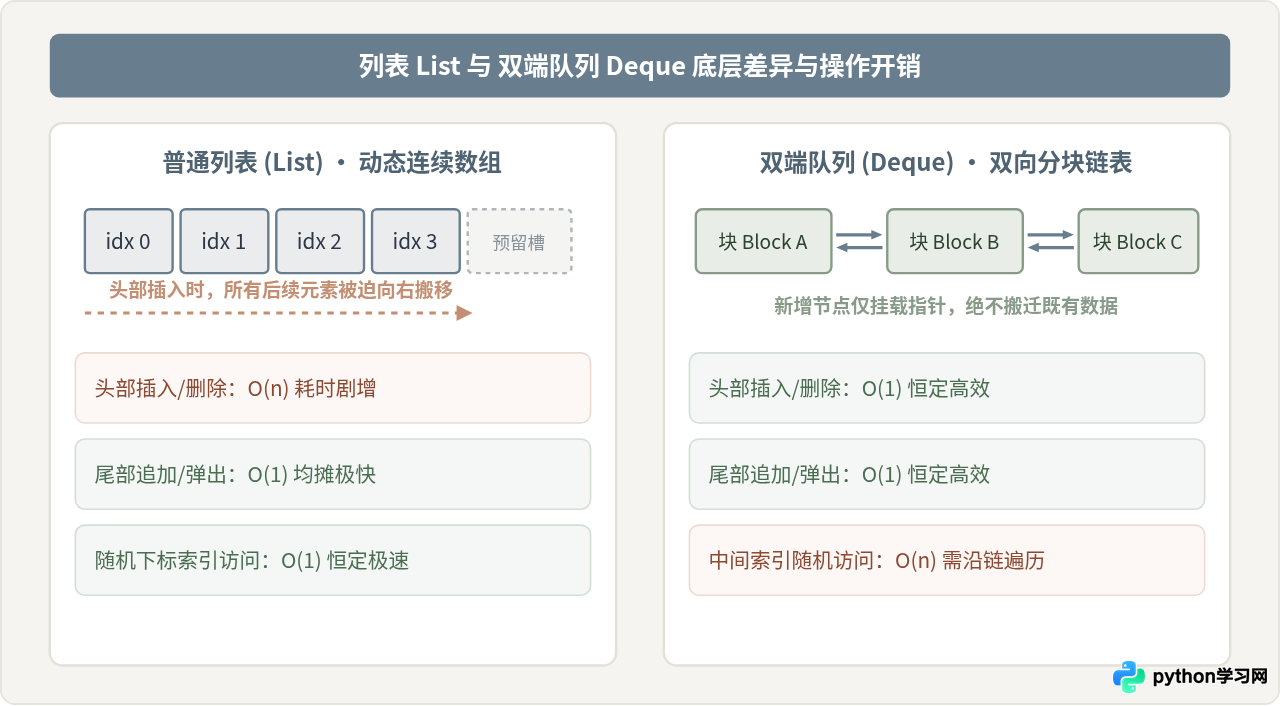
选择准则:如果需要频繁在头部追加或剔除数据(例如排队任务调度、滑动窗口算法),果断选择 deque;如果主要操作是随机读取某下标元素(例如 data[350]),普通列表依然是首选。
2. defaultdict 与 Counter:代码简化的利器
在统计分析与数据聚合时,频繁判断键是否存在往往导致冗长的条件分支。标准库提供了优雅的解决方案:
from collections import defaultdict, Counter

# 1. 使用 defaultdict 归类数据,避免手动初始化列表
grouped_data = defaultdict(list)
records = [("tech", "python"), ("tech", "rust"), ("art", "design")]
for category, item in records:
    grouped_data[category].append(item)
# 自动生成: {'tech': ['python', 'rust'], 'art': ['design']}

# 2. 使用 Counter 快速统计高频词
words = ["apple", "orange", "apple", "banana", "apple", "orange"]
counter = Counter(words)
print(counter.most_common(2))
# 输出: [('apple', 3), ('orange', 2)]
四、数据结构选型决策流程
在实际编码中,选择数据结构的核心逻辑是“根据访问模式选择开销最小的容器”。面对一组新数据时,可以依据以下逻辑树快速决策:
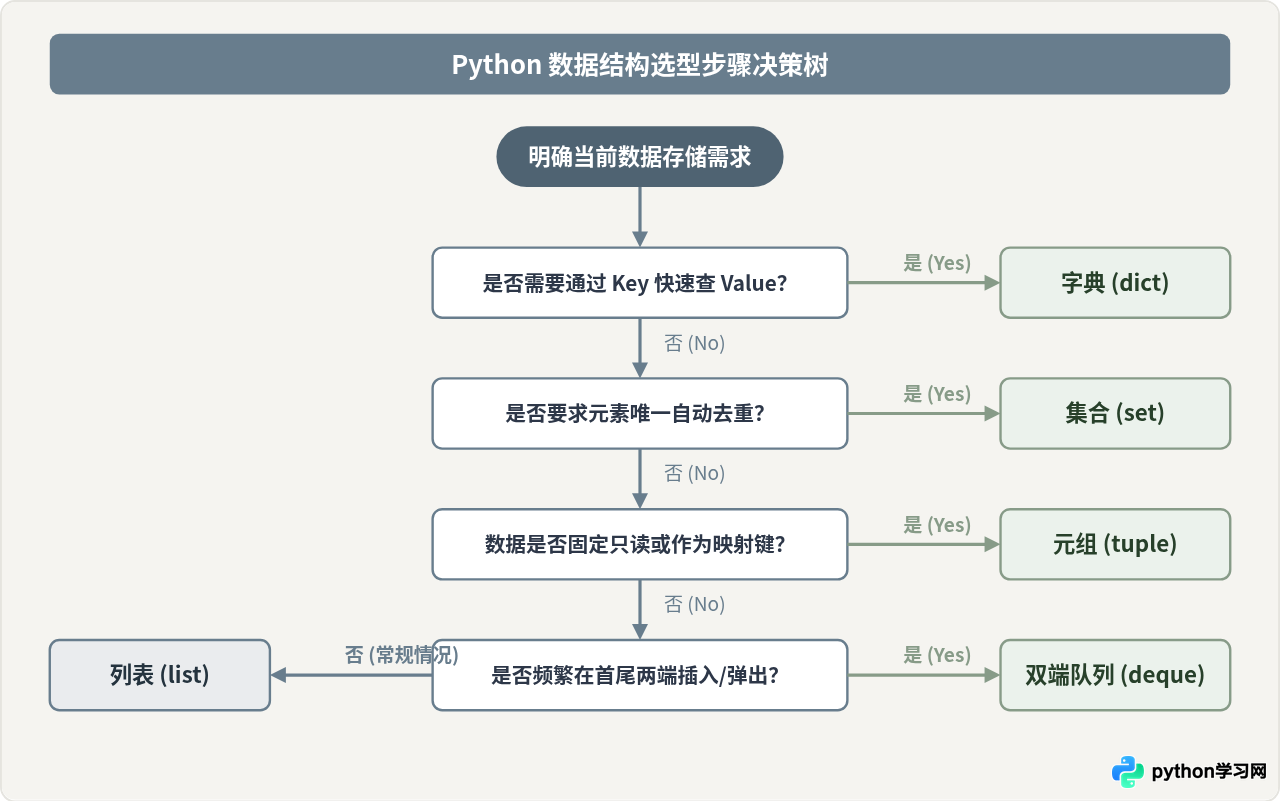
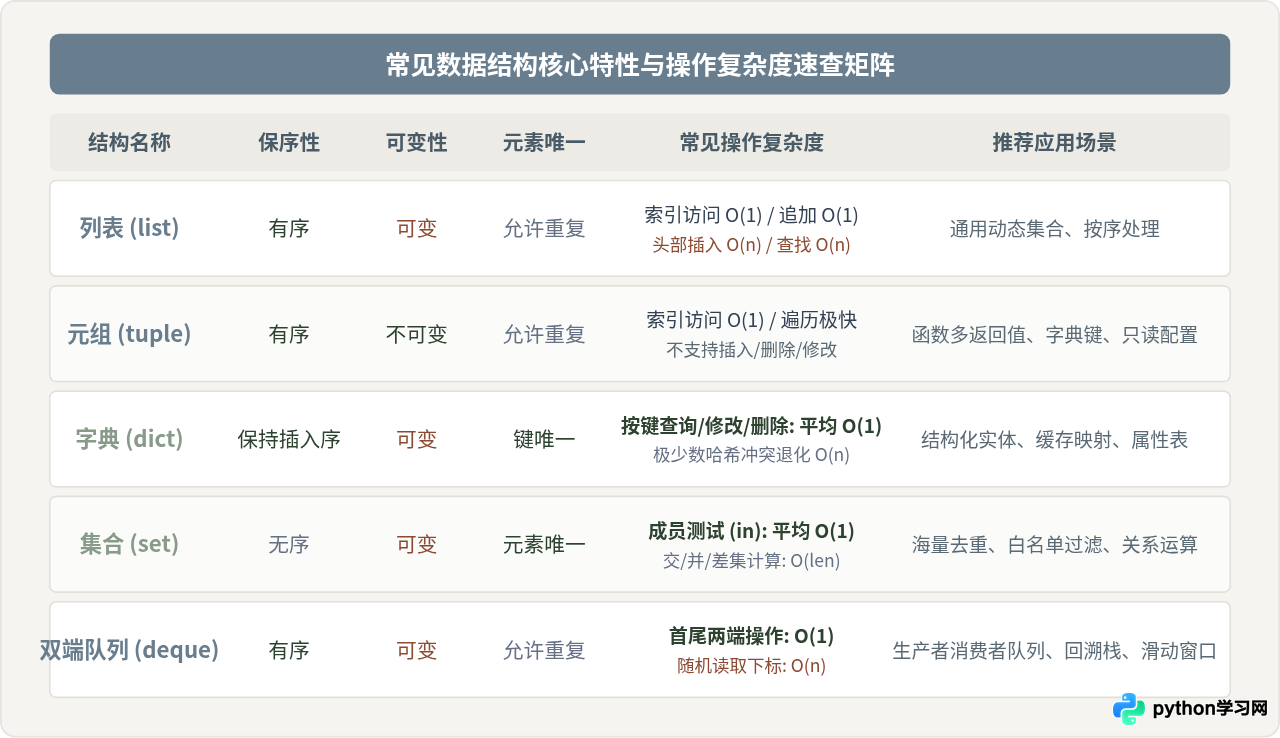
五、核心数据结构特性与复杂度对比速查
为了便于在日常编写与面试复习中随时查阅,以下将常见数据结构的特性、渐近时间复杂度与典型适用场景归纳如下:
六、总结与开发建议
在 Python 开发中,并不存在某种“完美万能”的数据结构。每一种设计都代表着特定维度的取舍与权衡:
- 通用首选:日常需要存放一组按先后到达、允许重复的数据时,列表(
list)是最自然、直观的承载容器。 - 防御与性能:如果一组数据初始化后不再变动,改用元组(
tuple)能明确防御代码误改,且在空间利用上更加紧凑。 - 快速检索:一旦代码中出现频繁的
if item in container:,应立刻警惕:若container是列表,每次判断的时间复杂度是O(n),数据量变大后性能急剧劣化;此时应将其预先转换为集合(set)或字典(dict),让检索耗时降为O(1)。 - 专业场景:在构建广度优先搜索(BFS)、任务流水线或限长历史记录时,用
collections.deque(maxlen=N)替代列表,能从底层彻底消除内存搬移引起的隐性延迟。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









