

Python 3.4.4 ftplib 处理中文文件名乱码怎么解决
针对 Python 3.4.4 中 ftplib 处理中文文件名出现乱码的问题,深入分析 RFC 959 规范与 latin-1 默认编码机制,提供重设 ftp.encoding、协商 OPTS UTF8、兼容 GBK 编码及二次转码的完整解决方案与实操代码。
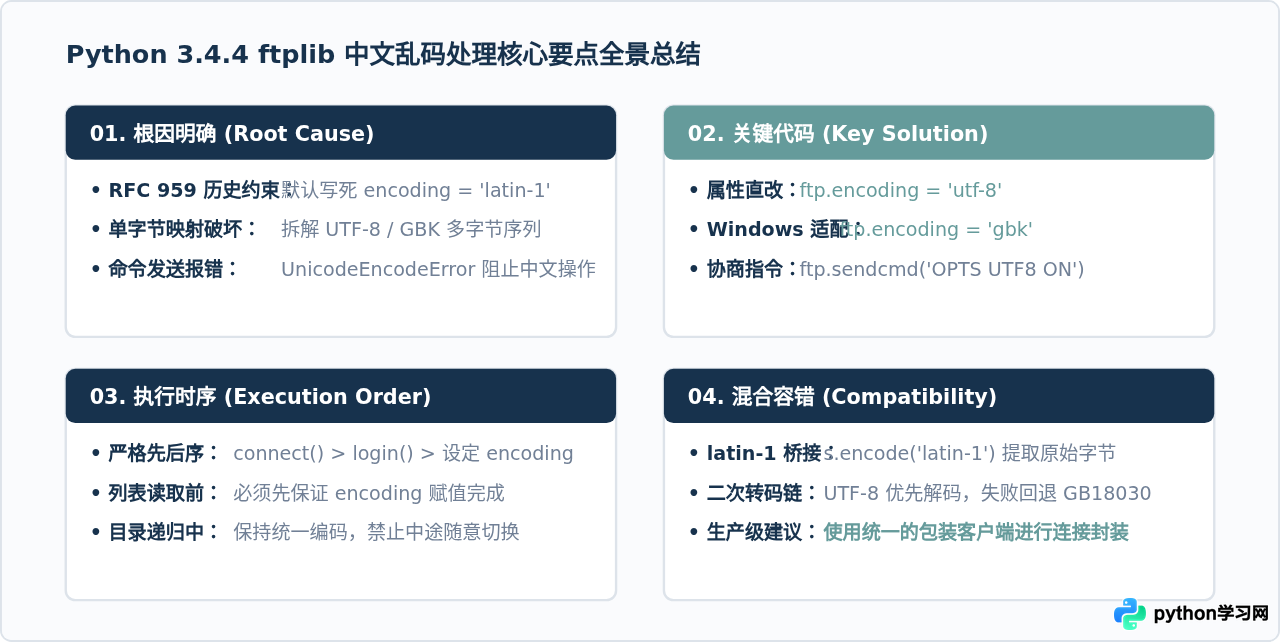
ftplib 处理中文文件名时,出现诸如 '\xe4\xb8\xad...' 或莫名的乱码字符,其核心根源是该版本标准库将控制连接的默认编码写死为 latin-1。解决该问题无需更换第三方库,最直接、可靠的办法是在初始化 FTP 实例后,直接将其属性 ftp.encoding 重设为服务端的真实编码(对于主流现代服务器设为 'utf-8',对于 Windows 中文服务器设为 'gbk'),并在必要时向服务器发送 OPTS UTF8 ON 指令协商启用 UTF-8 字符集。
一、为什么 Python 3.4.4 的 ftplib 会发生中文乱码
FTP 协议本身历史悠久,早期的 RFC 959 协议标准仅规定控制信道使用 7 位 ASCII 或 8 位 ISO-8859-1(即 Latin-1)字符集。在 Python 2 时期,ftplib 返回的均是未解码的原始 bytes(在 Python 2 中体现为 str),由开发者自行调用 .decode('gbk') 或 .decode('utf-8') 处理,因而不会在库内部产生解码冲突。
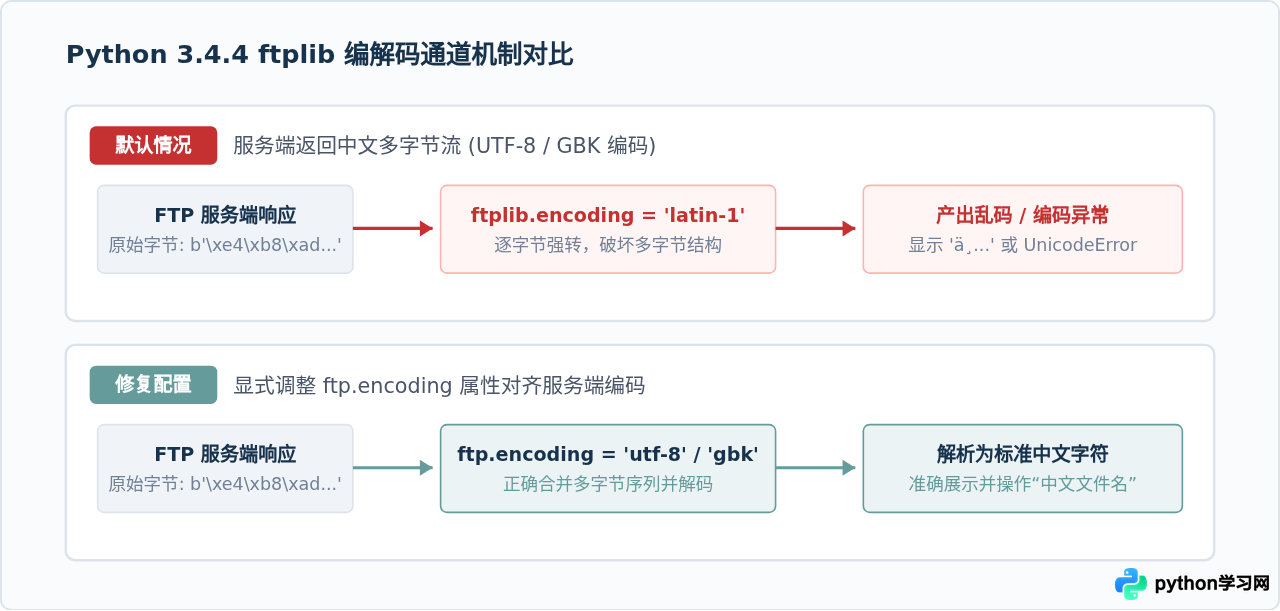
然而进入 Python 3 之后,标准库全面向 Unicode 字符串迁移。为了严格遵守 RFC 959 的向后兼容要求,Python 3.4.4 的 ftplib.FTP 源码中设定了默认属性 encoding = 'latin-1'。当服务器返回目录列表指令(例如 NLST、LIST)的文本响应时,ftplib 的内部方法 getline() 会自动按照 latin-1 将接收到的原始字节解码为字符串。
因为 latin-1 是一个单字节映射编码,它不会报错,而是直接将每个多字节编码的中文字符(如 UTF-8 的 3 字节序列或 GBK 的 2 字节序列)当作独立的 Latin-1 符号映射为文本,最终导致读者看到的乱码。更严重的是,当开发者试图通过带有中文名称的路径调用 retrbinary() 或 storbinary() 发送命令时,库内部会尝试用 latin-1 重新编码,遇到超出 \x00-\xff 范围的字符时便会直接抛出 UnicodeEncodeError 异常。
二、核心排查与解决步骤
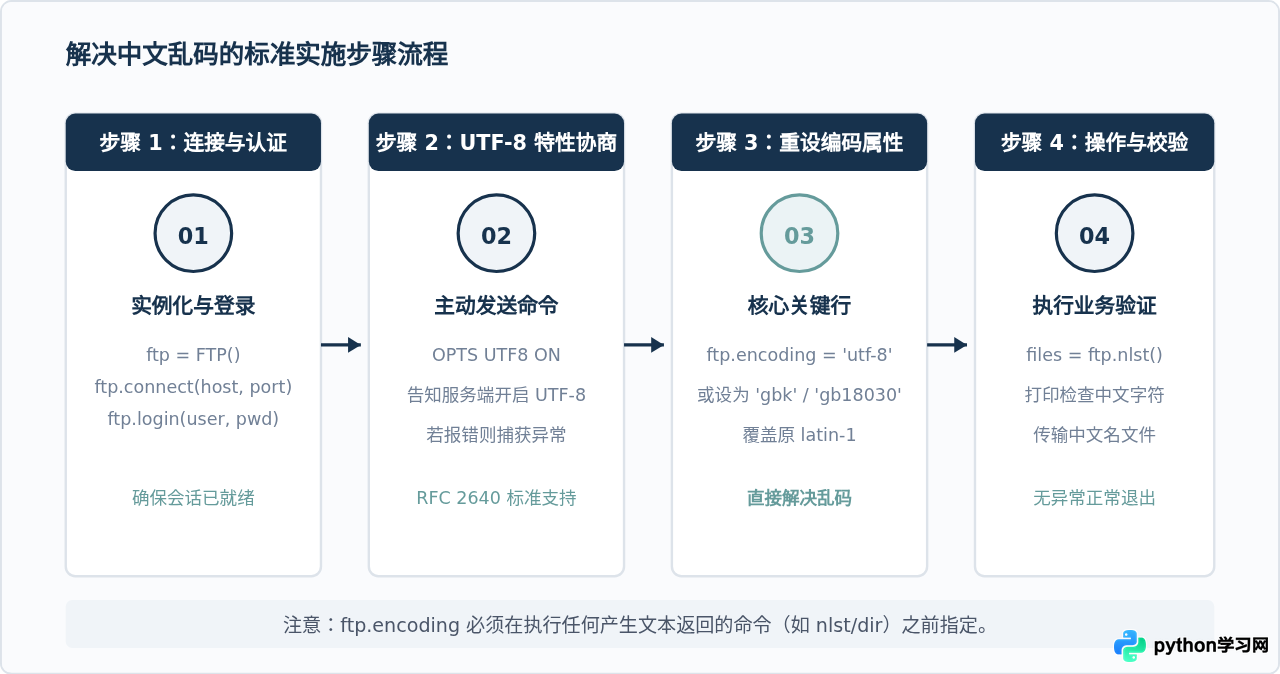
解决乱码的整体流程可以归纳为四个清晰的操作步骤:先建立网络连接,再进行特性探测,接着设定实例编码,最后验证列表与上传下载。按照此顺序操作能彻底消除 95% 以上的中文文件名异常。
步骤 1:显式设置 ftp.encoding(最直接的方法)
在 Python 3.3 及以后的版本(包括 3.4.4)中,FTP 类暴露了 encoding 成员变量。只需要在建立连接后,执行如下赋值操作:
from ftplib import FTP

ftp = FTP()
ftp.connect('192.168.1.100', 21)
ftp.login('ftpuser', 'ftppassword')

# 将默认的 'latin-1' 重设为服务端的实际编码
ftp.encoding = 'utf-8'

# 此时调用 nlst() 或 dir() 将正常显示中文
file_list = ftp.nlst()
for name in file_list:
    print(name)
步骤 2:向服务器协商启用 UTF-8(OPTS UTF8 ON)
很多支持 RFC 2640 的 FTP 服务器(例如 Pure-FTPd、vsftpd 或 FileZilla Server),默认可能未激活 UTF-8 编码传输,或者期待客户端主动确认。使用 ftp.sendcmd('OPTS UTF8 ON') 可以强制服务器切换到 UTF-8 编码模式。由于部分不支持该特性的旧服务器可能会抛出 500/501 响应错误,通常配合异常捕获使用:
try:
    response = ftp.sendcmd('OPTS UTF8 ON')
    # 若返回 200 则说明服务端已切换到 UTF-8
    ftp.encoding = 'utf-8'
except Exception:
    # 服务端不支持 OPTS UTF8,通常说明为 GBK 或强制固定编码服务器
    pass
三、不同服务端环境下的方案选择
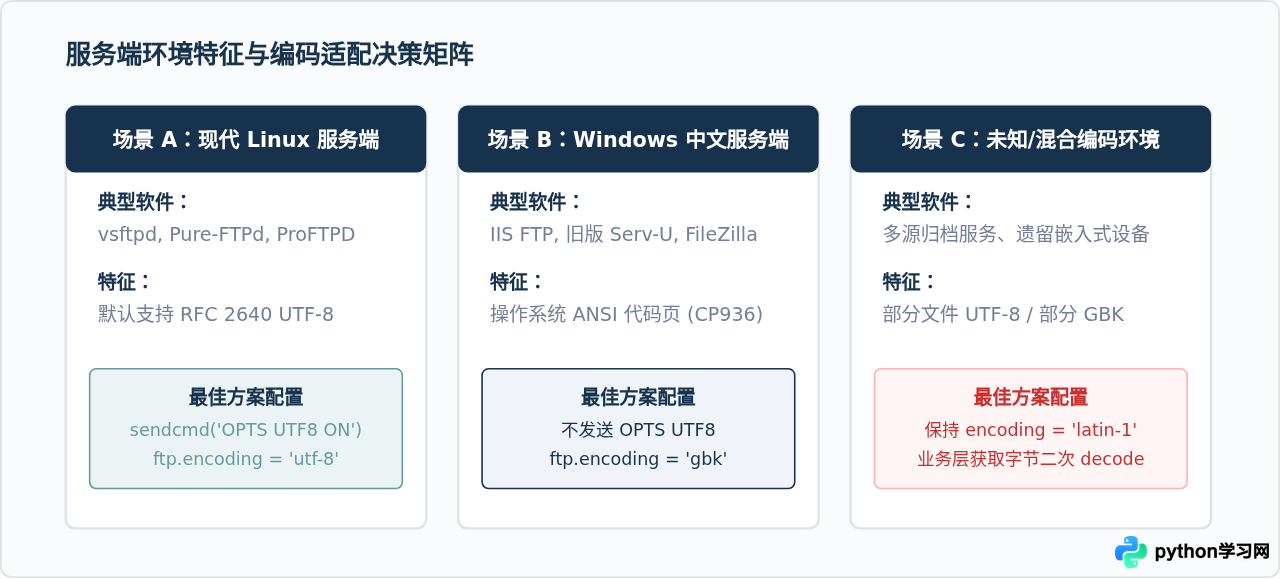
国内常见的生产环境中,FTP 服务端主要分为两类:一类是运行于 Linux 环境下的现代 FTP 守护进程(大多遵循 UTF-8);另一类是运行于旧版 Windows 中文环境(如 Windows Server IIS FTP、Serv-U),其底层文件系统和 FTP 模块默认采用操作系统的 ANSI 代码页(即 CP936 / GBK / GB18030)。
GBK 编码服务端的适配方法
如果连接的目标服务器是运行在 Windows 上的 IIS FTP,直接配置 ftp.encoding = 'utf-8' 依然会乱码,甚至在执行 nlst() 时抛出 UnicodeDecodeError。此时应将编码指定为 'gbk' 或支持更全汉字字符集的 'gb18030':
ftp = FTP()
ftp.connect('192.168.1.200', 21)
ftp.login('winuser', 'winpass')

# 适配 Windows GBK 编码
ftp.encoding = 'gbk'

for item in ftp.nlst():
    print("文件名:", item)
四、混合编码场景的兜底方案:latin-1 二次转码
在某些极其复杂的历史遗留服务中,FTP 目录下可能同时存在早期 GBK 上传的文件和后期 UTF-8 上传的文件。此时无论将 ftp.encoding 设为 UTF-8 还是 GBK,都必然有一部分文件在读取目录列表时发生解码失败。
由于 latin-1 是 0 到 255 的一一对应无损单字节映射,保持 ftp.encoding = 'latin-1' 实际上可以保留原始的二进制字节。收到乱码字符串后,只需反向使用 latin-1 还原为 bytes,再通过 try...except 尝试依次解码:
def fix_encoding(filename_str):
    """将通过 latin-1 解码出的乱码字符串安全还原并转码"""
    raw_bytes = filename_str.encode('latin-1')
    # 优先尝试 UTF-8 解码
    try:
        return raw_bytes.decode('utf-8')
    except UnicodeDecodeError:
        pass
    # 失败则回退至 GBK / GB18030
    try:
        return raw_bytes.decode('gb18030')
    except UnicodeDecodeError:
        # 若仍失败,使用 replace 避免崩溃
        return raw_bytes.decode('utf-8', errors='replace')

# 保持默认 latin-1
ftp.encoding = 'latin-1'
raw_names = ftp.nlst()
clean_names = [fix_encoding(name) for name in raw_names]
for name in clean_names:
print("安全识别文件名:", name)retrbinary 时向服务端发送 RETR <文件名>),由于 ftplib 内部仍会使用 ftp.encoding 编码命令,此时必须设置 ftp.encoding,或者在调用 retrbinary 时传入通过 encode('gbk').decode('latin-1') 逆向包装的假字符串。因此,如果服务端编码固定,优先使用配置 ftp.encoding 的标准方案。
五、生产级完整代码封装示例
以下代码提供了一个开箱即用的类封装,兼容 Python 3.4.4,实现了自动探测 UTF-8 支持、自动回退 GBK,并提供了可靠的中文文件列表获取与文件下载操作:
import os
from ftplib import FTP, error_perm

class SafeFTPClient:
    def __init__(self, host, port=21, user='', passwd='', timeout=30):
        self.ftp = FTP()
        self.ftp.connect(host, port, timeout=timeout)
        self.ftp.login(user, passwd)
        self._configure_encoding()

    def _configure_encoding(self):
        """自动协商并配置最适合的编码"""
        # 首先尝试开启 UTF-8 支持
        try:
            self.ftp.sendcmd('OPTS UTF8 ON')
            self.ftp.encoding = 'utf-8'
            # 简单验证当前编码是否工作正常
            self.ftp.nlst()
            return
        except Exception:
            pass

        # 若失败,尝试使用 GBK 编码
        try:
            self.ftp.encoding = 'gbk'
            self.ftp.nlst()
            return
        except Exception:
            pass

        # 默认回退到 utf-8,由后续业务捕获异常
        self.ftp.encoding = 'utf-8'

    def list_files(self):
        """列出当前目录下的所有文件及目录(保留真实中文名称)"""
        return self.ftp.nlst()

    def download_file(self, remote_filename, local_save_path):
        """下载包含中文名称的文件"""
        os.makedirs(os.path.dirname(os.path.abspath(local_save_path)), exist_ok=True)
        command = 'RETR ' + remote_filename
        with open(local_save_path, 'wb') as f:
            self.ftp.retrbinary(command, f.write)

    def close(self):
        try:
            self.ftp.quit()
        except Exception:
            self.ftp.close()

if __name__ == '__main__':
    # 示例用法
    client = SafeFTPClient('127.0.0.1', 21, 'test', '123456')
    try:
        items = client.list_files()
        print("当前文件列表:")
        for item in items:
            print(" -", item)
    finally:
        client.close()
六、排错与关键要点总结
在排查与处理 Python 3.4.4 中文文件名乱码时,请牢记以下关键判断要点:
- 时机很关键:
ftp.encoding必须在调用ftp.nlst()、ftp.dir()或任何涉及文件名的传输方法之前设置。如果在乱码发生之后才设置,已经读取进内存的乱码数据无法自动更正。 - 不要依赖 chardet 猜测全量目录:目录列表中单条短文件名(如“文档.txt”)字节过短,字符集检测库误判率极高。应该通过服务器特征(Linux vs Windows)统一定义连接级编码。
- 确认服务端真实支持:在服务端使用 FileZilla Server 或 vsftpd 时,可在服务器配置文件中确认
utf8_filesystem=YES(vsftpd)或勾选“Force UTF-8”(FileZilla)。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









