

Python调用百度AI API实现免本地引擎的图片转Excel
详细讲解如何使用Python调用百度智能云表格文字识别API,免安装本地大型OCR引擎及模型权重,快速将表格图片转换为Excel文件的完整流程与代码实现。
在日常办公自动化与数据整理中,将图片、扫描件或屏幕截图中的表格完整还原为可编辑的 Excel 表格是一项高频需求。本地部署 OCR 引擎通常需要配置复杂的深度学习依赖、C++ 运行库以及几十甚至数百兆的模型权重,对无 GPU 加速的轻量化服务器或办公终端并不友好。通过 Python 调用百度云端表格文字识别 API,本地无需安装任何模型引擎与庞大框架,仅凭标准网络请求库即可完成高精度的表格定位、文字抽取、合并单元格计算并直接下载标准 .xlsx 文件。
一、免本地引擎的架构方案与数据流转
传统本地 OCR 方案(如 Tesseract、PaddleOCR 等)在处理复杂网格、跨行合并或无边框表格时,不仅依赖大量本地计算资源,还需要编写繁重的启发式几何规则重构单元格坐标。百度 AI 表格文字识别服务采用云端异步计算架构,将繁重的视觉计算与格式渲染完全解耦至云端集群处理。
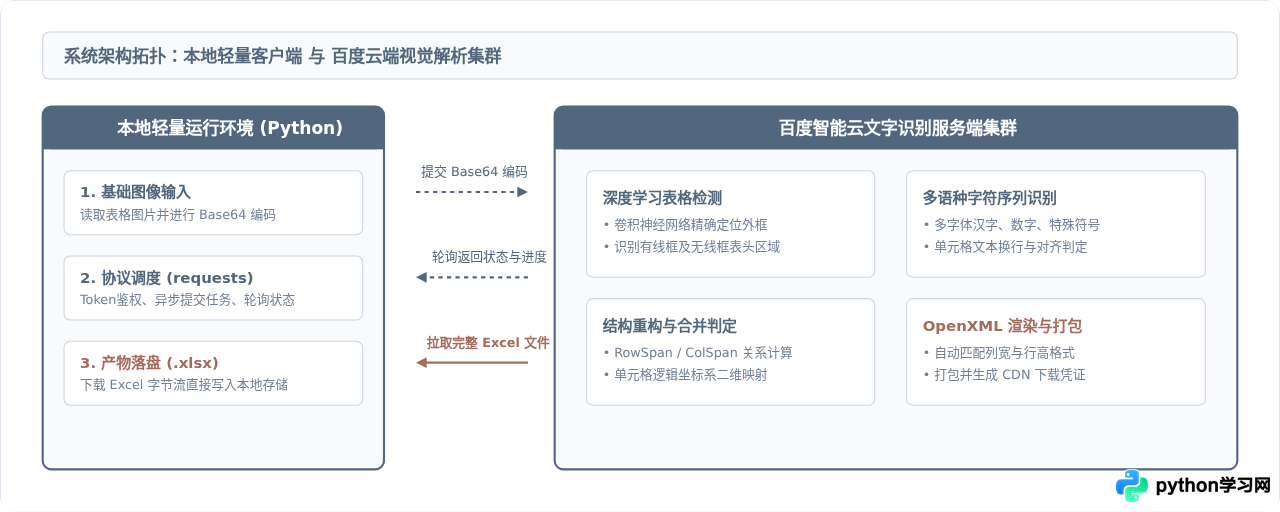
整个流程完全避免了本地环境对 GPU、PyTorch、PaddlePaddle 等庞大框架的强依赖。运行 Python 脚本的机器只需要具备基本的网络连通性,即可享受企业级模型带来的表格结构还原效果。
二、准备工作:凭证申请与鉴权获取
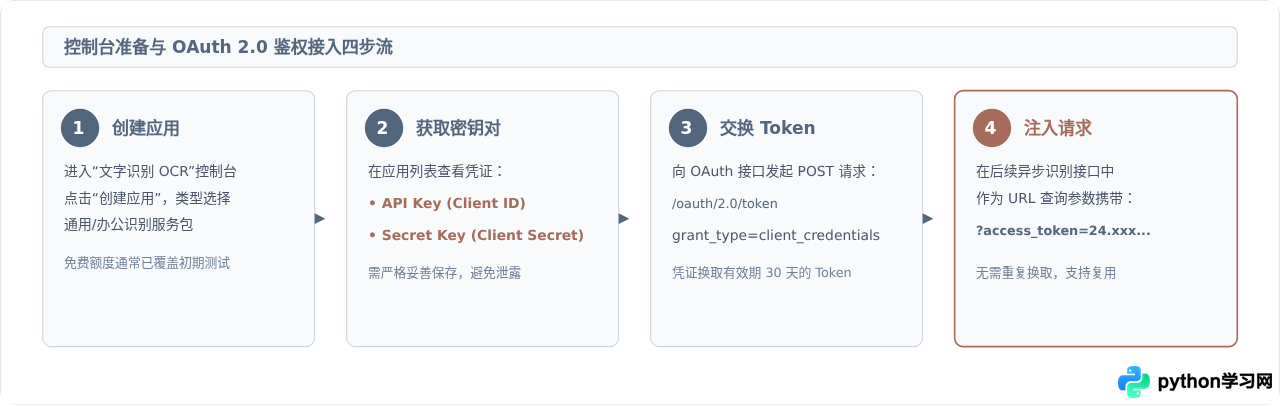
在编写代码前,需要在百度智能云控制台完成简单的应用注册,以获取鉴权所必需的 API Key(Client ID)和 Secret Key(Client Secret)。
获取 Access Token 的实现函数
利用 Python 的 requests 库,编写如下函数获取有效的访问凭证。建议在工程实践中对 Token 进行本地缓存,在其即将过期前才重新刷新,避免高频请求触发鉴权频次限制。
import requests

def get_baidu_access_token(api_key: str, secret_key: str) -> str:
    """
    通过 API Key 和 Secret Key 向百度鉴权服务换取 Access Token
    """
    token_url = "https://aip.baidubce.com/oauth/2.0/token"
    params = {
        "grant_type": "client_credentials",
        "client_id": api_key,
        "client_secret": secret_key
    }
    response = requests.post(token_url, params=params, timeout=10)
    response.raise_for_status()
    result = response.json()

    if "access_token" in result:
        return result["access_token"]
    else:
        raise ValueError(f"获取 Token 失败,错误信息: {result.get('error_description')}")
三、核心机制:异步提交与状态轮询
与普通的单行文字识别不同,表格文字识别需要耗费数十毫秒到数秒的时间对整张网格进行几何校正、单元格切分以及合并语义推理。为了保障网络连接的稳定性,百度 AI 采用了经典的异步任务模型:
- 第一阶段(提交图片):向
/rest/2.0/ocr/v1/form_ocr/request接口发送 Base64 编码的图像,立即拿到一个唯一的任务标识request_id。 - 第二阶段(轮询结果):携带该
request_id定期请求/rest/2.0/ocr/v1/form_ocr/get_request_result,监控解析进度与状态码,直到处理完成并获取 Excel 文件下载链接。
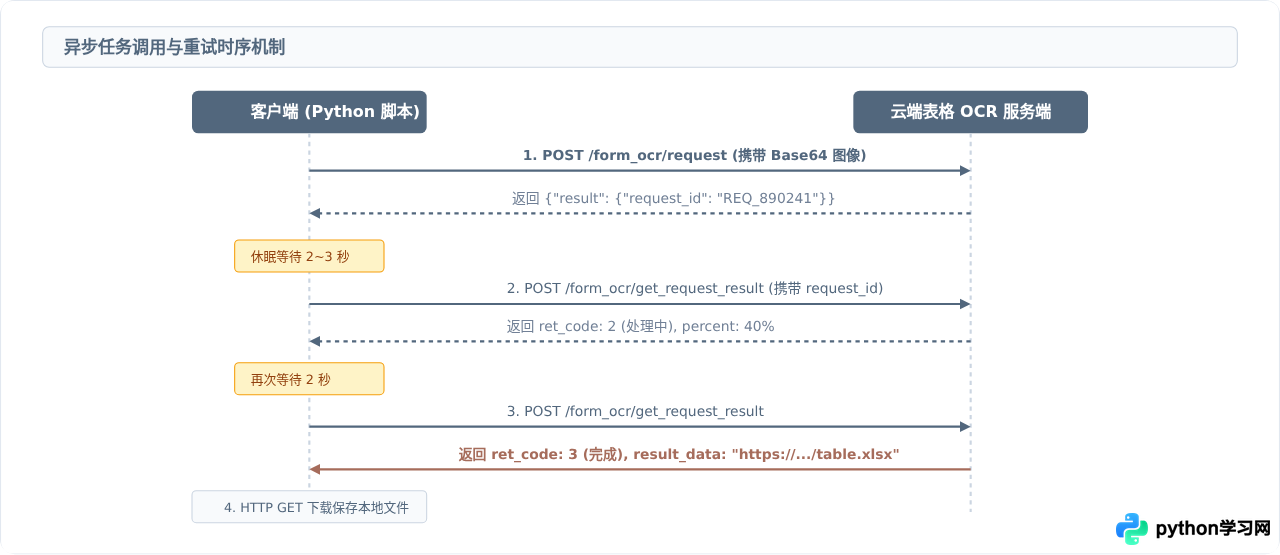
状态码定义:百度表格识别返回的 ret_code 具有明确状态定义:1 表示任务排队未开始;2 表示模型正在推理计算;3 表示全部完成且 Excel 已生成;其他值(如 4)表示识别失败。轮询循环必须针对这些状态做明确分支判断,并设置超时上限。
四、完整可执行代码实现
下面给出生产环境可直接复用的完整脚本,包含图像编码、任务提交、带超时熔断的轮询逻辑以及二进制文件下载保存。
import base64
import time
import requests

class BaiduTableOCR:
    def __init__(self, api_key: str, secret_key: str):
        self.api_key = api_key
        self.secret_key = secret_key
        self.access_token = self._fetch_token()

    def _fetch_token(self) -> str:
        """获取 OAuth 2.0 凭证"""
        url = "https://aip.baidubce.com/oauth/2.0/token"
        params = {
            "grant_type": "client_credentials",
            "client_id": self.api_key,
            "client_secret": self.secret_key
        }
        res = requests.post(url, params=params, timeout=10)
        res.raise_for_status()
        return res.json().get("access_token")

    def image_to_excel(self, image_path: str, output_excel_path: str, max_retries: int = 30, interval: int = 2) -> bool:
        """
        完整流程:本地图片 -> 百度云解析 -> 保存为本地 Excel 文件
        :param image_path: 本地表格图片路径
        :param output_excel_path: 目标 Excel (.xlsx) 保存路径
        :param max_retries: 轮询最大次数(防止死循环)
        :param interval: 每次轮询间隔秒数
        """
        # 1. 读取图片并进行 Base64 编码
        with open(image_path, "rb") as f:
            image_base64 = base64.b64encode(f.read()).decode("utf-8")

        # 2. 提交异步任务
        request_url = f"https://aip.baidubce.com/rest/2.0/ocr/v1/form_ocr/request?access_token={self.access_token}"
        headers = {"Content-Type": "application/x-www-form-urlencoded"}
        payload = {"image": image_base64}

        req_res = requests.post(request_url, data=payload, headers=headers, timeout=15)
        req_res.raise_for_status()
        req_json = req_res.json()

        # 获取任务 ID
        result_info = req_json.get("result", {})
        request_id = result_info.get("request_id")
        if not request_id:
            raise RuntimeError(f"提交识别任务失败: {req_json}")

        print(f"[OK] 任务已提交,获取任务 ID: {request_id}")

        # 3. 轮询状态获取 Excel 下载链接
        result_url = f"https://aip.baidubce.com/rest/2.0/ocr/v1/form_ocr/get_request_result?access_token={self.access_token}"
        poll_payload = {
            "request_id": request_id,
            "result_type": "excel"  # 请求输出为 excel 格式
        }

        download_url = None
        for attempt in range(1, max_retries + 1):
            time.sleep(interval)
            poll_res = requests.post(result_url, data=poll_payload, headers=headers, timeout=15)
            poll_res.raise_for_status()
            poll_data = poll_res.json().get("result", {})

            ret_code = poll_data.get("ret_code")
            percent = poll_data.get("percent", 0)
            print(f"[轮询 {attempt}/{max_retries}] 当前状态码: {ret_code}, 进度: {percent}%")

            if ret_code == 3:  # 处理完成
                download_url = poll_data.get("result_data")
                break
            elif ret_code == 4:
                raise RuntimeError("云端解析表格失败,图片可能不包含有效表格或清晰度不足。")
            elif ret_code in (1, 2):
                continue
            else:
                print(f"未知状态响应: {poll_data}")

        if not download_url:
            raise TimeoutError("表格识别超时,未能获取结果文件。")

        # 4. 下载生成的 Excel 文件流并写入本地磁盘
        print(f"[OK] 获取到下载链接,开始写入文件: {output_excel_path}")
        excel_res = requests.get(download_url, timeout=30)
        excel_res.raise_for_status()

        with open(output_excel_path, "wb") as f:
            f.write(excel_res.content)

        print("[SUCCESS] Excel 文件已成功保存至本地!")
        return True

# 使用示例
if __name__ == "__main__":
    # 替换为在百度智能云控制台获取的密钥
    BAIDU_API_KEY = "YOUR_API_KEY"
    BAIDU_SECRET_KEY = "YOUR_SECRET_KEY"

    ocr_client = BaiduTableOCR(api_key=BAIDU_API_KEY, secret_key=BAIDU_SECRET_KEY)
    ocr_client.image_to_excel(
        image_path="sample_table.png",
        output_excel_path="output_table.xlsx"
    )
五、技术选型与关键参数对比
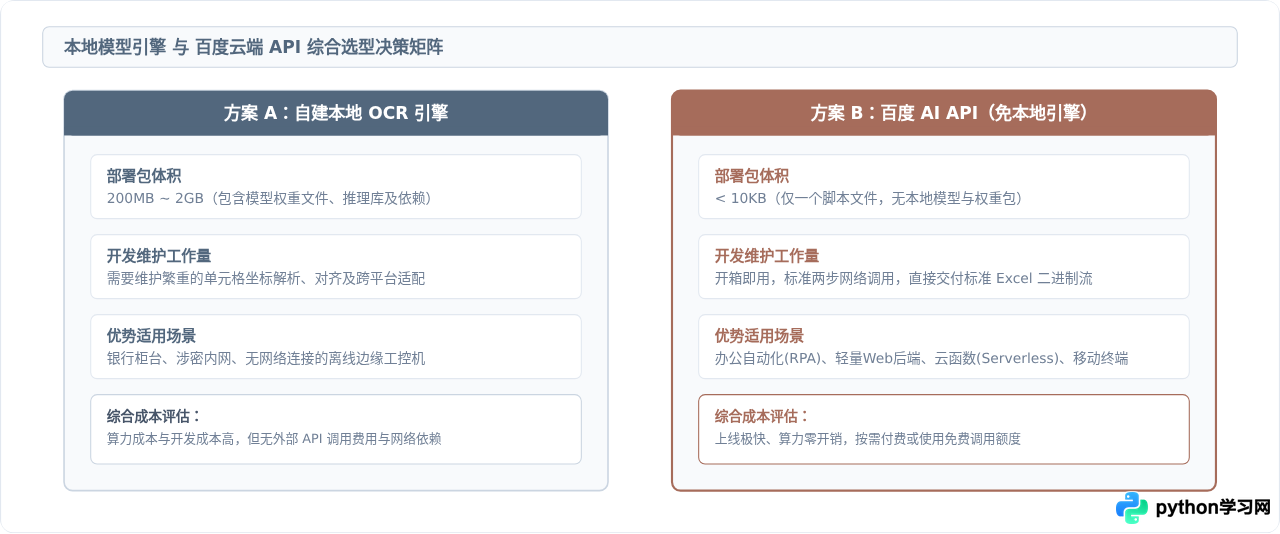
在设计系统技术方案时,工程团队常面临“自建本地 OCR 引擎”与“集成云端托管 API”的选型抉择。通过下表及对比维度图,可以清晰评估不同方案在不同业务场景下的综合表现。
| 对比维度 | 本地模型引擎(PaddleOCR / Tesseract) | 百度云端 API(免本地引擎) |
|---|---|---|
| 环境依赖与配置成本 | 极高。需编译底层 C++ 库,拉取 Python 复杂依赖,配置 CUDA / cuDNN 加速环境。 | 极低。仅依赖标准网络请求库(如 requests),零模型文件打包。 |
| 本地计算与显存消耗 | 高。模型推理时持续占用 500MB~2GB 内存/显存,CPU 占用率短时飙升。 | 几乎为零。本地仅负责 Base64 编码,占用内存微量(几 MB 内)。 |
| 表格合并与排版还原 | 需手写大量后处理算法,合并单元格与无边框表格容易错位。 | 高精度还原。服务端内置多模态表格重建算法,直接输出标准 .xlsx 格式。 |
| 网络条件要求 | 完全脱网可用,适合涉密局域网环境。 | 需要外网 HTTP 通信权限,若断网则无法使用。 |
六、生产实践中的关键避坑点
- 图片规格与预处理限制: 百度表格 OCR 对传入图片的规格有明确限制。图片的格式支持 PNG、JPG、JEPG、BMP;最短边不小于 15px,最长边不超过 4096px;Base64 编码后的文本大小不得超过 4MB。如果图片超大,应在本地先进行等比压缩。
-
Token 换取频次限制:
不要在每次执行表格识别时都调用一遍
/oauth/2.0/token。每个 Access Token 的默认有效周期长达 30 天,频繁重复请求鉴权接口不仅会导致额外的网络开销,还有可能触发百度的并发频控拦截。 -
超时与死循环防范:
云端服务在极少数极端情况下(如图片严重模糊无有效表格)可能会导致解析耗时过长或返回状态未知。在编写轮询代码时,务必设定
max_retries最大尝试次数和单次 HTTP 请求的timeout参数。 -
文件下载链接的时效性:
当轮询到
ret_code == 3时,返回的result_data下载链接具有时效限制(通常为数小时有效),因此在获取到链接后应立即下载落盘,避免延迟下载导致 403/404 错误。
七、总结
利用 Python 调用百度云表格识别 API,为办公自动化与轻量化图像转 Excel 提供了一种真正意义上的“免本地引擎”解决方案。它既规避了配置庞大 AI 框架与 GPU 加速环境的繁琐负担,又借助云端深度学习模型确保了多单元格合并与排版还原的准确性。开发者只需掌握基础的 Base64 编码与标准 HTTP 异步交互,即可轻松将复杂的图像表格转换流程无缝嵌入各类业务流水线中。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









