

Python模型加载报错怎么办?常见维度不匹配与环境依赖问题解决
针对Python深度学习中常见的模型权重加载报错,详细剖析张量维度不匹配、state_dict键名冲突、跨设备反序列化及环境依赖缺失的根因,并提供可直接执行的排查步骤、代码范例与验证清单。
一、维度不匹配与键名冲突的定位方法
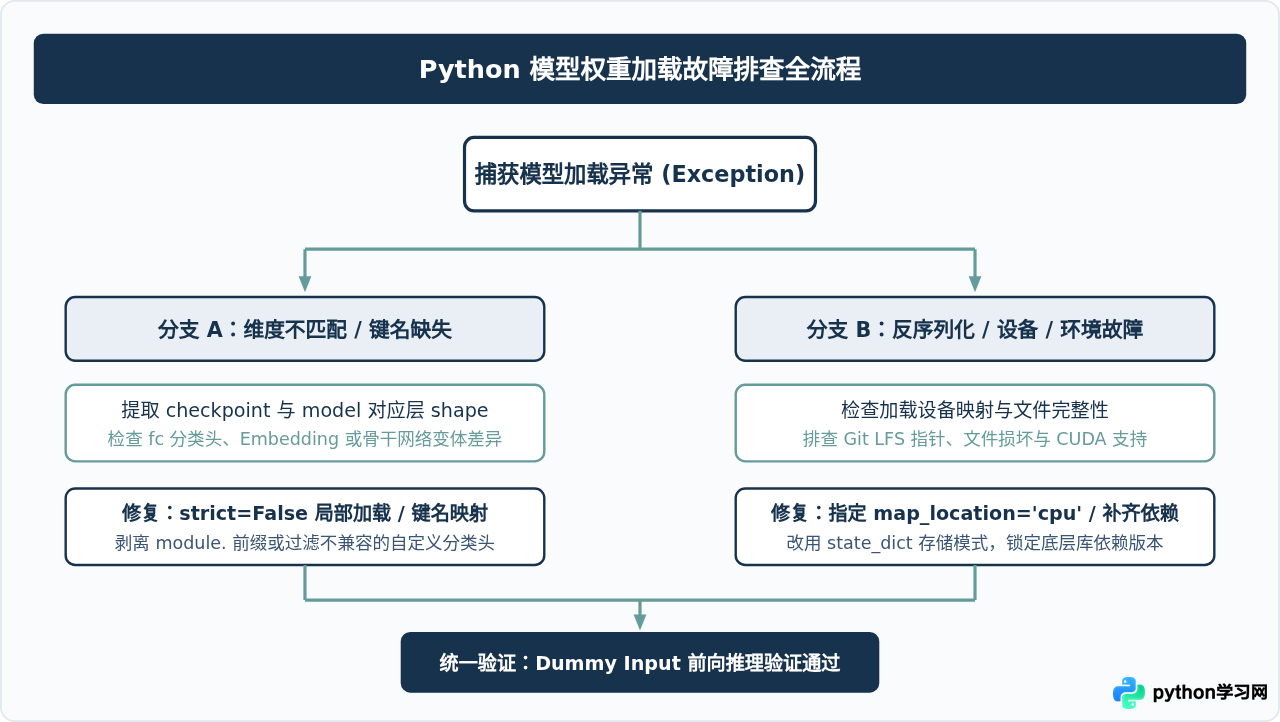
在 PyTorch 或 TensorFlow 中加载预训练权重时,最频繁遇到的异常是 RuntimeError: Error(s) in loading state_dict for ...。其中最典型的报错形态包含两种:一种是参数形状冲突,例如 size mismatch for fc.weight: copying a param with shape torch.Size([1000, 2048]) from checkpoint, the shape in current model is torch.Size([10, 2048]);另一种是键名不匹配,抛出 Missing key(s) 或 Unexpected key(s)。
这类报错的本质是目标网络对象的参数字典与磁盘权重文件所记录的结构存在断层。常见于迁移学习场景:研究者在标准 ResNet、BERT 或 ViT 架构后修改了最后的分类层(例如把 ImageNet 默认的 1000 类改为当前业务所需的 10 类),却直接调用了全量加载接口;或者原模型使用了多 GPU 训练,权重键名全部被冠以 module. 前缀,而在单卡或 CPU 推理环境下实例化的模型不具备该前缀结构。
二、维度对齐与权重过滤实战
当确认报错为最后一层或特定中间模块维度冲突时,盲目修改模型结构使其迎合权重是错误的,通常需要保留特征提取部分的预训练参数,同时丢弃形状不合的下游参数。
1. 针对性过滤不匹配张量
可以通过 Python 字典推导式,在加载前比对 checkpoint 与当前模型的 state_dict,仅保留键名相同且 shape 完全吻合的权重:
import torch
import torchvision.models as models

# 1. 实例化当前业务模型(例如 10 分类)
model = models.resnet50(num_classes=10)

# 2. 读取官方预训练权重(原为 1000 分类)
checkpoint = torch.load("resnet50_pretrained.pth", map_location="cpu")
pretrained_dict = checkpoint["state_dict"] if "state_dict" in checkpoint else checkpoint

# 3. 提取当前模型的参数状态
model_dict = model.state_dict()

# 4. 过滤出键名存在且形状完全一致的参数
matched_dict = {
    k: v for k, v in pretrained_dict.items()
    if k in model_dict and v.shape == model_dict[k].shape
}

# 5. 更新并以宽松模式写入
model_dict.update(matched_dict)
model.load_state_dict(model_dict, strict=False)

print(f"成功恢复权重参数: {len(matched_dict)} / {len(model_dict)}")
2. 统一清理多卡训练的 module. 前缀
如果报错原因是 Unexpected key(s) in state_dict: "module.conv1.weight",说明权重是在 torch.nn.DataParallel 模式下导出的。解决方式是在加载前使用键名替换剥离前缀:
clean_dict = {}
for k, v in pretrained_dict.items():
    # 移除 DataParallel 引入的 'module.' 前缀
    new_key = k[7:] if k.startswith("module.") else k
    clean_dict[new_key] = v

model.load_state_dict(clean_dict, strict=True)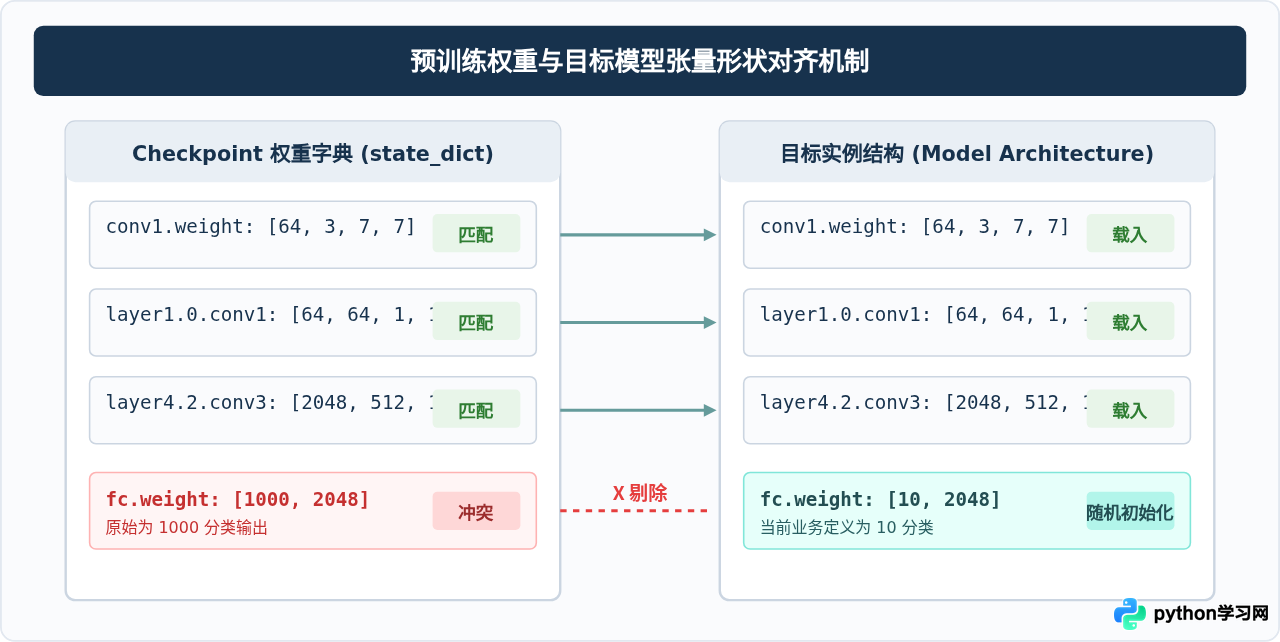
三、环境依赖与反序列化问题解决
除了网络形状层面的冲突,在跨开发机、跨硬件平台或跨项目代码迁移时,往往会触发由于反序列化与运行时环境不匹配导致的异常。
1. 跨设备映射问题(CUDA 与 CPU 冲突)
如果在 GPU 机器上保存模型,随后在没有安装 NVIDIA 显卡驱动或仅有 CPU 的测试服务器上加载,会抛出错误:
RuntimeError: Attempting to deserialize object on a CUDA device but torch.cuda.is_available() is False。
PyTorch 的 torch.load 默认会试图将张量反序列化回保存时记录的物理硬件设备上。解决该问题的标准操作是强制传入 map_location 参数:
# 无论权重保存于何种 GPU,均安全解压至系统内存中
device = torch.device("cuda:0" if torch.cuda.is_available() else "cpu")
checkpoint = torch.load("model_weights.pth", map_location=device)
2. 反序列化类丢失(对象存储与 state_dict 存储差异)
许多初学者直接使用 torch.save(model, "full_model.pth") 持久化整个模型对象,随后在推理脚本中调用 torch.load("full_model.pth"),结果抛出:
AttributeError: Can't get attribute 'MyCustomNet' on <module '__main__'> 或 ModuleNotFoundError。
这是因为 Python 标准 Pickle 协议在序列化对象实例时,并不存储类的源码逻辑,而只记录类所在的模块路径与属性字典。如果加载端执行脚本时没有在相同的命名空间导入该类,反序列化必然崩溃。
torch.save(model.state_dict(), path) 保存纯权重字典。加载端先实例化标准类,再灌入权重,彻底解耦代码与数据。
3. Git LFS 占位文件陷阱
若报错信息为 RuntimeError: PytorchStreamReader failed reading zip archive: failed finding central directory,除了文件网络传输不完整外,极常见的一个隐蔽原因是:模型文件托管在 Hugging Face 或 GitHub,使用者在执行 git clone 时未安装或未初始化 git lfs。此时下载下来的 .bin 或 .pth 文件实际上只是一个不足 1KB 的纯文本指针(Git LFS Pointer)。
核对方法非常简单:在终端查看文件大小,若模型只有几百字节,使用 cat model.pth 即可看到文本指针内容。执行 git lfs pull 即可拉取真实二进制权重。
四、模型加载全流程验证清单与决策矩阵
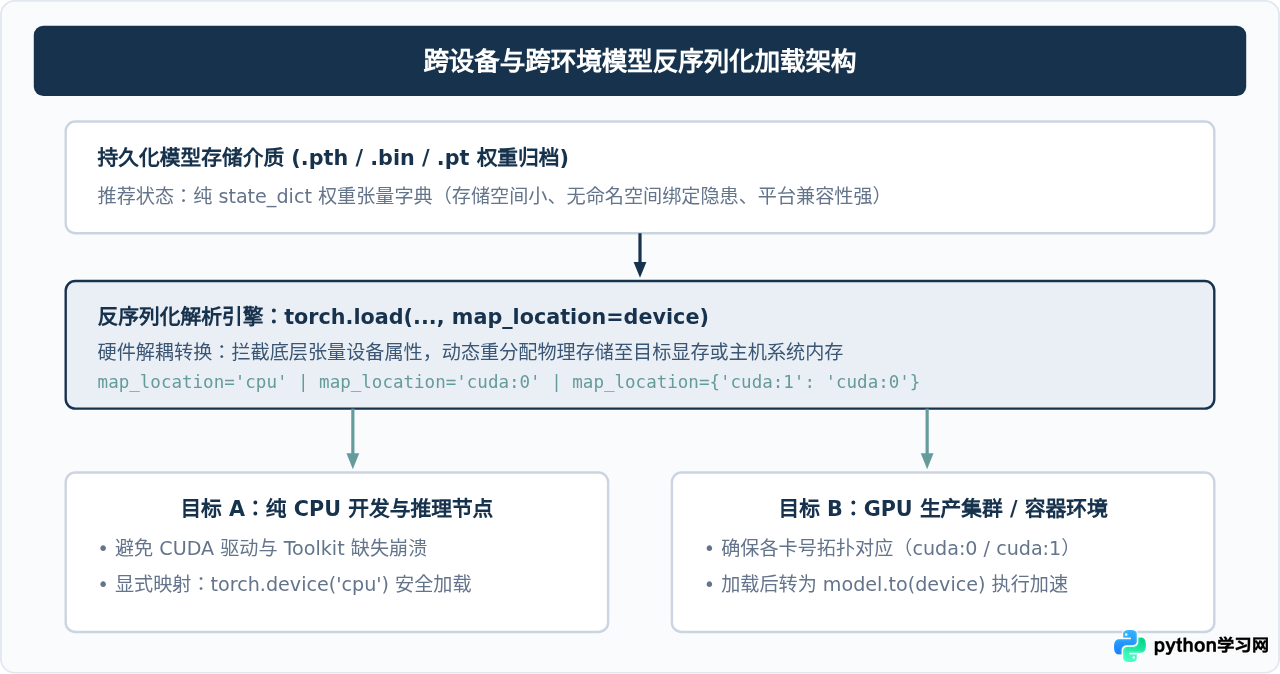
成功调用 load_state_dict(..., strict=False) 不抛出异常,并不代表模型已经能够按预期工作。为了杜绝“权重全被跳过、模型实际上在用随机初始化参数跑推理”的隐形故障,必须执行一套标准的前向验证步骤。
1. 加载完成后的前向推理验证
编写专门的验证断言,构造单条虚拟输入张量(Dummy Input)执行前向传播,校验输出维度并确保没有遗漏权重的异常 NaN 传播:
def verify_model_integrity(model, input_shape=(1, 3, 224, 224), expected_classes=10):
    model.eval()
    device = next(model.parameters()).device
    dummy_input = torch.randn(*input_shape, device=device)

    with torch.no_grad():
        output = model(dummy_input)

    # 验证输出维度
    assert output.shape == (1, expected_classes), \
        f"输出维度不符预期: 期望 (1, {expected_classes}),实际得到 {output.shape}"

    # 验证数值有效性
    assert not torch.isnan(output).any(), "模型前向传播产生了 NaN 异常值!"
    print("模型加载与前向推理验证通过,状态正常。")

# 执行验证
verify_model_integrity(model)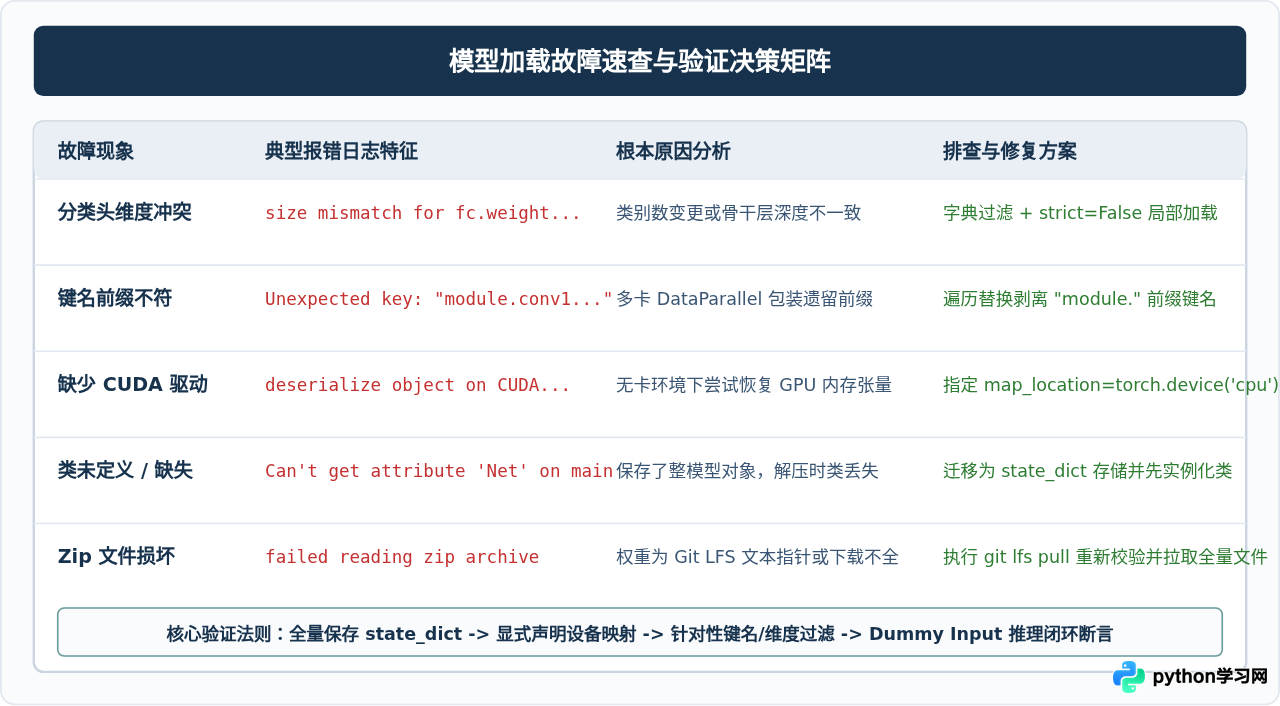
五、结语与最佳实践总结
排查模型加载故障,关键在于区分是张量数据层的“形状差异”还是代码环境层的“反序列化断层”。在实际工程研发中,遵循以下规范能够避免 90% 以上的模型加载问题:
- 只存权重,不存实例:模型持久化阶段统一执行
torch.save(model.state_dict(), path),使模型权重成为独立于代码上下文的纯数值文件。 - 防御性加载:在加载代码中显式指定
map_location,避免对物理 GPU 环境形成隐式强依赖。 - 透明过滤与日志打印:在做迁移学习修改网络头时,不要直接依赖
strict=False忽略一切,应主动统计并打印出匹配成功的参数列表与被丢弃的参数列表,确认被忽略的仅为预期的输出层。 - 推理闭环验收:在加载完成后立即使用测试张量进行一次前向推理验证,确认输出维度的准确性与数值的稳定性。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









