

Python常用数据结构性能对比:列表、字典、集合的增删查效率
全面对比分析 Python 中列表、字典与集合在增、删、查等核心操作中的性能表现与时间复杂度,深入底层数据结构原理剖析差异根源,并提供工程选型指南与避坑建议。
在 Python 开发中,列表(list)、字典(dict)和集合(set)是最基础且高频使用的内置容器。许多初学者在编写代码时习惯依据直觉选择结构,例如使用列表保存所有数据并频繁执行成员查找 item in my_list,但在数据量上升到数万甚至数百万级时,程序运行速度往往会出现数百倍的骤降。理解这三种数据结构在增加、删除和查找操作上的性能差异与时间复杂度,是写出高性能 Python 代码的前提。本文将深入拆解三者的底层机制,给出量化性能对比与实用的工程选型决策。
一、底层存储结构与寻址机制原理
性能差异的根本原因在于 CPython 底层对三者的内存组织方式存在本质区别。列表基于连续内存的动态数组实现,而字典和集合则基于哈希散列表(Hash Table)实现。
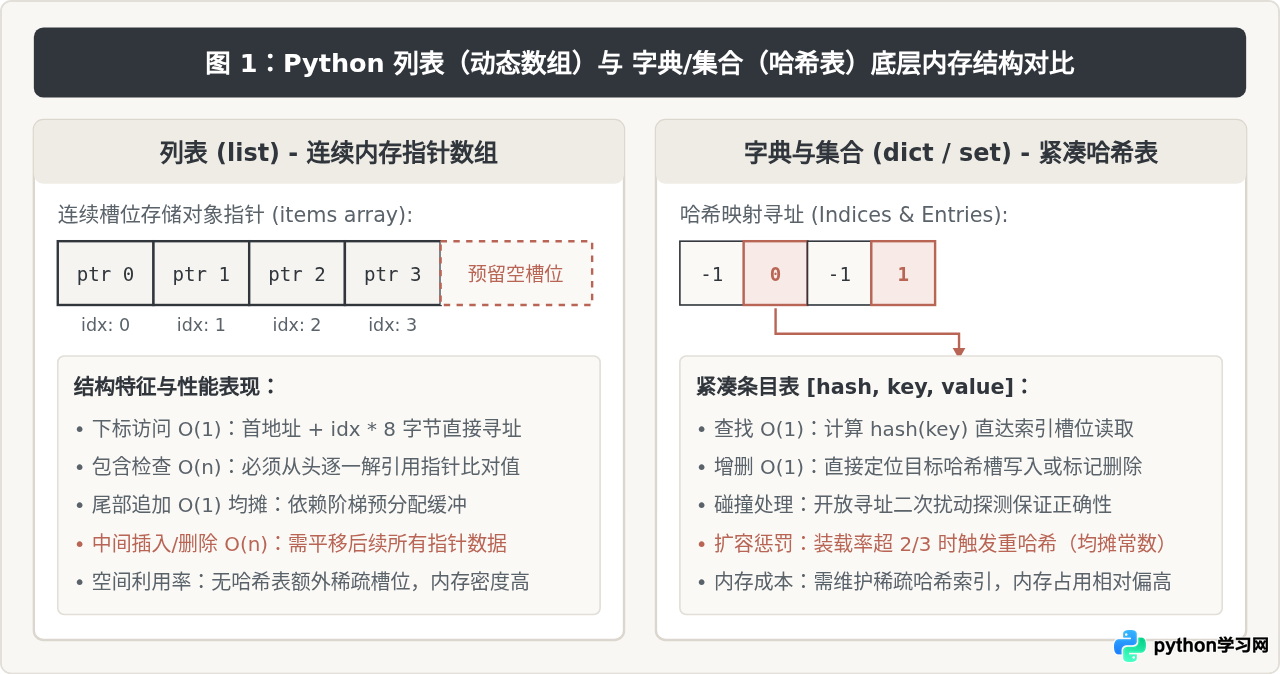
在 CPython 实现中,列表是一个名为 PyListObject 的结构体。它内部维护着一段连续的指针内存块,每个槽位存放的是指向实际 Python 对象的内存地址。因为数组内存地址连续,通过下标索引访问(如 my_list[i])只需要通过简单的基地址加上偏移量即可直达目标,耗时是恒定的常数时间。但在判断某个元素是否存在时,列表无法得知元素存储在哪个具体槽位,必须从第 0 个槽位开始逐个比对对象的值,直到找到匹配项或遍历完整个数组。
字典与集合在底层使用哈希散列表。自 Python 3.6 引入紧凑字典(Compact Dict)设计后,字典结构被拆分为稀疏哈希索引表与紧凑键值实体表两部分。当向字典或集合存入元素时,Python 首先调用对象的 hash() 函数计算出一个整数哈希值,再通过位运算映射到索引表中。查找元素时,直接根据哈希值直达对应槽位,无需扫描无关元素。集合在底层实现上相当于没有存储关联值、仅保存键的简化版哈希表。
二、查找效率对比:线性扫描 vs 哈希直接定位
查找操作是区分列表与字典、集合性能最显著的场景。在日常开发中,查找操作通常分为两类:一是成员资格判定(x in container),二是键/索引值读取(container[key] 或 container[idx])。
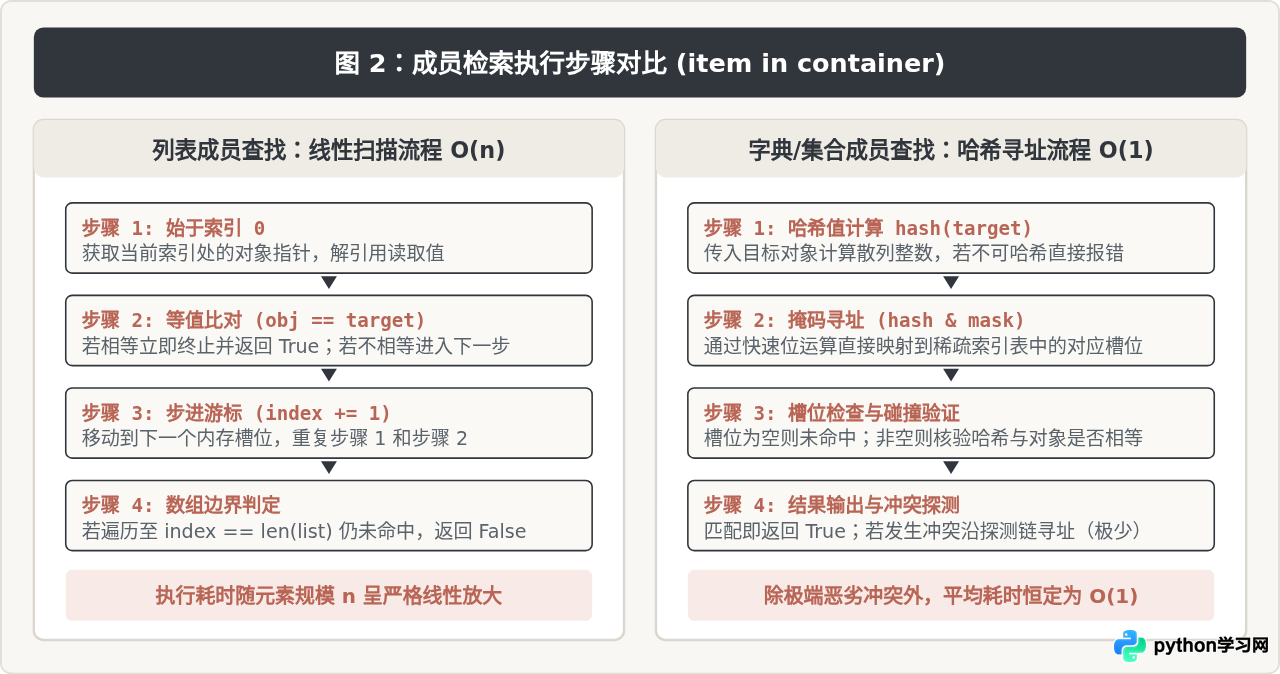
对于列表:
- 通过下标随机读取(如
my_list[5000]):底层执行一步乘加运算定位内存地址,时间复杂度为O(1),极度高效。 - 通过内容判断存在性(如
target in my_list)或查找元素索引(my_list.index(target)):列表必须从下标 0 开始依次将每个元素与target调用__eq__进行比对。最好情况下目标在头部耗时O(1),最坏情况下目标在尾部或不存在耗时O(n),平均耗时为O(n)。
对于字典和集合:
- 检查某个键或元素是否存在(
key in my_dict或val in my_set):直接通过hash()计算哈希值,并在哈希表中一步到位命中。除了极端恶意的哈希碰撞外,平均时间复杂度恒为O(1),与容器中存储了 10 个元素还是 10,000,000 个元素几乎无关。
下面这段代码可以清晰印证两者在 10 万数据规模下的性能鸿沟:
import timeit

# 准备包含 100,000 个整数的测试容器
size = 100_000
data_list = list(range(size))
data_set = set(data_list)
data_dict = {i: None for i in data_list}

# 查找容器末尾的元素(最坏情况/接近平均情况)
target = 99_999

list_time = timeit.timeit(lambda: target in data_list, number=1_000)
set_time = timeit.timeit(lambda: target in data_set, number=1_000)
dict_time = timeit.timeit(lambda: target in data_dict, number=1_000)

print(f"列表 1000 次查找总耗时: {list_time:.4f} 秒")
print(f"集合 1000 次查找总耗时: {set_time:.6f} 秒")
print(f"字典 1000 次查找总耗时: {dict_time:.6f} 秒")

# 典型输出示例(因机器性能略有波动):
# 列表 1000 次查找总耗时: 1.1523 秒
# 集合 1000 次查找总耗时: 0.000045 秒
# 字典 1000 次查找总耗时: 0.000048 秒
在十万量级下,集合与字典的成员查找速度是列表的 20,000 倍以上。当数据量扩大到百万级时,列表查找耗时将按比例继续扩大,而集合与字典的耗时依旧保持在微秒级。
三、增加与插入操作对比:尾部追加 vs 任意插入 vs 哈希装载
向数据结构中添加元素时,操作位置和内存重分配逻辑直接决定了执行效率。
1. 列表的追加与插入
列表提供了 append() 与 insert() 两种增加方法:
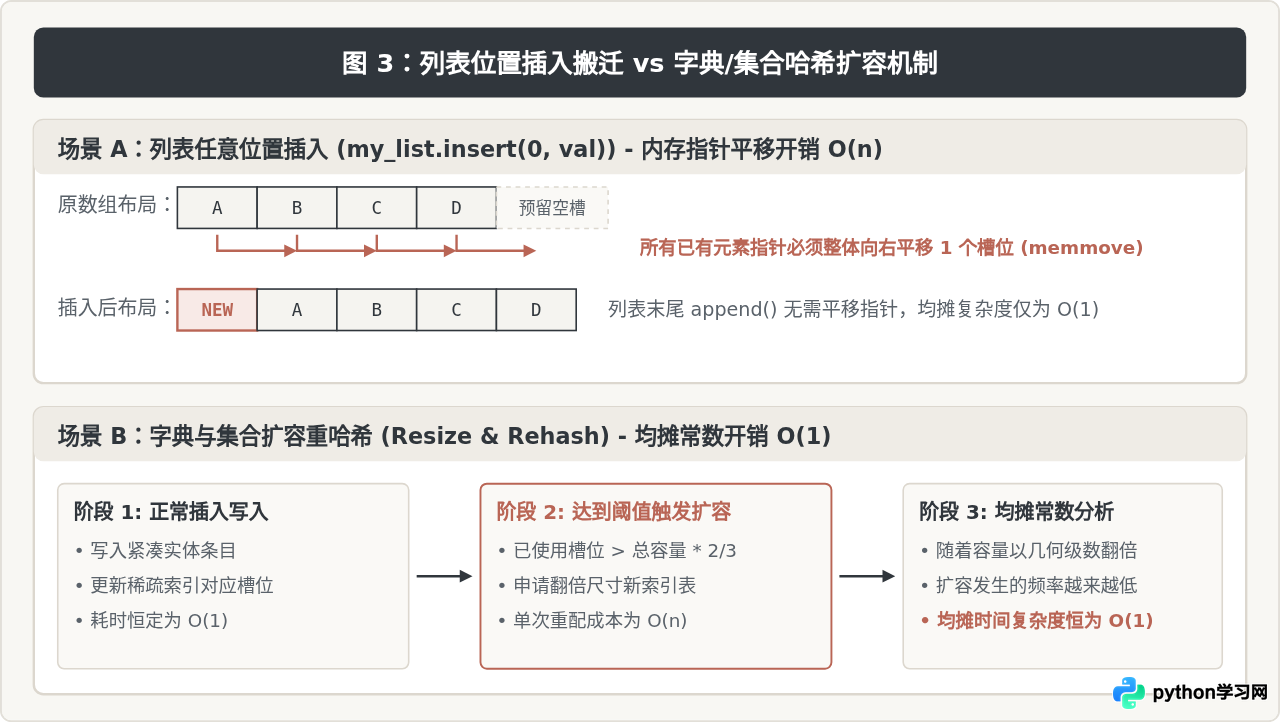
my_list.append(item):向列表末尾添加元素。CPython 采用了超额分配机制(Over-allocation)。当内部连续内存用尽时,列表不会只增加 1 个槽位,而是按照一定增长公式(如容量阶梯0, 4, 8, 16, 25, 35, 46, 58...)预先申请更大的内存块。因此绝大多数append()调用只需要在预分配的下一个空槽位写入指针,耗时仅为O(1);只有在偶尔触发内存重新分配与数据搬迁时才会耗时稍长。综合来看,尾部追加的均摊时间复杂度(Amortized Time)为稳定的O(1)。my_list.insert(0, item)或my_list.insert(idx, item):在指定位置插入元素。因为动态数组在物理内存中必须保持绝对连续,在头部或中间插入新元素时,必须将目标位置之后的所有已有元素指针向后移动一个槽位。在第 0 位插入长度为n的列表,必须执行n次指针搬移,时间复杂度严格为O(n)。
2. 字典与集合的写入与扩容
字典的赋值(my_dict[key] = value)和集合的添加(my_set.add(item))流程相同:
- 根据
hash(key)定位槽位。若键已存在则更新值;若不存在则在紧凑实体数组末尾追加条目,并将实体数组的下标写入稀疏哈希索引表中。平均时间复杂度为O(1)。 - 装载因子与重哈希(Rehashing):为了避免哈希冲突严重退化性能,Python 规定当哈希表的装载因子(已用槽位占总槽位比例)达到 2/3 时,便会触发扩容。扩容时会申请一块翻倍的哈希表空间,并将所有有效条目重新计算映射。尽管单次扩容开销较大,但均摊到每次添加操作后,字典与集合的增加操作依然保持在
O(1)均摊常数级别。
四、删除操作效率分析:尾部弹出 vs 中间移除 vs 哈希删除
与添加操作类似,删除元素的效率高度依赖于底层数据是否需要“填补空缺”或维持特定存储顺序。
1. 列表删除操作
my_list.pop():从列表末尾弹出一个元素。仅需递减列表长度计数器并释放末尾指针,无需移动任何内存数据,耗时为O(1)。my_list.pop(0)或del my_list[0]:从头部删除元素。为了填补第 0 位的空缺,其后所有n - 1个元素的指针必须全部向左平移一个槽位,时间复杂度为O(n)。my_list.remove(value):按值删除。首先执行线性扫描找到首个匹配项(平均耗时O(n)),随后将其后方的所有元素向左移动平移填补空位(耗时O(n)),总耗时为严格的O(n)。
2. 字典与集合删除操作
del my_dict[key]/my_dict.pop(key):通过hash(key)定位槽位,在实体数组中将其标记为 Dummy 废弃节点或在紧凑表中调整索引。无需对其他已有元素进行整体物理平移,平均耗时为O(1)。my_set.remove(val)/my_set.discard(val):同样直接通过哈希定位槽位清除元素,平均时间复杂度为O(1)。
注意:如果你的业务逻辑需要频繁从集合前端取出元素(例如实现一个先进先出的 FIFO 队列),切勿使用 my_list.pop(0)。在包含 10 万个任务的队列中,循环调用 pop(0) 会产生 100 亿次指针移动,导致严重卡顿。此时应使用标准库中的 collections.deque(双端队列),其首尾弹出操作均为原生的 O(1)。
五、全维度性能汇总与工程选型指南
综合以上各维度的底层实现与效率分析,我们将三种数据结构核心操作的平均时间复杂度与最坏情况总结在下表中:
| 操作行为 | 列表 (list) | 字典 (dict) | 集合 (set) |
|---|---|---|---|
| 读取元素 | 下标访问 O(1) |
按键访问 O(1) (最坏 O(n)) |
不支持随机直接读取 |
| 查找/判断 (in) | 线性扫描 O(n) |
哈希定位 O(1) (最坏 O(n)) |
哈希定位 O(1) (最坏 O(n)) |
| 末尾追加 / 存入 | append() 均摊 O(1) |
dict[k]=v 均摊 O(1) |
add() 均摊 O(1) |
| 头部/中间插入 | insert(i, v) 严格 O(n) |
不支持位置插入(维持插入序) | 无序存储,无位置插入概念 |
| 末尾删除 / 弹出 | pop() O(1) |
popitem() O(1) |
pop() 任意弹出 O(1) |
| 头部/按值删除 | pop(0) / remove() O(n) |
按键删除 del[k] O(1) |
按值删除 remove() O(1) |
| 内存开销密度 | 高(纯指针数组,紧凑省内存) | 中偏低(需保留稀疏哈希索引表) | 中偏低(需保留哈希表槽位开销) |
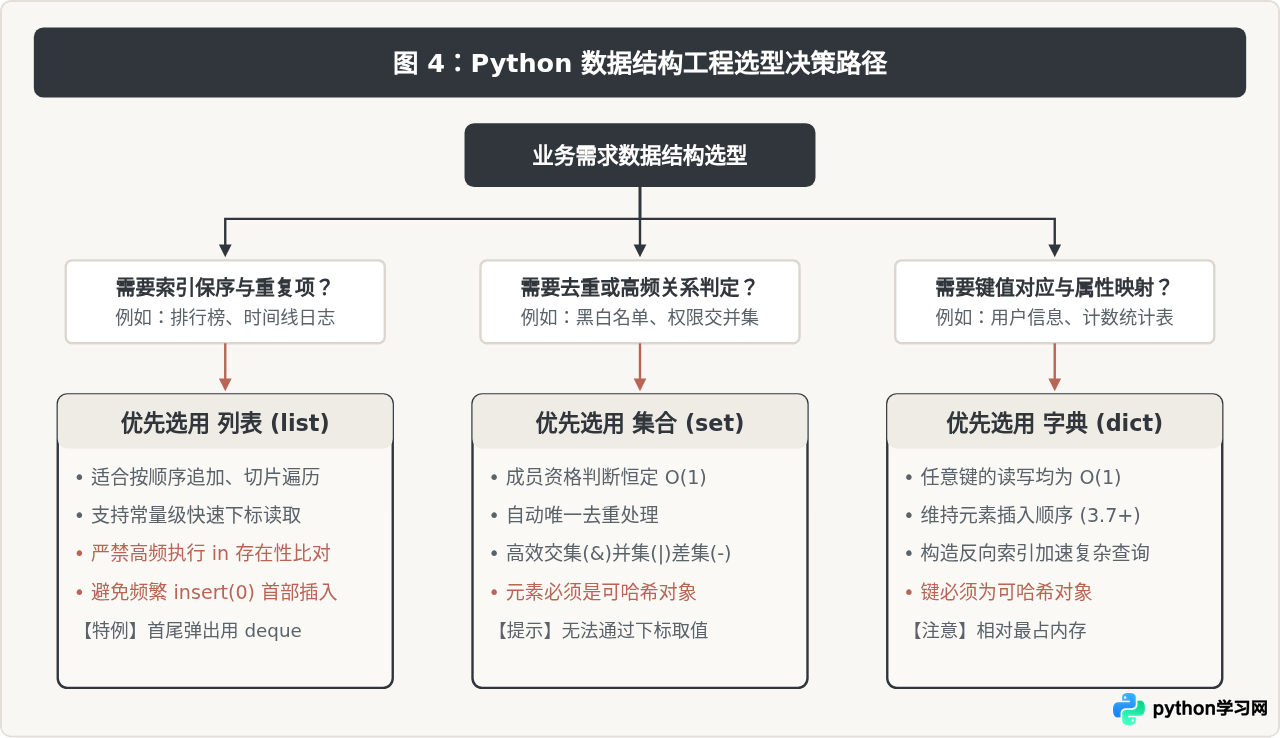
六、工程实践中的避坑与优化指南
1. 循环内切忌使用列表做包含判定
在批量过滤数据时,常见的反模式是在循环体内部反复对列表执行 in 查询,这会导致整体算法复杂度直接劣化为 O(m * n):
# 糟糕写法:在包含 50,000 个元素的白名单列表中循环查找
valid_users = [...] # 列表,长度 50,000
log_records = [...] # 日志,长度 100,000

# 整体操作需要比对 50,000 * 100,000 = 50 亿次,可能卡顿数分钟
filtered = [r for r in log_records if r.user_id in valid_users]

# 优化写法:在循环前一次性将列表转换为集合,将查找降为 O(1)
valid_users_set = set(valid_users) # 一次性转换 O(n)
# 整体耗时仅需 100,000 次 O(1) 查找,瞬间完成(几毫秒)
filtered = [r for r in log_records if r.user_id in valid_users_set]
2. 可哈希性(Hashable)约束
字典的键和集合的元素必须是可哈希对象(实现了 __hash__() 与 __eq__() 方法且哈希值在生命周期内不可变)。基本类型如整数、浮点数、字符串、元组(其内部元素也必须可哈希)均可作为键;但列表、字典、集合本身是可变容器,无法直接作为键或集合元素。若确实需要将列表作为集合元素或字典键,可先使用 tuple(my_list) 将其冻结为不可变元组,或使用 frozenset 代替 set。
3. 空间换时间的权衡考虑
哈希表虽然拥有常数级的增删查速度,但代价是较高的内存开销。在内存极度受限的嵌入式设备或海量数据处理场景下:
- 若数据规模在数十到数百以内,列表的紧凑内存和缓存局部性(Cache Locality)往往表现极佳,遍历比对的绝对耗时甚至低于哈希函数计算的开销。
- 当数据量超过千级且需要频繁检索或去重时,坚决选用集合与字典,避免用低效的算法去换取微弱的内存节省。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









