

解决Python报错:AttributeError:'NoneType' object has no attribute 'lower'
针对Python常见报错AttributeError: 'NoneType' object has no attribute 'lower',深入分析发生原因,提供排查路径、多种修复代码方案与预防机制。
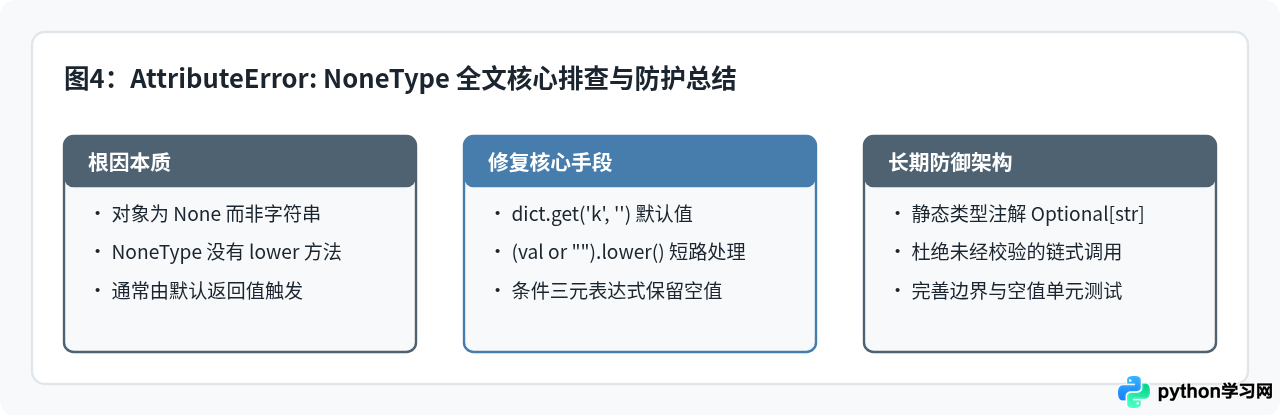
这个报错的核心原因非常直接:程序试图对一个值为 None 的变量调用字符串专属的 .lower() 方法。在 Python 中,None 是空值对象(其类型为 NoneType),它并不具备字符串的小写转换功能。解决该问题的关键不是修改 .lower() 的调用语法,而是确认该变量为什么会变成 None,并在调用转换前加入安全防护或默认值回退。
一、报错的触发机制与本质原因
当 Python 解释器执行到形如 value.lower() 的代码时,它会首先检查变量 value 的类型。如果 value 包含的是字符串(如 "Hello"),调用将正常返回小写结果 "hello";但如果 value 的实际值是 None,解释器查找不到 lower 属性,便会立刻中断并抛出:
AttributeError: 'NoneType' object has no attribute 'lower'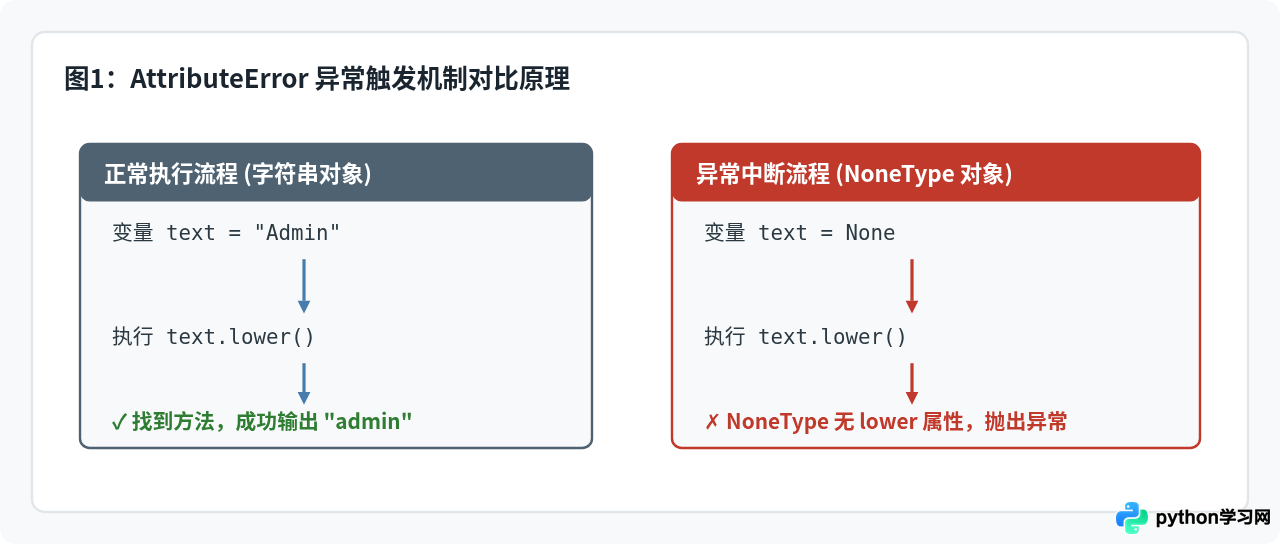
变量之所以会退化为 None,通常出现在以下三类业务场景中:
- 字典取值缺失:使用
dict.get('key')提取不存在的键,当未指定默认值时,方法会隐式返回None。 - 函数缺少有效返回值:调用的自定义函数内部执行了未带有具体值的
return,或函数执行完毕没有写return语句。 - 外部数据源空值:从数据库查询为 NULL 的字段,或解析含空字段的 JSON 数据、Pandas DataFrame 中的缺失数据。
二、四步系统排查路径
当终端出现报错回溯(Traceback)时,按由近及远的顺序排查最为高效。不要急于加 try-except 屏蔽错误,应准确定位 None 的来源。
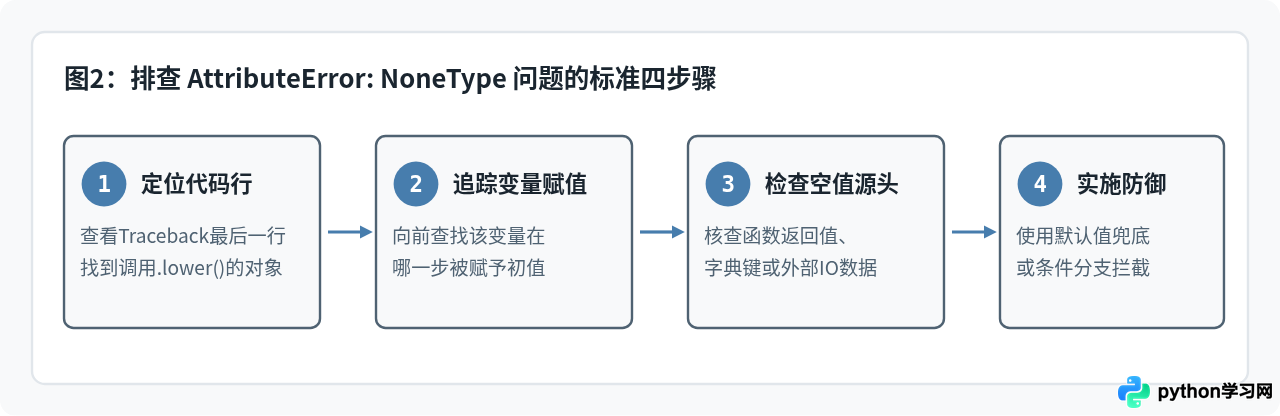
- 查看堆栈最底层代码行:在报错输出的最下方找到具体发生异常的文件路径与行号。
- 识别调用主体:查看该行中究竟是哪一个标识符在点选
.lower()。例如user.get("role").lower()中,None是来自user.get("role")的执行结果。 - 探查源头数据流:在该行上方插入调试语句
print(f"DEBUG: raw_value={raw_value!r}"),观察传入的真实内容。 - 核实业务逻辑:判断这里的空值是预期内的可选缺失(如选填字段),还是由于代码漏洞意外返回了空值。
三、常见场景与具体修复代码
场景 1:字典取值缺失
当使用 dict.get() 获取可能不存在的配置或属性时,默认返回 None,直接连缀 .lower() 会立刻崩溃。
# 错误示例:key 不存在时返回 None,直接触发报错
data = {"username": "Alice"}
role = data.get("role").lower()

# 正确做法:在 get() 中提供默认空字符串 ""
data = {"username": "Alice"}
role = data.get("role", "").lower()
print(f"角色: {role}")  # 输出空字符串,安全无报错
场景 2:变量可能为 None 时的条件判断与短路运算
如果变量来自于函数传参或数据库接口,可能合法地包含 None。可以通过显式条件分支或 Python 的 or 运算符进行防范。
# 方案 A:使用 if 判定对象有效性
def normalize_tag(tag):
    if tag is not None:
        return tag.lower()
    return ""

# 方案 B:使用 or 提供默认字符串兜底
def normalize_tag_short(tag):
    # 若 tag 为 None,(tag or "") 的计算结果为空字符串 ""
    return (tag or "").lower()

# 示例验证
print(normalize_tag_short("Python"))  # 正常输出: python
print(normalize_tag_short(None))      # 安全输出: ""
场景 3:处理列表或 Pandas 序列中的空值
处理批量数据时,只要其中一条为 None,循环就会中断。可以使用列表推导式过滤或借助 Pandas 内置方法清洗。
# 列表批量处理:在推导式中增加过滤
raw_inputs = ["Admin", None, "GUEST", "User"]

# 方式一:跳过 None 项
cleaned = [item.lower() for item in raw_inputs if item is not None]
# 结果: ['admin', 'guest', 'user']

# 方式二:保留位置,None 转为空字符或其他默认值
normalized = [item.lower() if item is not None else "" for item in raw_inputs]
# 结果: ['admin', '', 'guest', 'user']df['column'].str.lower(),它会自动将缺失值保留为 NaN 而不会抛出 AttributeError。
四、三种常见修复方案对比
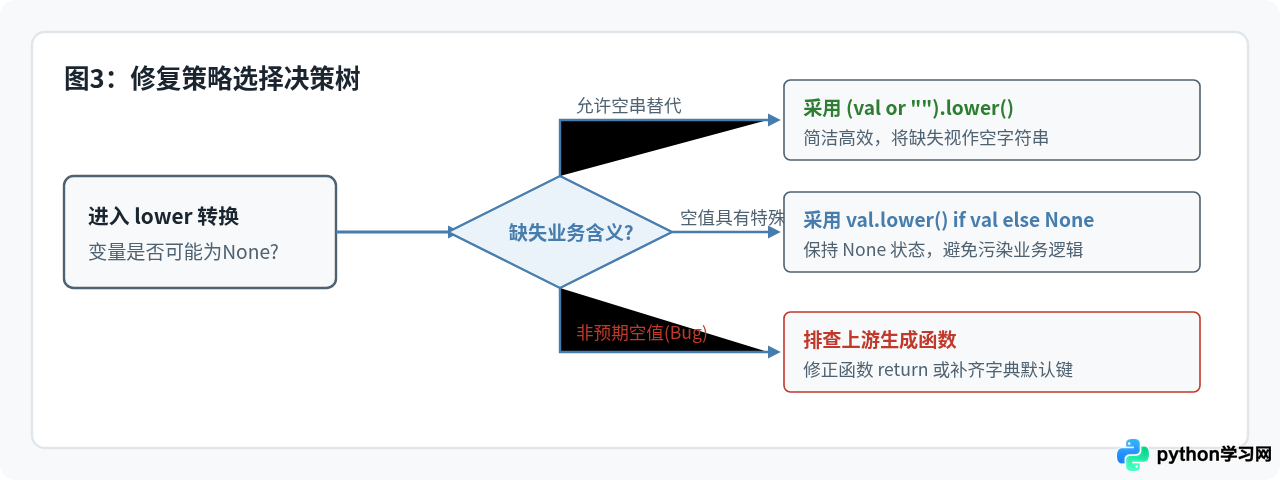
针对不同容错等级和语义要求的代码,采用的修复手段各有利弊。下面的决策图帮助你为当前代码选取恰当的方案:
五、预防措施与总结
为了在工程开发中彻底避免此类 AttributeError 异常,推荐遵循以下编码规范:
- 启用类型注解(Type Hints):在函数签名中明确标注参数类型,使用
Optional[str]或str | None(Python 3.10+),静态检查工具(如 Mypy、Pylance)会在代码编写阶段直接提示潜在的None调用风险。 - 谨慎使用链式调用:避免在未经校验的对象上执行深度链式操作,例如
res.get("data").get("name").lower()。任何一环返回None都会导致后续语句直接崩溃。 - 编写单元测试:对接收外部输入或包含可选字段的数据处理函数,专门添加传入
None的边界测试用例。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









