

Python源文件中文乱码报错怎么解决
针对Python源文件中出现的中文语法报错与终端运行乱码问题,系统解析从文件保存编码、解释器编码声明到终端输出环境的排查步骤与完整解决方案。
编写 Python 脚本时,只要在源码中包含中文注释或中文字符串,经常会遭遇两类问题:一类是运行前解释器直接抛出 SyntaxError 语法错误中断执行,另一类是代码正常运行但在终端输出一堆问号、乱码或触发 UnicodeEncodeError。彻底解决这个问题的核心在于理顺“源文件物理存储编码”、“解释器解析编码声明”以及“运行终端输出编码”三者之间的对应关系。最通用的标准做法是:将源文件统一保存为无 BOM 的 UTF-8 格式,并在必要时在文件首行添加编码声明 # -*- coding: utf-8 -*-,同时确保运行终端支持 UTF-8 显示。
一、常见中文报错的表现与原因排查
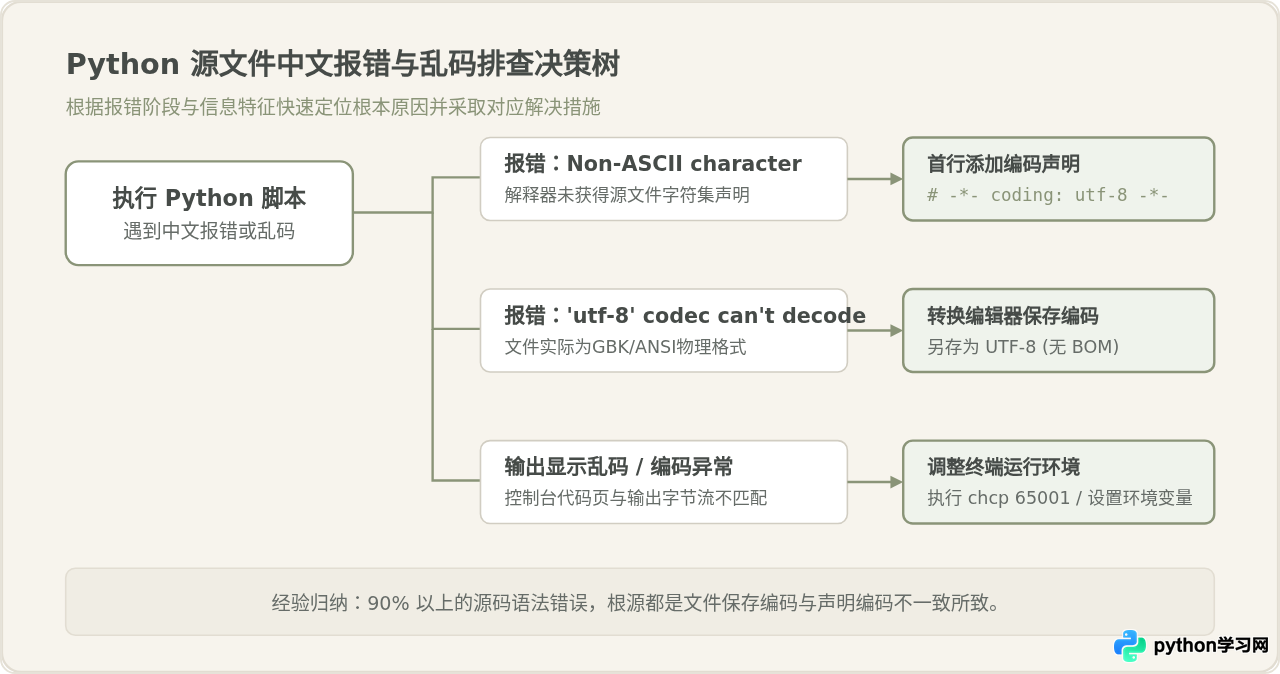
不同版本的 Python 以及不同的操作系统环境下,中文问题呈现的报错日志有所不同。排查时必须先根据终端抛出的具体异常信息,准确区分问题发生在“代码语法解析阶段”还是“运行时控制台输出阶段”。
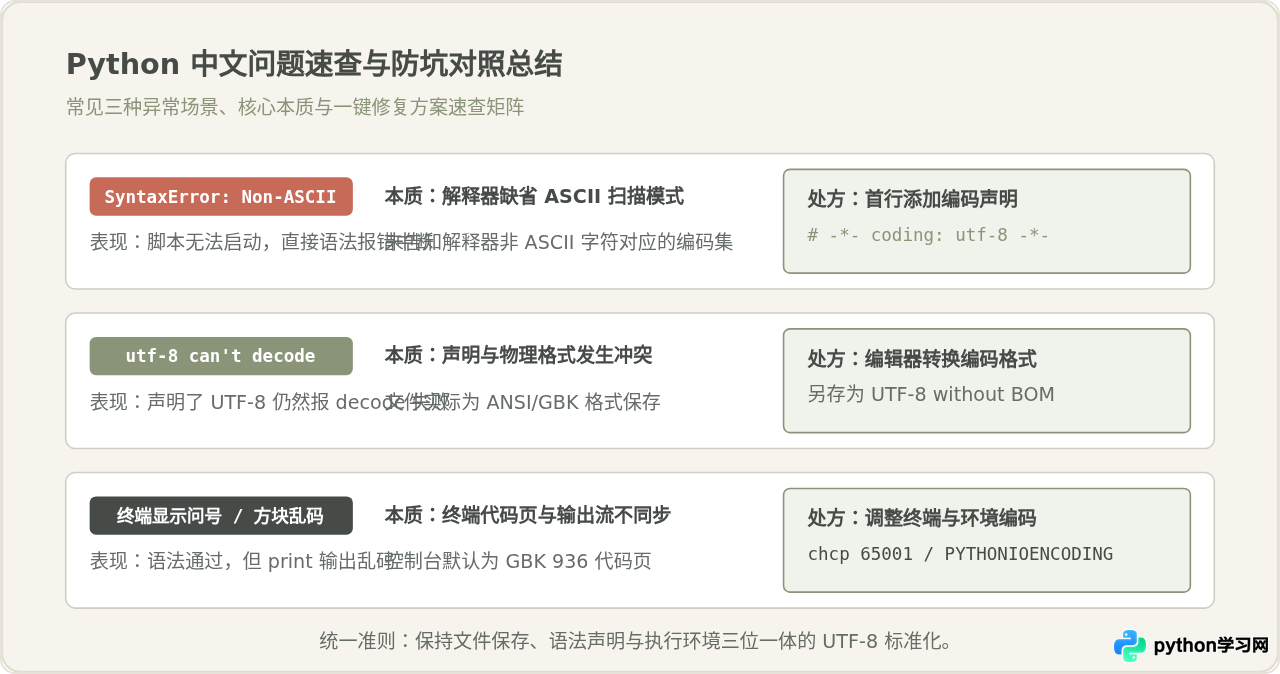
1. SyntaxError: Non-ASCII character
SyntaxError: Non-ASCII character '\xe4' in file test.py on line 3, but no encoding declared; see http://python.org/dev/peps/pep-0263/ for details原因剖析:该报错多见于 Python 2 或某些特定运行环境。根据 Python 规范(PEP 263),如果源码中包含了非 ASCII 字符(例如中文字符、汉字标点),而文件头部没有显式声明字符编码,解释器默认仅按 7-bit ASCII 编码进行词法扫描,一旦读到大于 127 的字节码就会直接终止并报错。
2. SyntaxError: (unicode error) 'utf-8' codec can't decode byte
SyntaxError: (unicode error) 'utf-8' codec can't decode byte 0xd6 in position 0: invalid continuation byte原因剖析:在 Python 3 中,默认的源文件编码是 UTF-8。如果你在 Windows 平台使用系统自带记事本或某些旧版编辑器保存脚本,编辑器往往默认采用系统的 ANSI(在简体中文 Windows 下是 GBK/CP936)格式保存。Python 3 解释器尝试用 UTF-8 解码这些 GBK 字节时,必然发生解码失败并报错。
3. 控制台打印问号、方块乱码或 UnicodeEncodeError
UnicodeEncodeError: 'gbk' codec can't encode character '\u2022' in position 4: illegal multibyte sequence原因剖析:代码通过了语法解析,但当使用 print() 将中文字符串输出到标准输出流时,宿主控制台(如 Windows 默认的 cmd 或旧版 PowerShell)的代码页仍是 GBK,若遇到终端编码映射表里不存在的字符,就会抛出编码异常或将字符显示为乱码方块。
二、核心机制解析:中文字符处理的三层编码链路
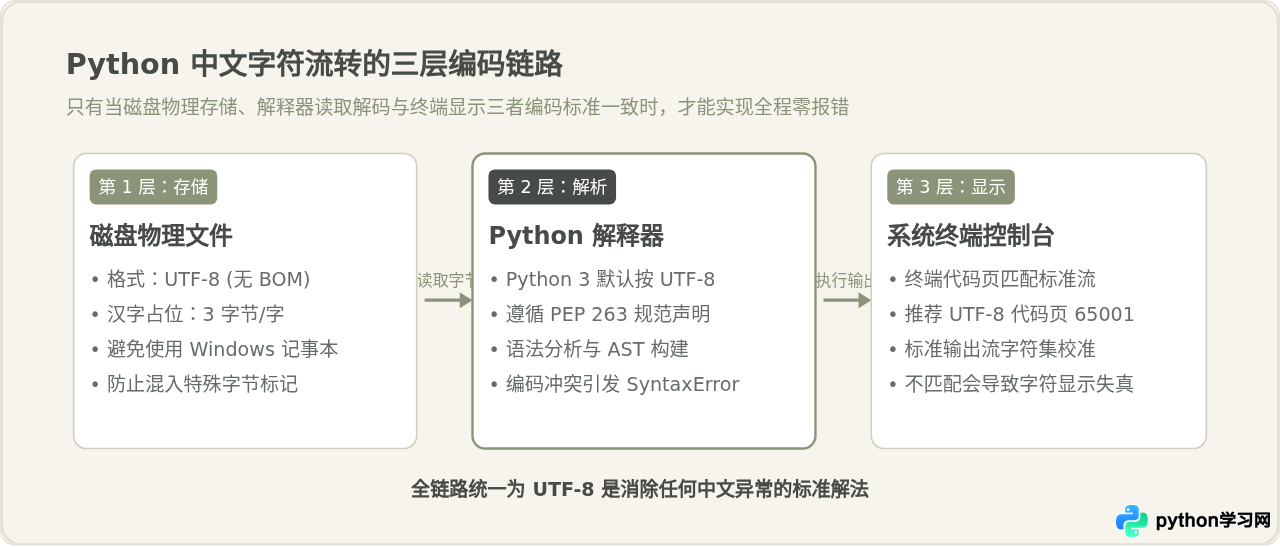
为了从根本上规避问题,需要理解一段包含中文字符的 Python 代码是如何从硬盘被读入内存并最终显示在屏幕上的。整个过程分为三个独立而连贯的阶段:
- 磁盘存储层(物理字节):源代码保存在硬盘上时,字符必须按某种规则转换为二进制字节。UTF-8 编码下每个汉字通常占 3 个字节,而 GBK 编码下每个汉字占 2 个字节。
- 解释器解析层(语法分析):Python 启动并读取脚本文件时,必须知道按哪种规则将这些字节重新还原成文本。Python 3 默认按 UTF-8 读取;如果文件头部写了
# -*- coding: ... -*-,解释器将严格按声明的编码读取。 - 环境交互层(终端渲染):代码执行
print()输出字符串时,操作系统终端接管显示。如果终端的显示解码机制与输出流不同步,就会呈现乱码。
三、解决步骤与具体操作指南
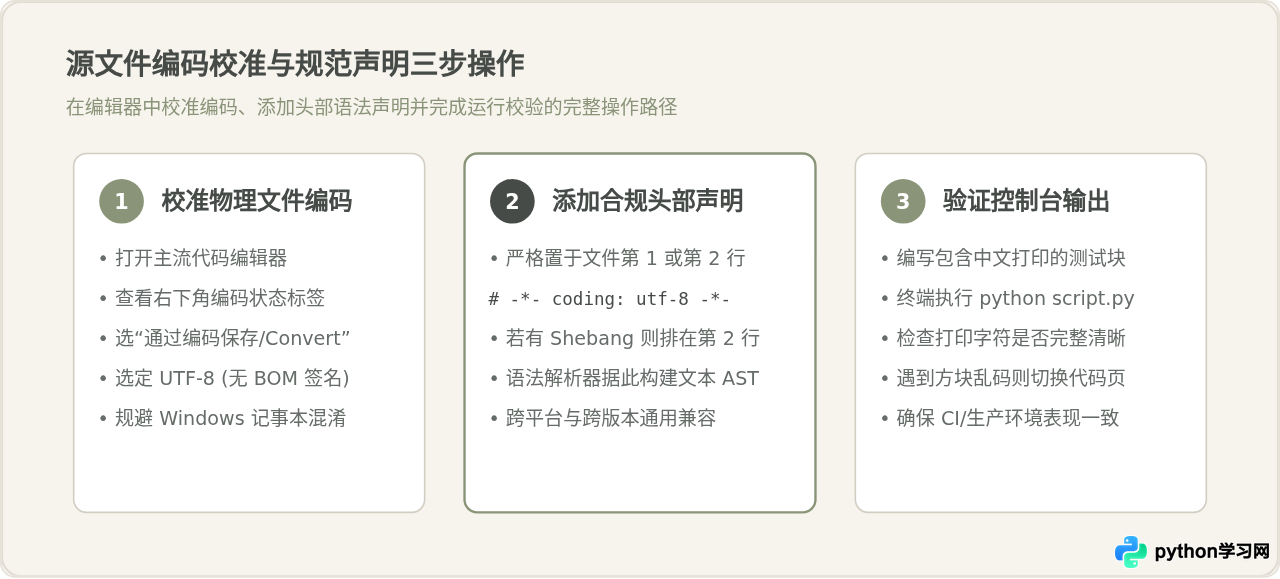
明确了问题所在的链路层级后,可以通过以下三个标准化步骤彻底解决中文报错与乱码。
步骤一:将源文件重新保存为 UTF-8(无 BOM)格式
很多开发者误以为“在代码里加上声明”就能解决所有报错,但如果源文件本身是以 GBK 格式保存在磁盘上的,头部加上 coding: utf-8 反而会导致解释器直接报 SyntaxError: (unicode error) 'utf-8' codec can't decode byte。因此,第一步必须修改源文件本身的物理编码:
- 在 VS Code 中操作:查看窗口右下角状态栏。如果显示的是
GBK或Windows-1252,点击该编码项,在顶部弹出的菜单中选择“通过编码重新保存”(Save with Encoding),随后输入并选择UTF-8。注意不要选择带签名的“UTF-8 with BOM”。 - 在 PyCharm 中操作:点击右下角的编码指示(如
GBK),在弹出窗口中选择UTF-8,然后点击Convert(转换已有内容)按钮。 - 在 Notepad++ 中操作:点击顶部菜单栏的“编码”(Encoding),选择“转为 UTF-8 编码”(Convert to UTF-8),保存文件。
步骤二:在脚本首行或次行添加标准编码声明
在源文件的第一行添加 PEP 263 规范声明,告知解释器无论在何种操作系统下都使用 UTF-8 解码:
# -*- coding: utf-8 -*-
import sys

def main():
    # 正确支持中文注释与输出
    message = "你好,世界!"
    print(message)

if __name__ == '__main__':
main()#!/usr/bin/env python3),编码声明必须紧跟其后放置在第二行。Python 解释器仅扫描前两行来寻找编码指令,写在第三行及之后将完全失效。
步骤三:解决终端控制台输出乱码与环境配置
如果源文件已经是正确的 UTF-8 编码,运行也无语法报错,但终端输出的内容是乱码或报 UnicodeEncodeError,说明问题出在终端的输出流上。按以下方案处理:
方案 A:切换 Windows 终端代码页为 UTF-8
在 Windows 的命令提示符(cmd)或 PowerShell 中,默认代码页往往是 936(GBK)。运行 Python 脚本前,先执行以下命令切换为 65001(UTF-8 代码页):
chcp 65001执行后终端会提示 Active code page: 65001,之后再运行 Python 脚本即可正确呈现中文。
方案 B:配置环境变量强制标准 I/O 编码
可以通过设置环境变量 PYTHONIOENCODING 强制 Python 在向标准输入、输出和错误流写入内容时使用 UTF-8:
# Windows CMD 环境
set PYTHONIOENCODING=utf-8
python test.py

# Windows PowerShell 环境
$env:PYTHONIOENCODING="utf-8"
python test.py

# Linux / macOS 终端环境
export PYTHONIOENCODING=utf-8
python3 test.py
方案 C:启用 Python 3.7+ 的 UTF-8 模式
在 Python 3.7 及更高版本中,Python 引入了全新的 UTF-8 Mode(PEP 540)。启用后,Python 会忽略操作系统的区域设置,无论在何种平台都将文本流默认当做 UTF-8 处理:
python -X utf8 script.py也可以通过设置系统环境变量 PYTHONUTF8=1 让所有 Python 进程全局生效。
四、容易混淆的认知误区与深度辨析
在处理 Python 中文编码时,网络上存在一些流传广泛但并不完全准确的说法,需要结合实际运行机制作出辨析:
误区一:“在字符串前加 u 前缀就能解决源文件中文报错”
辨析:这种说法混淆了“语法解析阶段”与“运行时数据类型”。在 Python 2 中,u"中文" 代表 Unicode 对象而非 str 字节串;而在 Python 3 中,所有原生字符串字面量默认就是 Unicode。当解释器在语法扫描阶段读到中文字符时,若源文件由于缺少声明而无法解码,根本还没来得及创建字符串对象,就已经报出 SyntaxError。因此加 u 既不能替代文件头部声明,也不能纠正文件物理存储格式。
误区二:“声明了 # -*- coding: gbk -*- 也能运行,没必要非改成 UTF-8”
辨析:在头部写 # -*- coding: gbk -*- 确实能让解释器按照 GBK 解析代码,消除语法报错。但这是一种存在极大维护隐患的做法:一旦该文件被提交到 Git 仓库,在 Linux 服务器(默认 UTF-8 环境)或 macOS 开发者机器上打开时,所有中文注释将全部变成乱码;持续集成工具或代码格式化工具(如 Black、Flake8)也可能直接报语法解析失败。业界事实上的通用标准是且仅是 UTF-8。
误区三:“UTF-8 带 BOM 和不带 BOM 没差别”
辨析:BOM(Byte Order Mark,字节顺序标记)会在文件开头插入三个看不见的十六进制字节 0xEF, 0xBB, 0xBF。Windows 自带的记事本在较旧版本中保存 UTF-8 时强制带有 BOM。这三个特殊字节会导致某些旧版 Python 解释器在读取首行 #!/usr/bin/env python 或编码声明时,将其解析为非法字符导致报错。因此保存文件时务必确认选择“UTF-8 without BOM”。
五、延伸提醒:代码中读写外部文件的中文处理
当解决了源码自身的中文报错后,如果程序还需要通过 open() 读写外部文本文件,仍需注意编码陷阱。Python 在调用 open() 时,若未显式指定 encoding 参数,会采用操作系统的默认编码(在 Windows 下仍然是 GBK)。
防范此类运行时乱码的规范做法是在打开文件时始终显式指定 UTF-8:
# 规范的文件读取方式
with open('data.txt', 'r', encoding='utf-8') as f:
    content = f.read()

# 规范的文件写入方式
with open('output.txt', 'w', encoding='utf-8') as f:
    f.write("写入包含中文的文本数据")
养成显式声明 encoding='utf-8' 的编码习惯,可以确保代码无论部署在 Windows 本地机器、macOS 开发机还是 Linux Docker 容器中,都能保持完全一致的读写行为,彻底告别中文乱码困扰。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









