

使用requests库获取网页内容的Python完整代码
使用Python的requests库获取网页内容的完整代码与实用教程。涵盖基础GET请求、自定义请求头防屏蔽、解决中文乱码、设置超时以及异常处理等关键技巧。
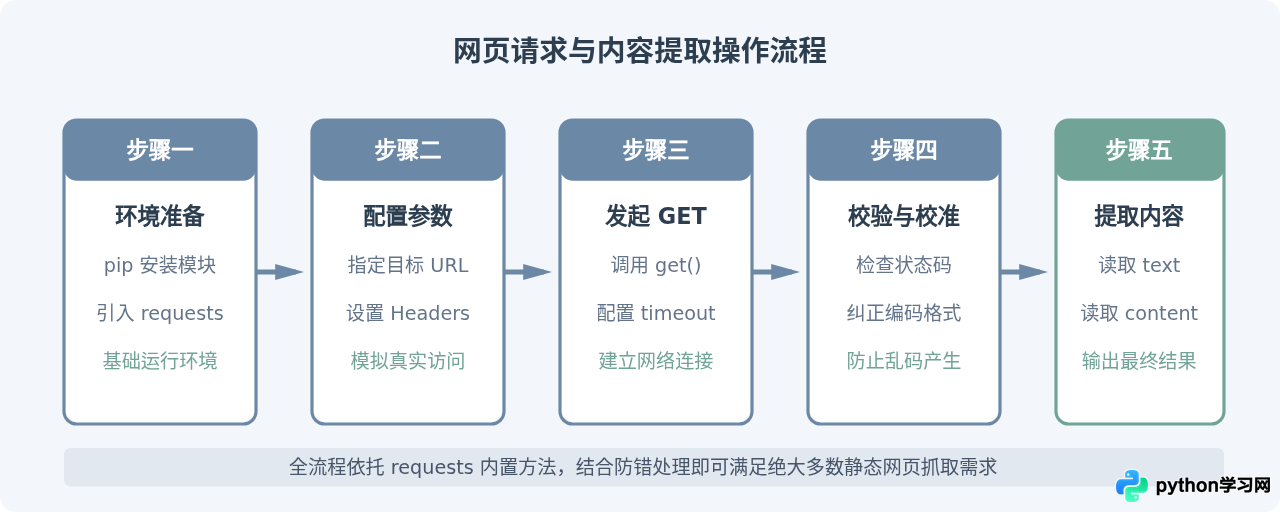
在 Python 中获取网页内容,最通用且稳定的方式是使用第三方库 requests。只需传入目标网址并发起 GET 请求,即可获取服务器返回的 HTML 文本或二进制数据。本文提供开箱即用的完整代码,并详细解释请求头伪装、中文编码纠正、超时设置与异常捕获等关键环节,帮助你稳健获取网页数据。
一、准备工作与最简请求示例
requests 不是 Python 内置模块,使用前需要在终端或命令行中执行安装命令:
pip install requests安装完成后,使用 requests.get() 方法向指定 URL 发送请求。以下是最直接的获取网页源代码代码:
import requests

url = "https://httpbin.org/get"
response = requests.get(url)

# 检查HTTP响应状态码
if response.status_code == 200:
    print("获取成功,网页内容如下:")
    print(response.text)
else:
print(f"请求失败,状态码为:{response.status_code}")这段代码中,response.status_code 表示服务器返回的状态码(200 代表请求成功),response.text 则是服务器返回并经过自动解码后的网页字符串。虽然简单,但在真实网络环境中,直接裸调容易遇到防爬拦截、中文乱码或网络卡死问题。
二、核心配置:伪装请求头与设置超时
许多网站会检查 HTTP 请求头中的 User-Agent 字段。如果未作配置,requests 默认会发送形如 python-requests/x.x.x 的标识,容易被目标网站直接返回 403 Forbidden 拒绝访问。
通过传入 headers 字典,我们可以将脚本伪装成常见的桌面浏览器;同时,配置 timeout 参数可以防止因对方服务器响应过慢而导致程序无限期挂起:
headers = {
    "User-Agent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/120.0.0.0 Safari/537.36",
    "Accept": "text/html,application/xhtml+xml,application/xml;q=0.9,*/*;q=0.8",
    "Accept-Language": "zh-CN,zh;q=0.9,en;q=0.8"
}

# 设置 timeout=10,表示连接与读取总等待时间不超过 10 秒
response = requests.get(url, headers=headers, timeout=10)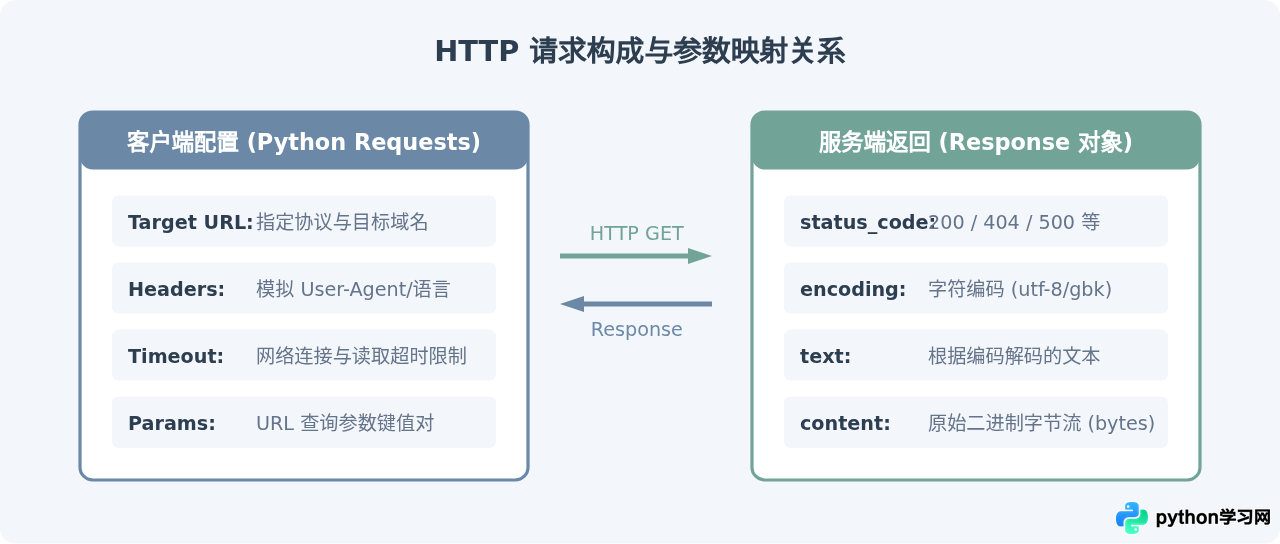
三、中文乱码成因与正确处理方式
抓取中文网页时,最常见的问题是打印出的正文全是乱码(例如 æ们)。这是因为:
requests默认通过 HTTP 响应头中的Content-Type推断字符集;- 若服务端响应头没有显式指明
charset,RFC 2616 协议规定默认采用ISO-8859-1; - 使用
ISO-8859-1解码本应为UTF-8或GBK的中文网页时,就会产生乱码。
解决方法:在读取 response.text 前,利用 response.apparent_encoding 自动推测真实编码并重新赋值:
# 根据网页正文实际内容推测编码,解决中文乱码
response.encoding = response.apparent_encoding
html_content = response.text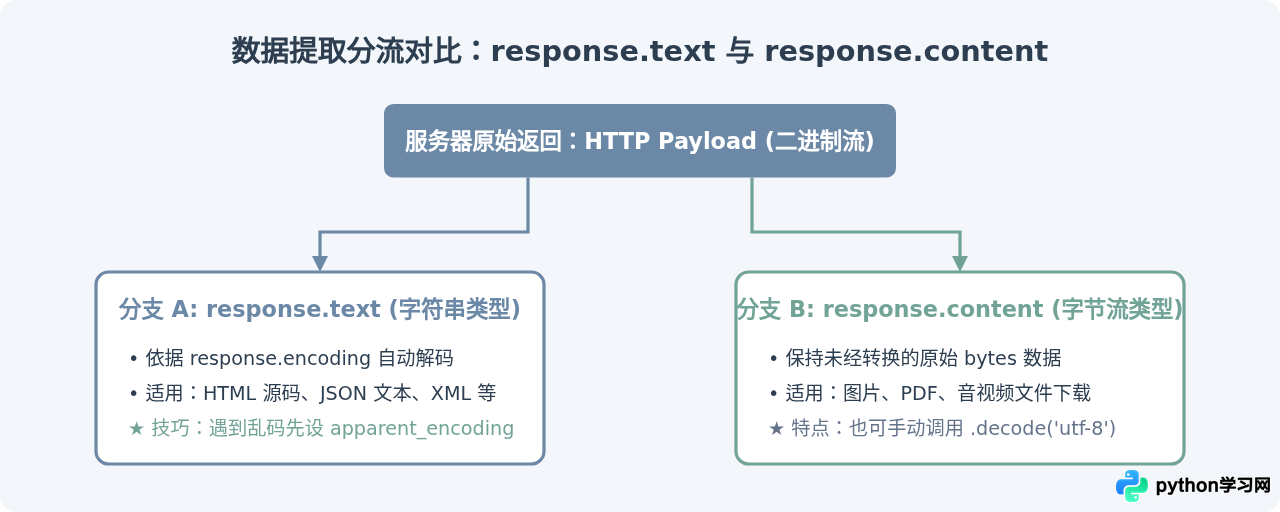
四、工程化必备:异常捕获机制
在网络请求中,目标网站无法连接、DNS 解析失败、连接超时或服务器返回 404/500 等均属常见异常。生产级代码必须把请求包裹在 try...except 结构中:
requests.exceptions.Timeout:连接或读取超时;requests.exceptions.ConnectionError:网络未连接或域名无法解析;requests.exceptions.HTTPError:通过response.raise_for_status()抛出的状态码异常;requests.exceptions.RequestException:所有 requests 异常的基类,用于兜底捕获。
五、获取网页内容的 Python 完整代码
以下是将上述所有关键要素(伪装请求头、参数封装、动态编码校准、超时控制与多层异常处理)整合后的完整可运行代码:
import requests
from requests.exceptions import RequestException, Timeout, HTTPError, ConnectionError

def fetch_web_page(url: str, timeout: int = 10) -> str:
    """
    使用 requests 库获取指定 URL 网页的完整 HTML 文本内容

    :param url: 目标网页的完整 URL 地址
    :param timeout: 超时时间(秒),默认 10 秒
    :return: 网页的 HTML 字符串,如果获取失败则返回空字符串
    """
    # 1. 构造请求头,伪装成常规桌面浏览器
    headers = {
        "User-Agent": (
            "Mozilla/5.0 (Windows NT 10.0; Win64; x64) "
            "AppleWebKit/537.36 (KHTML, like Gecko) "
            "Chrome/124.0.0.0 Safari/537.36"
        ),
        "Accept": "text/html,application/xhtml+xml,application/xml;q=0.9,image/webp,*/*;q=0.8",
        "Accept-Language": "zh-CN,zh;q=0.9,en;q=0.8",
        "Connection": "keep-alive"
    }

    try:
        # 2. 发起 GET 请求
        response = requests.get(url, headers=headers, timeout=timeout)

        # 3. 如果状态码是 4xx 或 5xx,抛出 HTTPError 异常
        response.raise_for_status()

        # 4. 校准字符编码,优先使用正文推测编码,避免中文乱码
        if response.encoding.lower() == "iso-8859-1" or not response.encoding:
            response.encoding = response.apparent_encoding
        else:
            response.encoding = response.apparent_encoding or "utf-8"

        # 5. 返回解码后的文本内容
        return response.text

    except Timeout:
        print(f"[错误] 请求超时:超过 {timeout} 秒未得到服务器响应。")
    except ConnectionError:
        print("[错误] 网络连接错误:请检查网络连接或目标域名是否正确。")
    except HTTPError as e:
        print(f"[错误] HTTP 状态异常:{e} (状态码: {response.status_code})")
    except RequestException as e:
        print(f"[错误] 发生未预期的请求异常:{e}")

    return ""


if __name__ == "__main__":
    # 测试目标网址(这里使用知名的公开测试网址)
    target_url = "https://www.example.com"

    print(f"正在抓取网页内容: {target_url} ...")
    html_source = fetch_web_page(target_url, timeout=8)

    if html_source:
        print(f"成功获取网页内容,总字符数: {len(html_source)}")
        print("----- 网页前 300 字符预览 -----")
        print(html_source[:300])
        print("-------------------------------")
    else:
        print("抓取失败,未能获取网页内容。")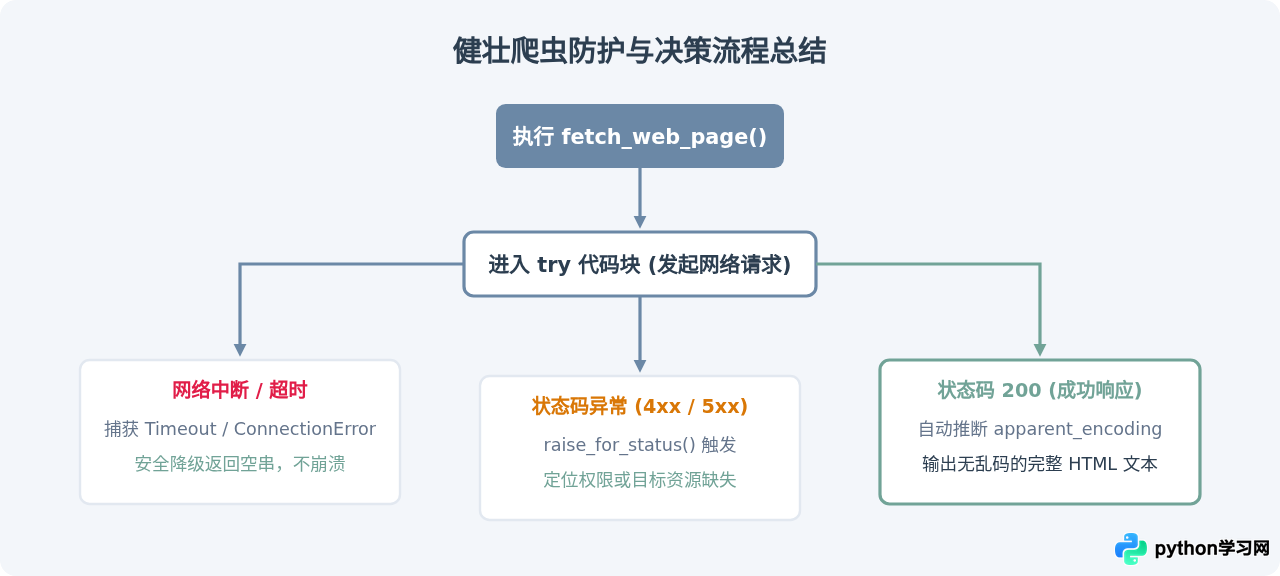
六、常见问题与排查指南
| 异常现象 | 根本原因 | 解决办法 |
|---|---|---|
| 返回 403 Forbidden | 网站开启了防盗链或封禁默认 Python User-Agent | 在 headers 中补充浏览器的 User-Agent,必要时传入 Referer 或 Cookie。 |
| 页面中文出现乱码 | 响应头未指定编码,requests 默认按 ISO-8859-1 解码 | 读取前执行 response.encoding = response.apparent_encoding。 |
| 程序长久无响应、假死 | 服务器未响应,且请求未设超时阈值 | 始终在 requests.get() 中指定 timeout=10 等明确秒数。 |
| 返回 200 但没有目标数据 | 目标网页属于前端 JavaScript 异步渲染(SPA/Vue/React) | 通过浏览器开发者工具网络面板查找对应的 JSON 数据接口,或改用 Playwright/Selenium 等无头浏览器渲染。 |
总结:使用 Python 的 requests 库获取网页内容时,切忌使用没有任何保护措施的裸调用。遵循“设置常用 Headers + 配置 timeout 超时 + 动态纠正 apparent_encoding + 外层捕获 RequestException”的四步法则,即可保证代码在面对绝大部分网络波动和常规反爬策略时具备极佳的稳定性。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









