

Python标准库常用模块速查表PDF:os/sys/re等核心库精简版
一份针对Python日常开发高频场景的精简版标准库速查表指南,聚焦os、sys、re等核心库的关键API、调用范式与避坑要点,并提供适合打印与桌面查阅的PDF双页速查版面设计与实现。
os、sys 与 re 是调用频次最高的核心库。然而,开发者往往因为一些细微的接口差异而产生心智负担——例如 sys.argv[0] 的下标偏移、os.path 与现代 pathlib 的选型权衡、以及 re.match 与 re.search 的匹配起点陷阱。本文将这些核心标准库的高频 API 提炼为一份精简的速查参考体系,并整理出两页式 A4 PDF 打印版面的编排规范,帮助开发者在脱离厚重文档的情况下,直接获得高密度的调用范式与避坑依据。
一、速查表核心设计与高频模块分类
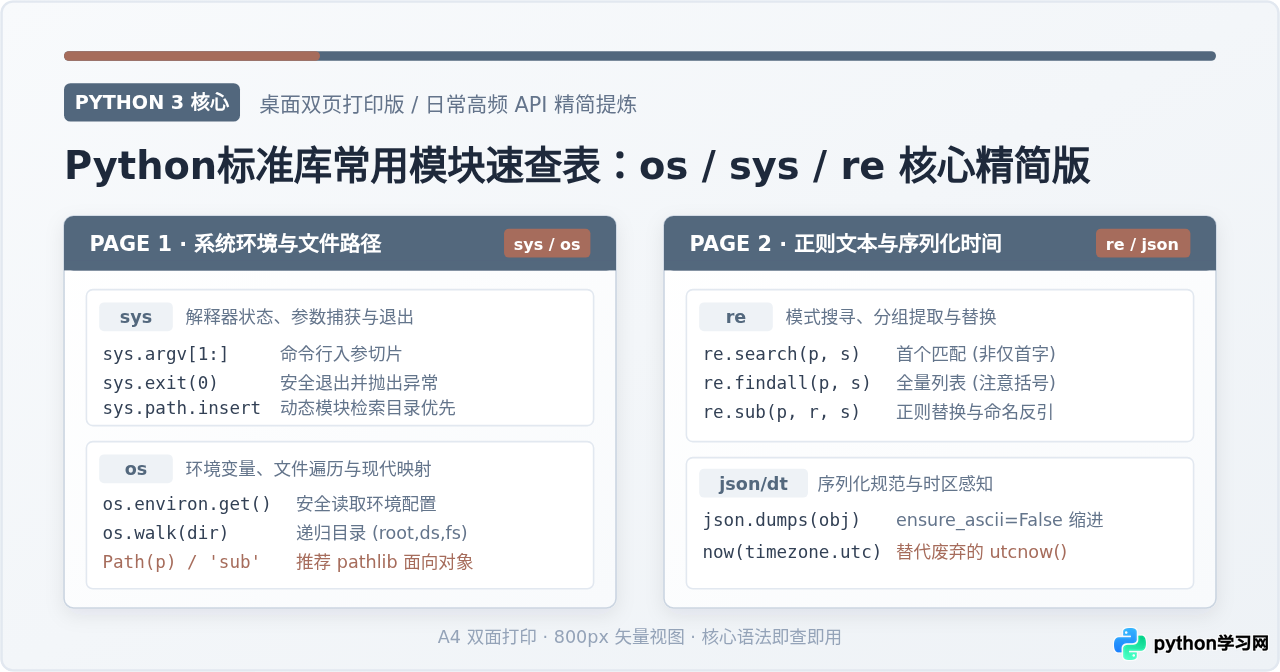
Python 标准库庞大而丰富,但在日常工程实践中,超过 80% 的系统与文本交互集中在少数几个模块上。为了制作一份真正适合桌面放置、单次翻阅即可覆盖高频操作的“两页精简版 PDF 速查表”,必须对标准库的能力边界进行清晰划分。
根据实际使用场景,速查表提炼为四大核心维度:
- 解释器与运行环境交互(
sys):负责控制 Python 进程自身、捕获外部 CLI 命令行参数、管理包导入搜索路径(sys.path)以及标准流的控制。 - 操作系统与底层文件系统(
os及现代pathlib):负责读取系统环境变量、管理当前工作目录、递归遍历多层子目录及文件原语操作。 - 文本模式匹配与规则替换(
re):负责文本扫描、基于捕获组的结构化提取、多行模式匹配以及高频规则预编译。 - 基础数据与时间协同(
json与datetime):作为系统交互的紧密辅助,负责配置持久化反序列化与具备时区感知的时间戳处理。
二、系统级与解释器交互:sys 与 os 核心速查与演进
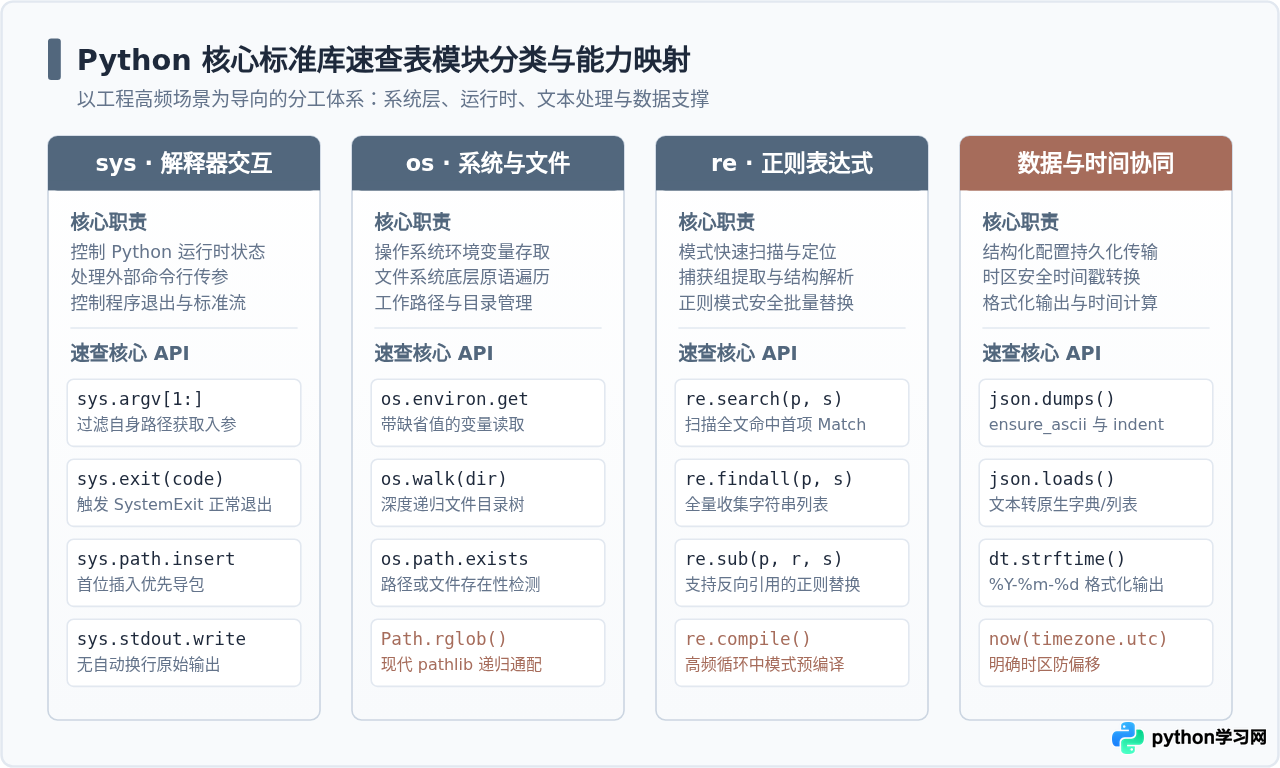
sys 与 os 经常成对出现,但分工截然不同:sys 面向 Python 解释器内部与运行时,而 os 面向外部宿主操作系统。
1. sys 核心速查清单
命令行工具开发中最基础的代码通常始于 sys.argv,但对参数的处理必须警惕越界。
import sys

# 1. 命令行参数捕获:sys.argv[0] 始终是脚本自身路径,真实参数从下标 1 开始
args = sys.argv[1:]  # 获取切片列表,无入参时为 [],避免直接 sys.argv[1] 触发 IndexError

# 2. 安全退出:相比 os._exit(),sys.exit() 抛出 SystemExit,能正常执行 finally 与清理逻辑
if not args:
    sys.stderr.write("错误:未提供必要参数\n")
    sys.exit(1)  # 退出码非 0 表示异常

# 3. 动态模块搜索路径注入:首位插入确保优先加载当前项目模块
sys.path.insert(0, "/path/to/custom_libs")

# 4. 原始标准输出(无内置换行)
sys.stdout.write(f"正在处理参数: {args[0]}\n")
sys.stdout.flush()
2. os 环境变量与文件系统遍历
在容器化与跨平台部署中,配置注入通常依赖环境变量。os.environ 是一个类似字典的对象,但必须注意类型约束。
import os

# 1. 环境变量安全读取:必须提供默认值,避免直接字典索引 KeyError
db_host = os.environ.get("DATABASE_HOST", "127.0.0.1")
db_port = int(os.environ.get("DATABASE_PORT", "5432"))  # 环境变量返回均为 str,需显式转换

# 2. 目录切换与获取
current_work_dir = os.getcwd()

# 3. 传统目录遍历:os.walk 产出 (当前路径, 子目录列表, 文件列表)
target_dir = os.path.join(current_work_dir, "logs")
if os.path.exists(target_dir):
    for root, dirs, files in os.walk(target_dir):
        for file in files:
            if file.endswith(".log"):
file_full_path = os.path.join(root, file)os.system("cmd") 不仅无法获取命令标准输出,且极易引发命令注入漏洞。速查表统一推荐使用标准库 subprocess.run(["cmd", "arg"], capture_output=True, text=True, check=True)。
3. 从 os.path 到现代 pathlib 的平滑过渡
Python 3.4 引入的 pathlib 提供了面向对象的路径操作方式。速查表建议在维护遗留脚本时熟悉 os.path,但在新代码中优先选用 pathlib.Path,两者在语义上有一对一的演进关系。
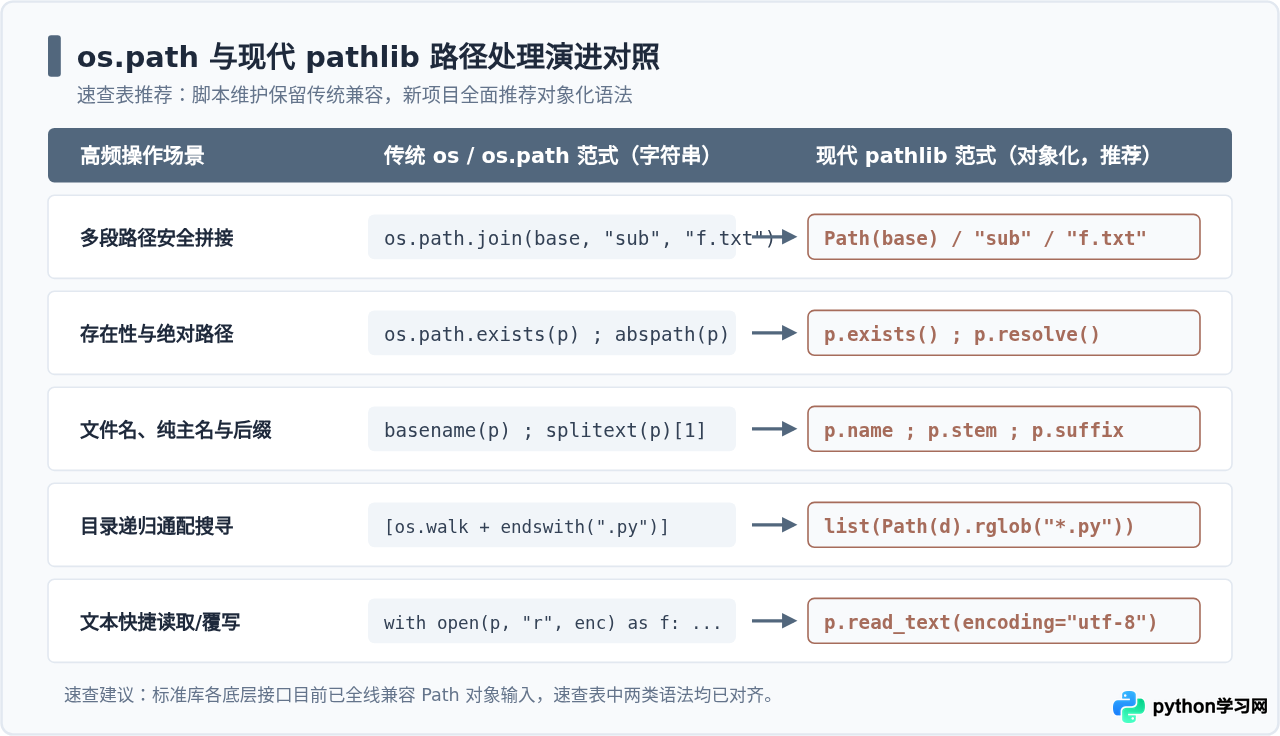
| 操作意图 | 传统 os / os.path 范式 | 现代 pathlib 范式 | 核心优势 |
|---|---|---|---|
| 路径拼接 | os.path.join(a, b) |
Path(a) / b |
斜杠运算符直观,自动处理各平台路径分隔符 |
| 绝对路径解析 | os.path.abspath(p) |
Path(p).resolve() |
自动消除软链接与 .. 相对符号 |
| 后缀名提取 | os.path.splitext(p)[1] |
p.suffix |
无需元组拆分,属性直接读取 |
| 多级目录创建 | os.makedirs(p, exist_ok=True) |
p.mkdir(parents=True, exist_ok=True) |
参数显式,避免重复检查是否存在 |
| 快捷文本读取 | with open(p, "r", encoding="utf-8") as f: data = f.read() |
p.read_text(encoding="utf-8") |
单行完成资源打开、编码读取与安全关闭 |
三、文本处理主力:re 正则模块决策树与语法速查
在日常开发中,许多正则匹配问题源自方法混淆。最典型的误区是误将 re.match() 当作全文搜寻工具。
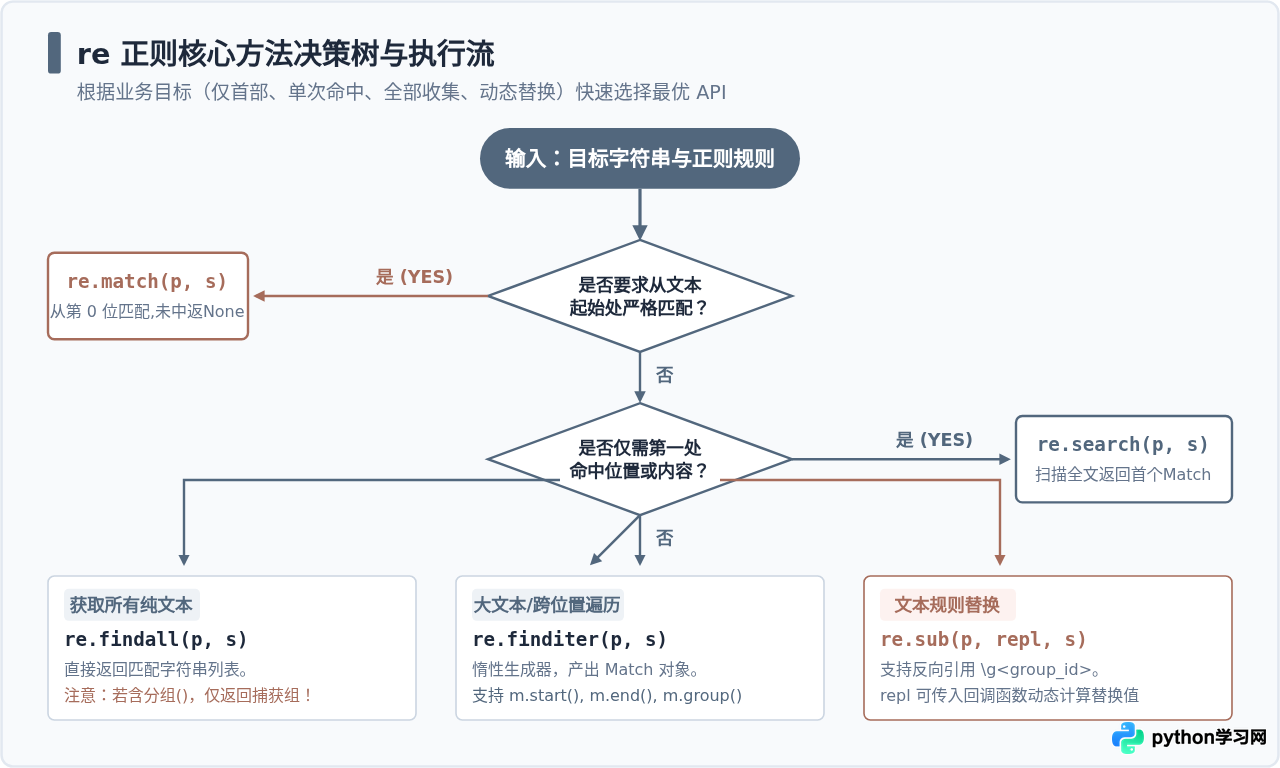
1. 正则匹配四大核心方法决策依据
re.match(pattern, string):仅从字符串的索引0严格匹配。若首字符不符合正则规则,即使整个字符串后续完全符合,也会立即返回None。适用于严格协议头、格式前缀的校验。re.search(pattern, string):在整个字符串中从左至右扫描,返回第一个命中的Match对象。在日志分析与非结构化文本中提取首个指标时应优先选用。re.findall(pattern, string):扫描全文并返回所有符合条件的字符串列表。特别陷阱:如果正则表达式中包含了未命名的括号捕获组(abc),findall将仅返回捕获组中的内容,而非整个匹配片段。若需使用括号调整优先级而不需要单独提取,必须使用非捕获分组(?:abc)。re.finditer(pattern, string):惰性返回由Match对象组成的迭代器。在大文本文件(如 GB 级别日志)流式扫描中占用极低内存,且能保留每次匹配的起止坐标(.start(),.end())。
2. 结构化捕获与动态替换示例
import re

log_line = "2026-10-30 15:20:00 [ERROR] user_id=4092: connection timeout"

# 1. 命名捕获组 (?P<name>pattern) 提升代码可维护性
pattern = re.compile(
    r"^(?P<datetime>\d{4}-\d{2}-\d{2}\s\d{2}:\d{2}:\d{2})\s"
    r"\[(?P<level>[A-Z]+)\]\suser_id=(?P<uid>\d+):\s(?P<msg>.*)$"
)

match = pattern.search(log_line)
if match:
    data = match.groupdict()
    # 示例输出: {'datetime': '2026-10-30 15:20:00', 'level': 'ERROR', 'uid': '4092', 'msg': 'connection timeout'}
    print(f"日志级别: {data['level']}, 涉及用户: {data['uid']}")

# 2. re.sub 反向引用替换:屏蔽敏感数字
mask_pattern = re.compile(r"user_id=(?P<uid>\d+)")
masked_log = mask_pattern.sub(r"user_id=***\g<uid>", log_line)
3. 高频 Flags 标志位速记
re.IGNORECASE(简写re.I):忽略大小写。re.DOTALL(简写re.S):改变.的默认行为,使其匹配包括换行符re.MULTILINE(简写re.M):改变^和$的行为,使其匹配字符串中每一行的起始与结束,而非仅匹配全文首尾。
四、常用辅助核心库:json 与 datetime 高频范式
在 CLI 脚本与文件系统交互中,配置持久化与时间戳记录通常与 os/sys 紧密交织。
1. json 模块核心参数速记
在处理中文文本或美化配置文件输出时,记住关键参数能够避免乱码与可读性问题:
import json

payload = {"task_id": 101, "status": "成功", "tags": ["核心库", "速查"]}

# 序列化为格式化 JSON 字符串:
# ensure_ascii=False 保证中文字符直接输出而非 \uXXXX 转义
# indent=2 提供规范的层级缩进
json_str = json.dumps(payload, ensure_ascii=False, indent=2)

# 反序列化
parsed_dict = json.loads(json_str)
2. datetime 模块时区安全规范
Python 3.12 明确废弃了返回无时区(naive)UTC 时间的 datetime.utcnow()。速查表中应统一更新为带时区标识(aware)的现代写法:
from datetime import datetime, timezone, timedelta

# 1. 获取当前 UTC 时间(带时区感知,推荐)
now_utc = datetime.now(timezone.utc)

# 2. 格式化字符串输出(strftime: string from time)
formatted_str = now_utc.strftime("%Y-%m-%d %H:%M:%S")

# 3. 字符串解析为时间对象(strptime: string parse time)
parsed_dt = datetime.strptime("2026-10-30 15:30:00", "%Y-%m-%d %H:%M:%S")
# 显式挂载 UTC 时区
parsed_dt = parsed_dt.replace(tzinfo=timezone.utc)

# 4. 时间加减计算
next_week = now_utc + timedelta(days=7, hours=2)
五、双页 PDF 速查表排版规划与避坑总览
将上述核心模块浓缩为物理打印件或桌面两页 PDF 时,版面空间必须进行严谨的栅格规划。
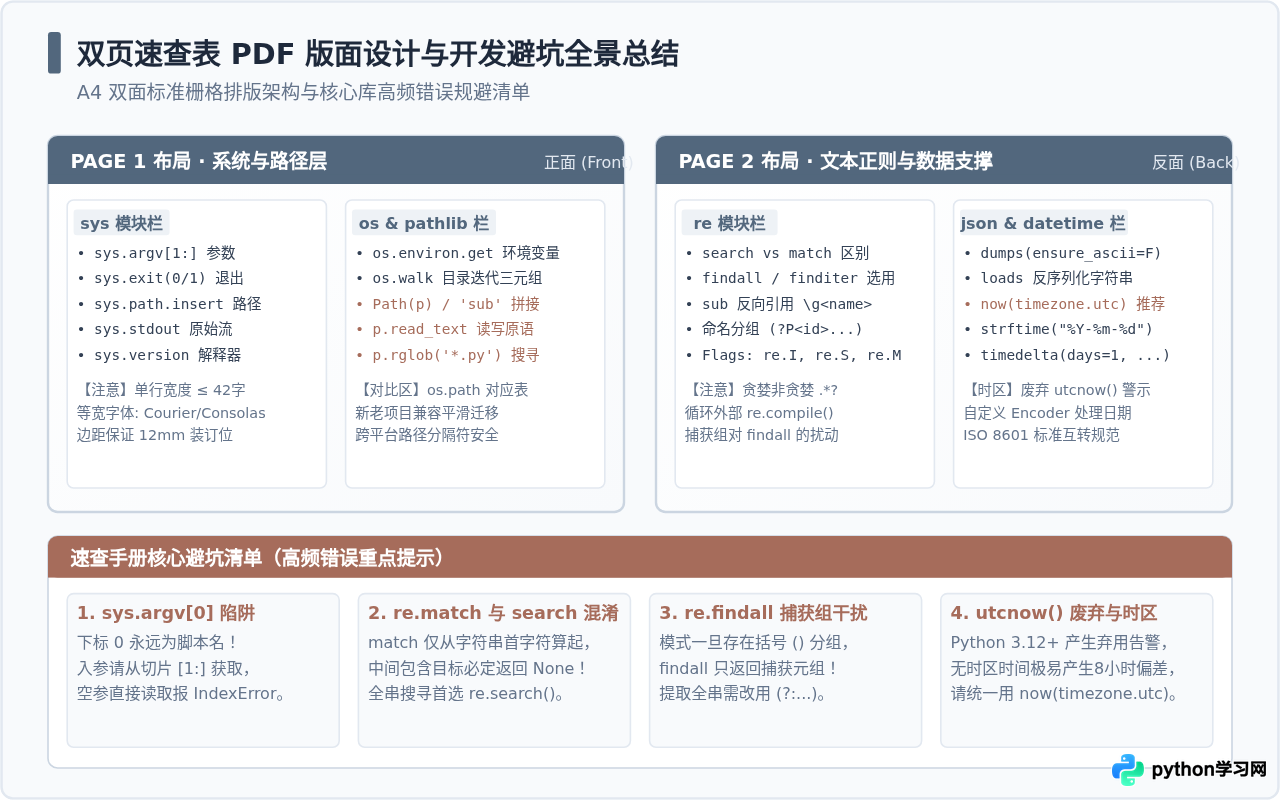
1. PDF 双页版面栅格与排版标准
- 页面尺寸与外边距:标准 A4 纵向排版(210mm × 297mm),上下左右外边距严格保持在
10mm - 12mm之间。这样不仅保障打印不被边缘裁切,还能预留打孔或文件夹收纳空间。 - 分栏策略与字符限制:单页采用双栏等宽栅格设计。代码示例单行字符数控制在 42 字符以内,超过长度的代码采用反斜杠或括号显式折行,杜绝打印时代码块溢出或被裁断。
- 正面(Page 1):集中安排
sys与os/pathlib。作为脚本的基础入口与文件交互基础,包含参数解析、路径操作映射表及标准退出码规范。 - 反面(Page 2):集中安排
re与json/datetime。左栏为正则方法决策树与常用元字符,右栏为 JSON 中文格式化与时区感知时间处理。
2. 生成 PDF 的工程实践
要将本份速查表高质量导出为矢量 PDF,无需依赖重量级 IDE 插件。在配备 Python 环境的机器上,推荐以下两种轻量级导出路径:
- 浏览器无头打印(推荐):利用现代 Chrome / Chromium 引擎的打印功能:
chrome --headless --disable-gpu --print-to-pdf="python_core_cheatsheet.pdf" --no-margins body.html
该方式能够完整保留矢量 SVG 与 CSS 布局,文字保持可选中状态。 - Python WeasyPrint 工具:使用
pip install weasyprint,直接调用weasyprint body.html cheatsheet.pdf即可依据标准@pageCSS 生成工业级打印版。
3. 高频避坑清单速查
在日常开发与速查过程中,牢记以下 4 条核心避坑法则:
sys.argv[0]永远表示脚本自身路径:真实命令行参数切片必须从sys.argv[1:]获取。切勿直接使用sys.argv[1]作为判断条件,若用户未传参会导致未捕获的IndexError。re.match绝不等同于re.search:re.match仅从索引 0 开始比对,字符串中段出现符合规则的子串一律返回None。若要全文本搜索,请无条件使用re.search。re.findall包含分组时仅返回元组:在构建复杂提取规则时,如果不希望findall仅返回括号内的子分组,请使用(?:pattern)非捕获分组修饰。datetime.utcnow()属于已废弃接口:在 Python 3.12 及以上版本中,必须使用datetime.now(timezone.utc),否则不仅触发 DeprecationWarning,还极易在跨系统时区转换中产生 8 小时的时间偏差。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









