

Python爬虫解析失败怎么办?处理HTML编码乱码与节点缺失的方法
针对Python爬虫解析失败的两大核心痛点——HTML中文乱码与DOM节点缺失,系统讲解响应体编码识别、转码策略,以及动态加载、请求反爬与选择器失效的排查与解决方法。
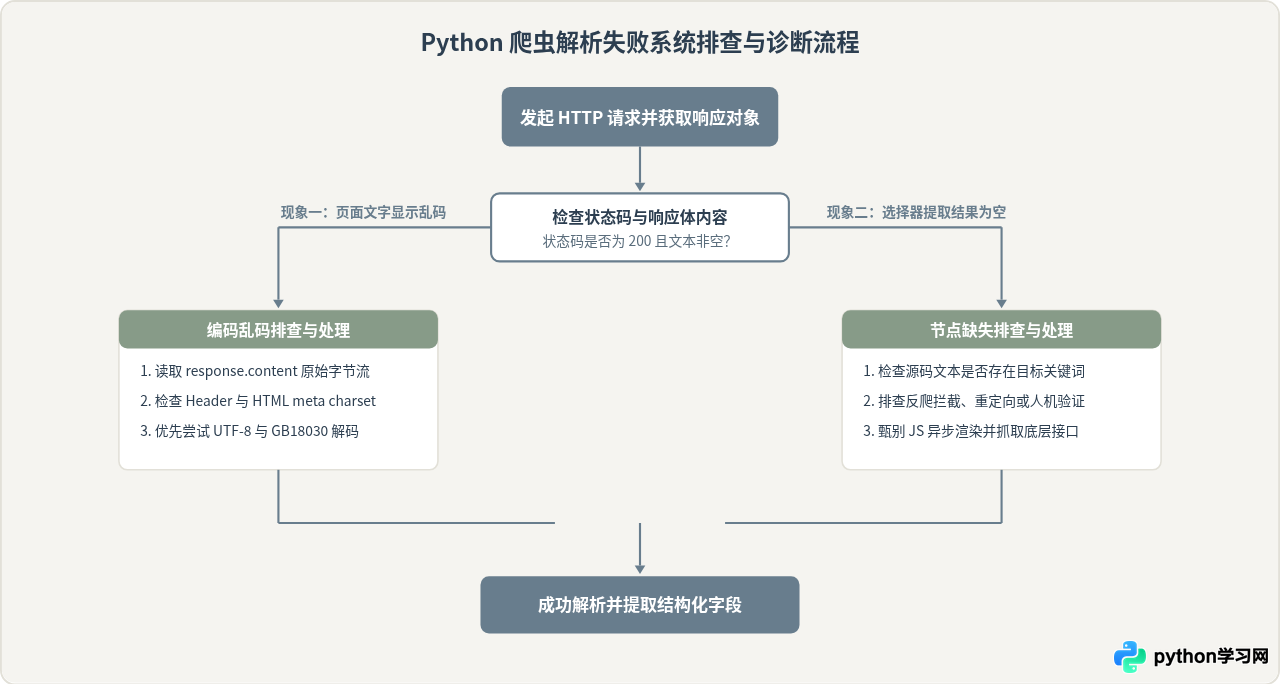
在使用 Python 编写网络爬虫提取网页数据时,解析器抛出异常或提取结果为空是常见的故障。这类解析失败通常并非解析库语法错误,而是由两个根本原因引起:一是文本编码不匹配导致 HTML 内容呈现为一堆乱码字符,导致预设的选择器和正则表达式无法匹配到目标文本;二是目标节点在获取的原始响应体中根本不存在,由客户端异步渲染、反爬机制拦截返回验证页或 DOM 树解析容错差异所致。解决该问题的完整路径是:先提取原始字节流完成字符编码的规范化解码,再比对静态网络响应与浏览器渲染树,根据节点渲染机制选择对应的抓取策略。
一、HTML 编码乱码的根源与彻底解决方案
很多开发者在调用 requests.get(url) 后直接使用 response.text,经常会发现中文变成诸如 ä½ å¥½ 或包含大量问号的乱码。这种乱码直接破坏了解析器(如 BeautifulSoup 或 lxml)对中文标签内容、属性值的正则与 XPath 匹配。
1. 为什么 response.text 会出现乱码?
response.text 是 Requests 库根据 HTTP 响应头部的 Content-Type 猜测编码后生成的文本。如果服务器在响应头中没有显式提供 charset 参数,根据 HTTP 1.1 标准(RFC 2616),Requests 会默认将其 fallback 为 ISO-8859-1 编码。对于包含中文 UTF-8 或 GBK 字节流的网页,用单字节的 ISO-8859-1 解码自然就会产生字符错乱。
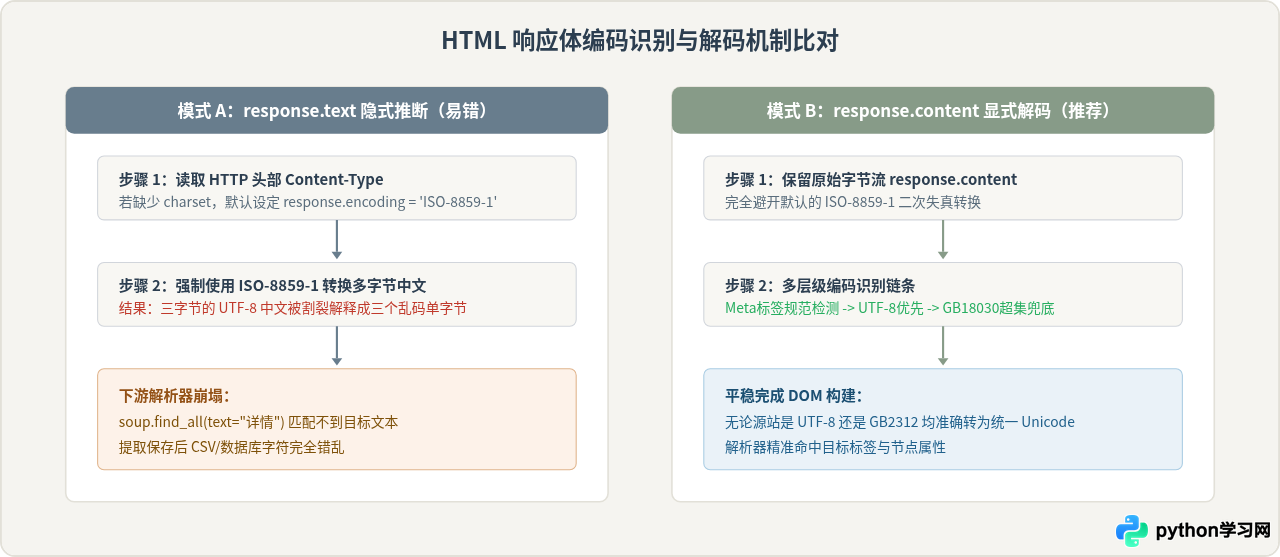
2. 两种做法的对比:response.text 隐式猜测 vs response.content 显式解码
在处理网页编码时,通常存在两种截然不同的策略:一种是依赖库自身的自动推断,另一种是提取原始二进制字节流进行确定性解码。两者的关键差异如下:
| 对比维度 | 依赖 response.text (隐式处理) | 使用 response.content (显式解码) |
|---|---|---|
| 数据来源 | 已被 Requests 内部解码过的 Unicode 字符串 | 网络直接传输的原始二进制字节流(bytes) |
| 容错机理 | 若初始猜错为 ISO-8859-1,不可逆转为合法字符 | 保留未经失真转换的原始字节,可任意尝试解码 |
| 中文字符集支持 | 仅匹配常见 charset,遇到 GB18030 生僻字易报错 | 可指定 errors='replace' 或 gb18030 超集精准还原 |
| 执行效率 | 若调用 apparent_encoding 会执行全字节频率统计,耗时显著 | 按优先级检查 Header 与 Meta,无需额外大开销统计 |
3. 标准健壮解码实现代码
为了从根本上规避乱码,建议使用一套确定性的多层转码流程:先检查 HTML 文档内部 <meta charset="..."> 声明,其次使用 utf-8 进行安全解码,若遇到解码异常则平滑降级至涵盖所有生僻汉字的 gb18030:
import re
import requests
from bs4 import BeautifulSoup

def fetch_html_safely(url: str, timeout: int = 15) -> str:
    headers = {
        "User-Agent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/120.0.0.0 Safari/537.36"
    }
    resp = requests.get(url, headers=headers, timeout=timeout)
    resp.raise_for_status()

    raw_bytes = resp.content

    # 1. 尝试从 HTML 的 meta 标签中提取字符集声明
    meta_charset = None
    charset_match = re.search(rb'<meta[^>]+charset=["\']?([a-zA-Z0-9_\-]+)', raw_bytes[:2048])
    if charset_match:
        meta_charset = charset_match.group(1).decode("ascii", errors="ignore").lower()

    # 2. 如果 meta 指定了 gb2312 或 gbk,直接升级至 gb18030 超集处理
    if meta_charset in ["gb2312", "gbk", "gb18030"]:
        return raw_bytes.decode("gb18030", errors="replace")

    # 3. 默认优先尝试 utf-8,失败后回退至 gb18030
    try:
        return raw_bytes.decode("utf-8")
    except UnicodeDecodeError:
        try:
            return raw_bytes.decode("gb18030")
        except UnicodeDecodeError:
            # 4. 极端情况下使用 apparent_encoding 检测并容错替换
            detected = resp.apparent_encoding or "utf-8"
            return raw_bytes.decode(detected, errors="replace")

# 示例调用
html_content = fetch_html_safely("https://example.com/news")
soup = BeautifulSoup(html_content, "html.parser")
print("页面标题:", soup.title.string if soup.title else "无标题")
国内许多早期政企、高校网站的 Meta 标签中虽然写着 charset=gb2312,但正文中实际常包含拓展字、生僻字或特殊标点符号。使用标准 gb2312 解码会直接抛出 UnicodeDecodeError,必须在代码中将其统一升格映射为 gb18030。
二、节点缺失与解析器返回空的排查思路
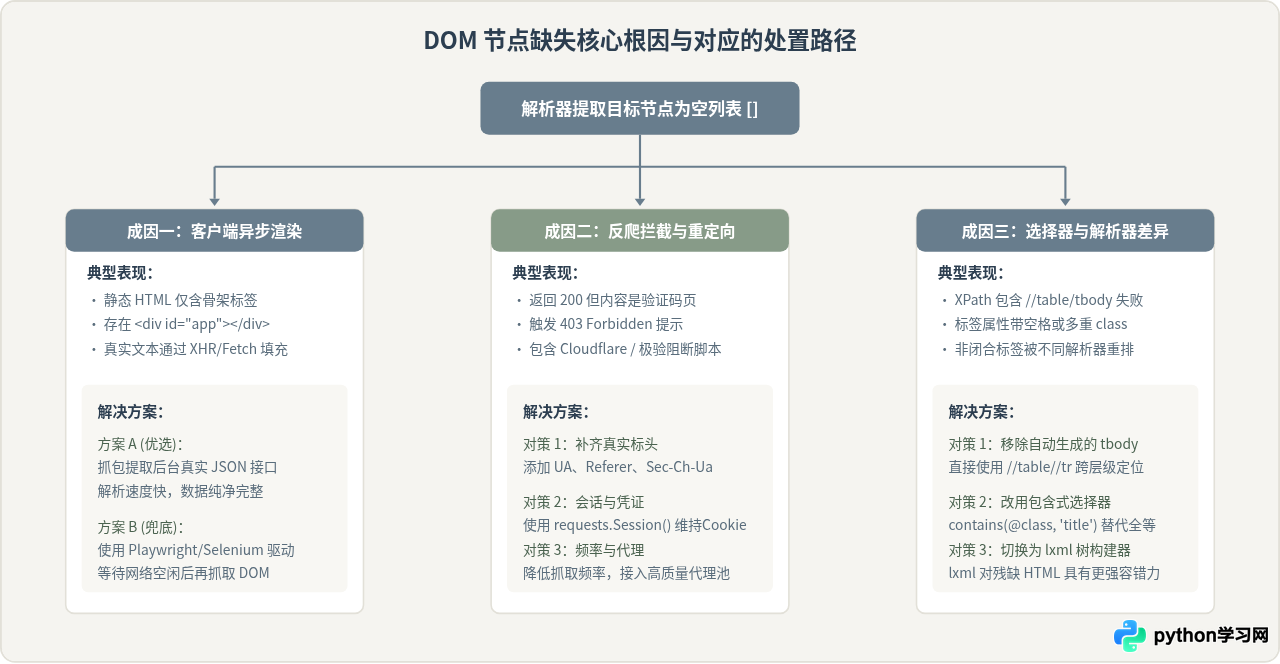
当编码正常、没有任何乱码时,爬虫调用 soup.select('.item-title') 或 tree.xpath('//div[@class="content"]/p') 依然经常返回空列表。这类问题通常是“本地视角的 DOM 树”与“爬虫收到的原始 HTML”不一致造成的。
1. 警惕“浏览器审查元素”的欺骗性
初学者习惯在 Chrome 或 Edge 浏览器中按 F12 审查元素,然后直接右键复制 XPath 或 CSS 选择器。然而,F12 的 Elements 面板展示的是浏览器执行了所有 JavaScript 脚本、完成了异步 AJAX 数据注入,并且经过浏览器内核容错修补之后的最终动态渲染树。而常规 requests 爬虫获取的只是服务器最初返回的纯静态 HTML 文本。两者之间往往存在极大出入。
2. 核心排查步骤:三步定位法
- 第一步:落盘原始响应快照。在调用解析代码前,将
response.text完整写入一个本地的debug.html文件,或者使用print("目标词" in response.text)快速断言。如果在原始响应中连目标文字的纯文本都不存在,任何 CSS 选择器或 XPath 都不可能起作用。 - 第二步:检查是否存在客户端渲染或接口交互。打开浏览器开发者工具的
Network(网络)选项卡,勾选Fetch/XHR过滤器,刷新页面。观察是否存在返回 JSON 数据的接口。目前超过 70% 的现代资讯、电商与社交平台均采用前后端分离架构,直接爬取该 JSON 接口不仅速度快数十倍,还能避免复杂的 HTML 解析。 - 第三步:核查选择器中的“虚构节点”。常见的是
<tbody>标签。W3C 规范中许多原始表格并没有写<tbody>,但浏览器在渲染时会自动补全该标签并挂载在 DOM 树上。如果开发者从浏览器直接复制//*[@id="list"]/table/tbody/tr[1]/td,由于 lxml 或 BeautifulSoup 严格按照原始 HTML 构建树,找不到tbody就会导致整条路径解析失败。
三、构建高容错的爬虫解析防御代码
为了保证爬虫任务在生产环境下稳定运行,不因个别网页的编码波动或排版微调而崩溃,应该在代码层面加入多重校验与降级逻辑。
from typing import List, Dict, Optional
import requests
from bs4 import BeautifulSoup
from lxml import etree

def robust_parse_product(url: str) -> Optional[Dict[str, str]]:
    headers = {
        "User-Agent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36",
        "Accept-Language": "zh-CN,zh;q=0.9,en;q=0.8",
    }

    try:
        resp = requests.get(url, headers=headers, timeout=12)
        resp.raise_for_status()
    except requests.RequestException as e:
        print(f"网络请求失败 [{url}]: {e}")
        return None

    # 1. 确定性转码
    try:
        html = resp.content.decode("utf-8")
    except UnicodeDecodeError:
        html = resp.content.decode("gb18030", errors="replace")

    # 2. 前置内容校验(判断是否被重定向至验证页或登录页)
    if "请输入验证码" in html or "访问过于频繁" in html:
        print(f"触发人机风控拦截 [{url}]")
        return None

    # 3. 使用 lxml 进行 XPath 弹性提取
    parser = etree.HTMLParser(encoding="utf-8")
    tree = etree.HTML(html, parser=parser)
    if tree is None:
        print(f"HTML 结构完全损毁无法建立 DOM 树 [{url}]")
        return None

    # 避免使用绝对路径 /div[1]/table/tbody/tr
    # 使用相对路径与 contains 模糊匹配 class
    title_nodes = tree.xpath('//h1[contains(@class, "product-title")]/text()')
    price_nodes = tree.xpath('//span[contains(@class, "price") or contains(@id, "price")]/text()')

    # 4. 选择器降级策略
    if not title_nodes:
        # 回退至全页 h1 或 title 标签
        title_nodes = tree.xpath('//h1/text()') or tree.xpath('//title/text()')

    title = title_nodes[0].strip() if title_nodes else ""
    price = price_nodes[0].strip() if price_nodes else "0.00"

    if not title:
        print(f"警告:核心字段解析失败,建议人工复查本地 debug.html 结构")
        with open("debug.html", "w", encoding="utf-8") as f:
            f.write(html)
        return None

    return {"title": title, "price": price}
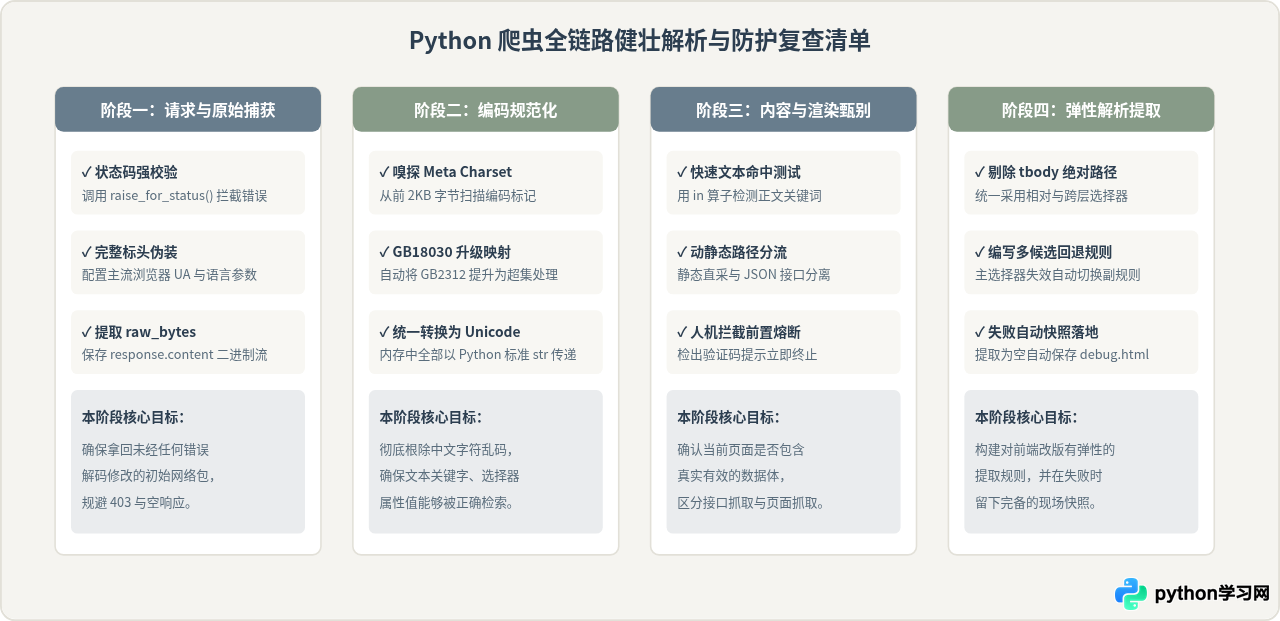
四、排查总结
当 Python 爬虫解析失败时,不需要盲目修改 XPath 或不断重装解析库。按照清晰的排查次序处理即可高效解决:
- 对于中文乱码:放弃不可靠的
response.text默认属性,直接通过response.content获取原始字节流,依据 Meta 标签或utf-8与gb18030顺序进行安全显式解码。 - 对于节点缺失:放弃从浏览器中盲目复制全路径 XPath,通过
in操作核对原始 HTML 快照;若原始响应不含数据,立即从浏览器 Network 选项卡切换至后台 JSON 数据接口,或改用无头浏览器进行页面渲染后再做提取。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









