

面试被问怎么在团队推广Polars替代pandas怎么答?
针对技术面试中关于在团队推广Polars替代pandas的高频难题,提供兼顾工程务实度、投资回报率ROI、双跑验证、渐进演进与风险控制的系统化回答策略与实战指南。
当面试官抛出“如何在团队推广 Polars 替代 pandas”时,核心解题路径在于展现工程务实度与技术治理成熟度:以痛点场景的投资回报率(ROI)为出发点,通过单点基准压测打破疑虑,借助影子双跑验证抹平业务风险,依托规范沉淀与 Arrow 零拷贝中转降低迁移阻力,最终实现平稳渐进的架构演进。
一、透过现象看本质:面试官究竟在考察什么?
在技术面试中,面试官问“怎么在团队推广某项新技术替代老技术”,本质上是一道综合工程素养考核题。很多候选人容易陷入“技术狂热者”的误区,一开口就大谈 Polars 是用 Rust 编写的、底层基于 Apache Arrow、利用了 CPU 的 SIMD 指令集,速度比 pandas 快数倍甚至几十倍。
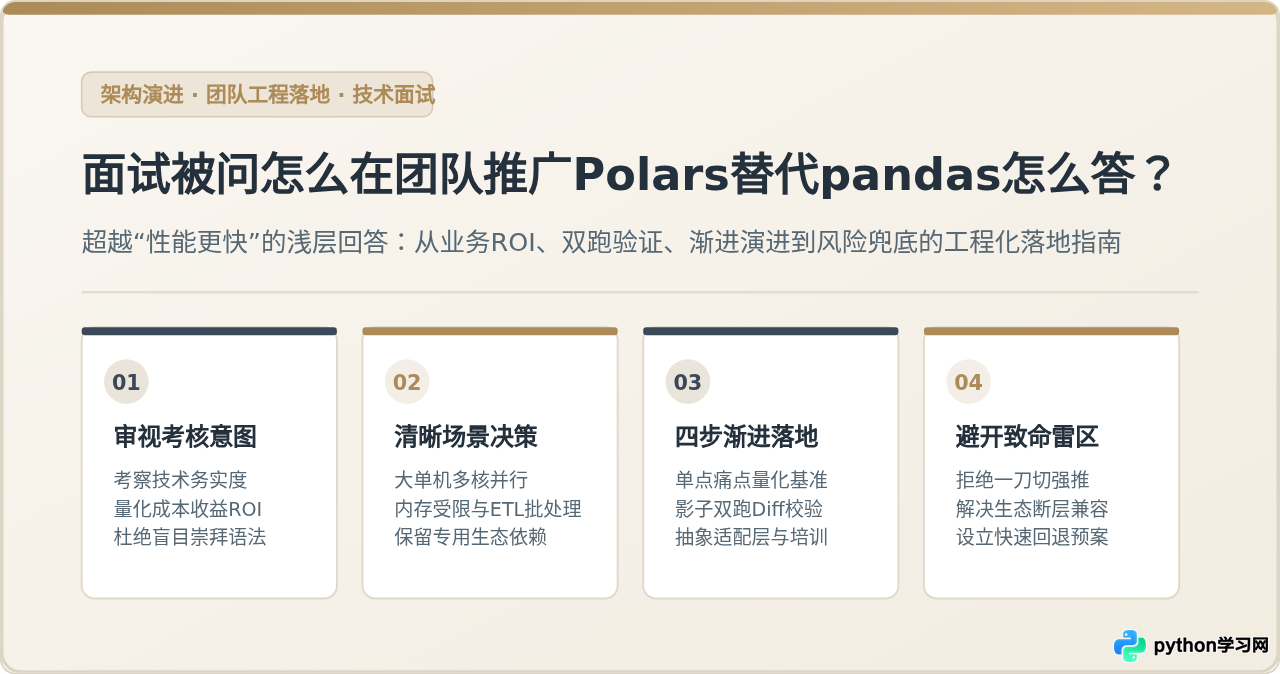
这类回答仅停留在“框架使用者”的初级视角。在资深架构师或团队负责人眼中,盲目推崇新技术反而是一个危险的负面信号。面试官在此刻真正考察的是以下四个维度的工程领导力与务实思维:
- 业务与成本 ROI 意识:技术不是银弹,重写代码需要耗费人月成本、带来线上回归风险。候选人是否会算清机器资源(节省的内存、CPU 成本)与研发维护成本之间的平衡账。
- 渐进式技术演进策略:是激进地搞“一刀切(Big Bang)”全盘重写,还是懂得从小步试点、单点突破到渐进扩面,展现对生产稳定性的敬畏。
- 组织协同与推行动力:如何面对老员工的使用惯性与抵触情绪?如何抹平团队从“行式命令思维”转向“列式声明表达式”的学习摩擦?
- 风险控制与兜底预案:如何应对生态断层(例如某些老库只认 pandas DataFrame)?一旦上线出现问题,是否有平滑降级和一键回退机制?
二、建立理性选型边界:Polars 与 pandas 的核心差异与决策逻辑
回答的第一阶段,需要通过专业严谨的对比,向面试官证明自己对两者的技术内核与适用边界有着清醒的认识。两者的本质差异并不只是“谁比谁快”,而在于底层架构范式的代际不同。
| 对比维度 | pandas (经典架构) | Polars (现代架构) | 工程推广视角的现实考量 |
|---|---|---|---|
| 底层架构 | 基于 C/Cython 与 NumPy 数组,传统行/列存结合 | 基于 Rust 与 Apache Arrow 内存标准列式存储 | Polars 内存紧凑无冗余开销;Arrow 支持跨进程零拷贝互通 |
| 执行模型 | 即时求值(Eager Execution),每一步立即分配新内存 | 支持惰性求值(Lazy Execution),具备查询优化器 | Polars 具备谓词下推(Predicate Pushdown)与投影下推,大幅减少无效I/O |
| 并行计算 | 受 Python GIL 限制,绝大多数操作为单核单线程 | 基于 Rust Rayon 原生多线程,默认打满机器多核 | 对 8 核/16 核以上的现代服务器,Polars 算力利用率呈指数级提升 |
| 索引机制 | 重度依赖复杂索引(Index / MultiIndex) | 摒弃索引,纯以整列(Series/Expr)与行号定位 | 避免因 index 带来的隐式内存复制,但需改变存量代码的数据提取习惯 |
| 生态兼容度 | 极其繁荣,scikit-learn、statsmodels 等无缝兼容 | 处于快速扩展期,部分老旧分析库需要显式中转 | 推广时必须设立桥接适配层,不能强求下游算法库全换 |
| 内存安全性 | 处理大数据时极易引发 OOM(内存溢出崩溃) | 内置 Streaming 流式模式,支持超出内存(Out-of-Core)处理 | 是解决 ETL 任务半夜 OOM 报警的杀手级优势 |
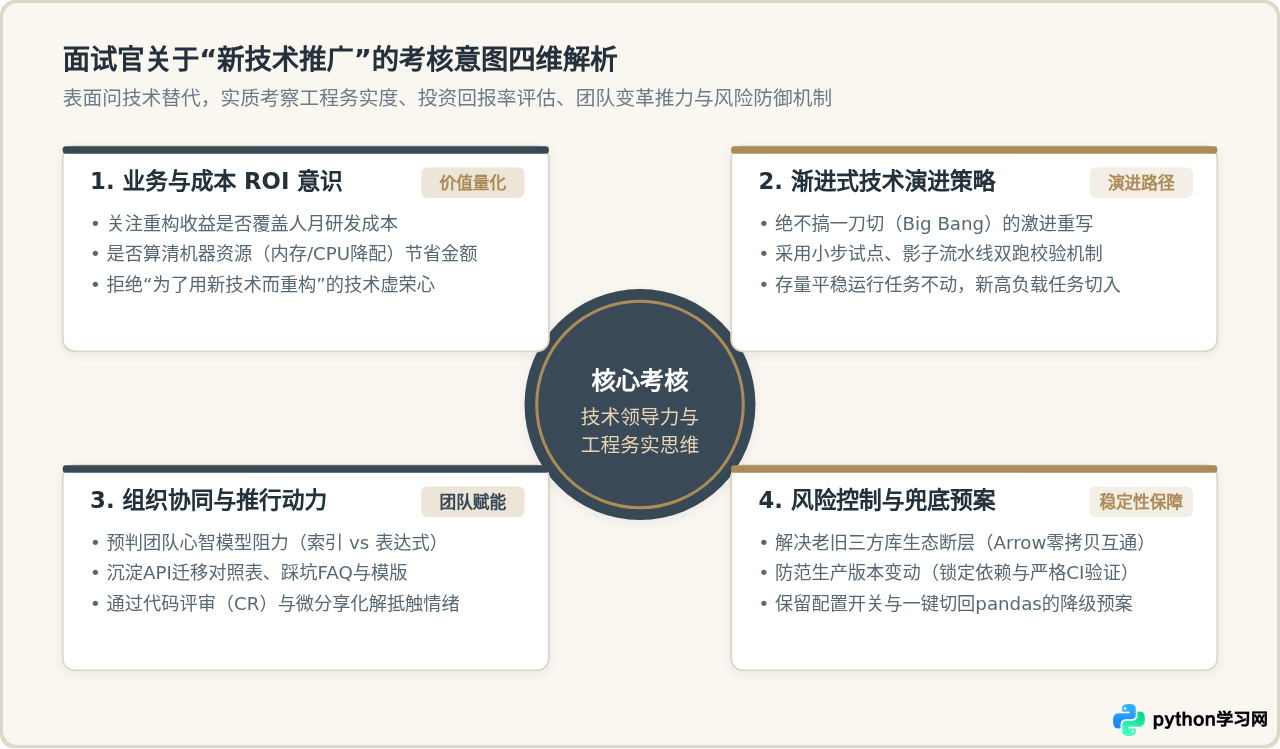
基于上述技术差异,我们绝不能给出“用 Polars 全面替换 pandas”的绝对化结论,而应给出明确的场景选型决策树:
- 优先切入场景:数据量在千万级以上、受限于单机内存、频繁遭遇 OOM 的离线批处理 ETL 脚本;特征工程中的大表关联(Join)与聚合(GroupBy)计算。
- 混合折中场景:上游数据量庞大但下游模型训练(如 scikit-learn / XGBoost)强依赖 pandas 数据结构的管线。此时采用 Polars 负责高吞吐清洗过滤,末端通过 Apache Arrow 零拷贝转为 pandas。
- 坚决维持现状场景:数据量仅在几千到几万行、单次耗时以毫秒计的交互式业务;逻辑深度依赖 MultiIndex 或老旧第三方专用地理库(如 geopandas 遗留接口)且长期稳定运行的系统。
三、四阶段实操推进法:从单点突破到全面落地
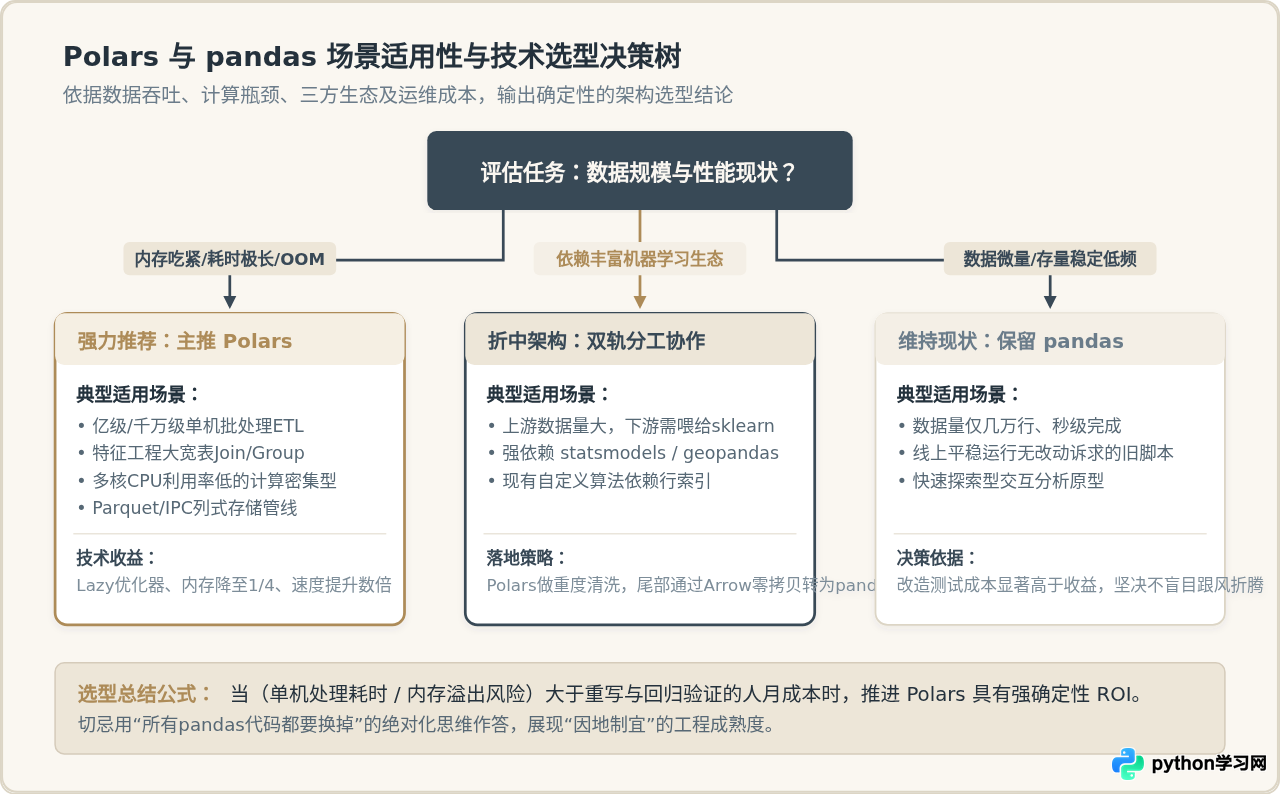
在向面试官阐明选型边界后,接下来进入整道题的核心得分点:在团队内部具体分几步走,如何落地执行?优秀的回答必须具备清晰的操作步骤、量化的交付成果与严谨的风险闭环。
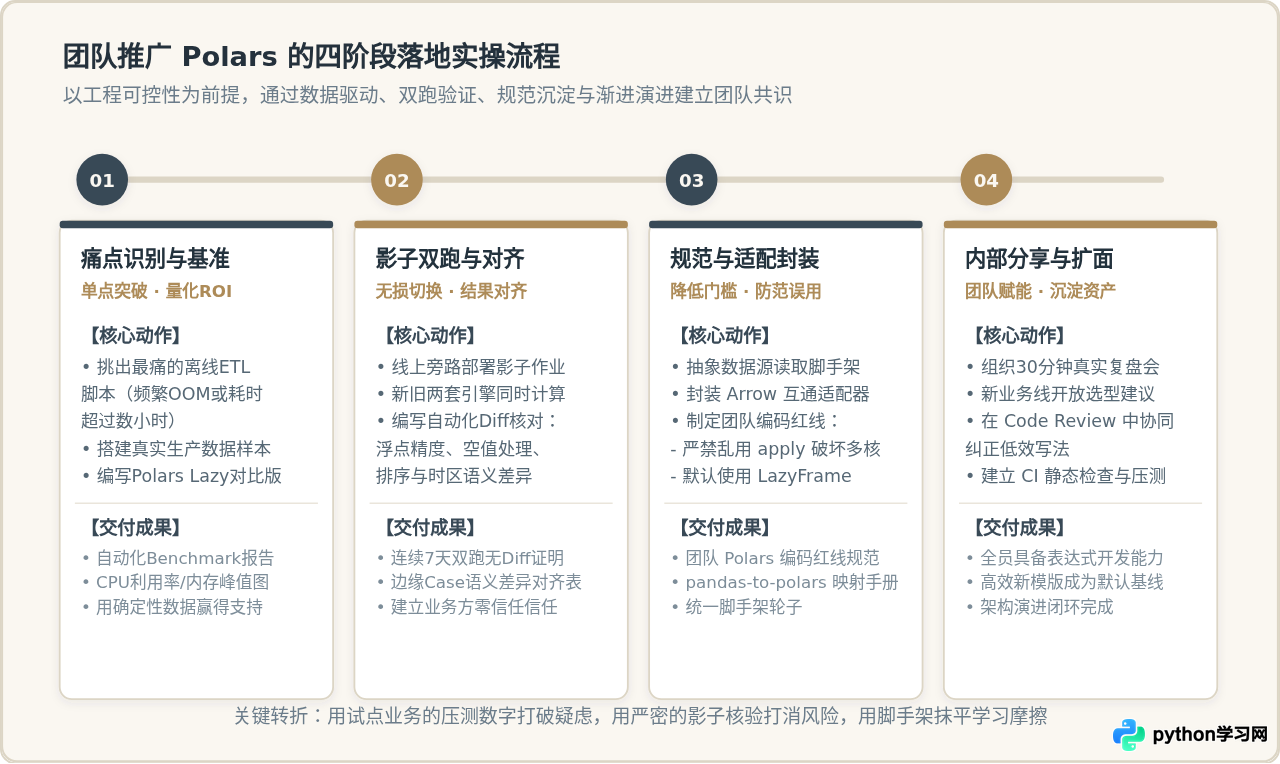
阶段一:痛点识别与基准压测(建立定量说服力)
推广任何技术的第一阻力往往是“现有的能跑,为什么要改”。因此,起步动作绝不是在群里发文章动员,而是寻找痛点最明确、收益最直观的单点突破口。
具体操作方法:
- 锚定瓶颈任务:在定时任务调度平台(如 Airflow 或 DolphinScheduler)中,挑出耗时超过 1 小时或每个月都会因内存飙升触发一两次 OOM 告警的日批任务。
- 构建隔离压测环境:拉取脱敏后的真实生产数据切片,使用 Polars 的
lazy()管道重写该任务的核心计算逻辑。 - 产出量化 Benchmark 报告:记录两套方案在相同规格机器下的 CPU 核心利用率曲线、内存峰值(Peak Memory)以及端到端执行耗时。例如展示:“处理 40GB 交易日志,pandas 耗时 54 分钟且峰值内存逼近 32GB 触发告警;Polars 耗时 6 分 20 秒,内存稳定在 8GB 以内”。
用一组无可辩驳的生产级压测数据,向技术主管与业务方证明迁移该任务的必要性与投入产出比。
阶段二:影子双跑与数据对齐(消除业务信任顾虑)
性能提升只是手段,计算结果的绝对正确才是底线。业务方最担心的永远是“换了引擎后算出来的数据变了”。
具体落地机制:
- 部署影子流水线(Shadow Pipeline):在生产环境旁路并行触发两套引擎,输入相同的源数据,分别产出结果。
- 编写全字段自动化 Diff 核对工具:针对业务输出结果进行逐行逐字段的比对,重点关注四类细微语义偏差:
- 浮点数累加精度差异:由于多线程并行归约(Parallel Reduction)的运算顺序与单线程串行不同,浮点数尾数可能存在微小差异,需设置合理的容差阈值(如
atol=1e-6)。 - 缺失值填充策略:pandas 中的
NaN(数值)与None(对象)混杂,而 Polars 严格区分null(缺失语义)与NaN(无效浮点)。 - 分组聚合排序稳定性:pandas 的
groupby默认对键进行排序,而 Polars 为追求最大并发性能,默认不保证组顺序(需显式声明maintain_order=True)。 - 时区与时间戳截断:对齐两者在跨时区解析和纳秒/微秒精度截断上的行为。
- 浮点数累加精度差异:由于多线程并行归约(Parallel Reduction)的运算顺序与单线程串行不同,浮点数尾数可能存在微小差异,需设置合理的容差阈值(如
- 确立切换准则:要求影子双跑在生产环境连续正常运行至少两周,且关键财务或业务指标校验达成 100% 一致后,方可启动正式切流。
阶段三:制定编码规范与封装适配层(降低团队踩坑门槛)
当单点任务验证成功后,如果要向更多同事推广,必须解决团队认知阻力与不规范用法的问题。如果直接把 Polars 丢给习惯了 pandas 的工程师,他们往往会写出违背 Polars 设计初衷的代码。
团队内部需要沉淀三项关键技术资产:
- 制定团队《Polars 编码红线规范》:
- 严禁随意使用
apply():在 Polars 中滥用 Python 自定义函数调用会打碎底层 Rust 的向量化与并发调度,性能甚至可能倒退回比 pandas 还慢。必须优先使用原生表达式(pl.col(...))或map_batches()。 - 默认使用 LazyFrame 管道:除交互调试外,工程代码必须统一以
scan_parquet()/scan_csv()起步,最后通过collect()执行,以充分发挥查询优化器的算子融合与下推能力。 - 消灭全局依赖:避免将 Polars 类型深度渗透到整个项目的各个角落,关键输入输出保持接口清晰。
- 严禁随意使用
- 封装统一的数据源与兼容适配器:提供统一的脚手架函数,例如处理数据源读取、统一日期格式转换,以及向下游老算法提供零拷贝的
to_pandas()转换桥。 - 编写常见语法映射速查手册:列出
loc/iloc、query()、melt()、assign()等常用 pandas 语法在 Polars 中的标准对应写法,降低新人的查阅成本。
阶段四:知识传递与渐进式扩面(组织赋能与资产沉淀)
最后一步是建立组织共识,使新技术在团队内健康生根发芽:
- 举办实战复盘分享会:以第一阶段的真实调优案例为题材,分享优化前后的资源监控图、踩过的时区或 null 值坑,让大家看到切实的价值。
- 在代码评审(Code Review)中柔性指导:指定熟悉 Polars 表达式体系的工程师参与日常 CR,帮助新人识别低效循环、不必要的
eager转化,指导编写地道的 Polars 表达式。 - 新模块优先试点,存量稳定系统坚决不动:明确推广原则——新立项的离线数据工程项目推荐优先采用 Polars 模版,历史稳定且无性能瓶颈的系统不予改动,杜绝无谓的技术内卷。
四、工程代码实战与关键迁移示范
在面试中,如果能随口列举一两处具体的 API 范式差异与工程解决方案,将极大增强回答的真实感与技术深度。
1. 从命令式过程到声明式表达式与查询优化
pandas 通常采用逐步执行、创建中间临时表的命令式写法;而 Polars 提倡通过声明式表达式将过滤、计算与聚合组织在同一个 Lazy 管道中:
# === 传统 pandas 写法:每一步均触发即时计算并生成中间 DataFrame ===
import pandas as pd

df = pd.read_parquet("s3://bucket/transactions.parquet")
df_filtered = df[df["status"] == "SUCCESS"]
df_filtered["amount_cny"] = df_filtered["amount"] * df_filtered["fx_rate"]
result = df_filtered.groupby("merchant_id").agg(
    total_sales=("amount_cny", "sum"),
    avg_ticket=("amount_cny", "mean")
)

# === 现代 Polars 写法:构建执行图,自动执行列裁剪与谓词下推 ===
import polars as pl

lazy_plan = (
    pl.scan_parquet("s3://bucket/transactions.parquet")
    .filter(pl.col("status") == "SUCCESS")  # 优化器会将过滤下推至 Parquet 扫描阶段
    .group_by("merchant_id")
    .agg(
        (pl.col("amount") * pl.col("fx_rate")).sum().alias("total_sales"),
        (pl.col("amount") * pl.col("fx_rate")).mean().alias("avg_ticket")
    )
)
# 统一触发执行,原生 Rayon 多线程并发
result_df = lazy_plan.collect()
2. 跨生态下游的零拷贝互通策略
当特征工程由 Polars 完成,但下游模型训练代码必须传入 pandas DataFrame 时,无需担心内存重复复制。通过 Apache Arrow 内存格式共享,可以实现极低开销的跨框架桥接:
# Polars 执行重度清洗与大表 Join
clean_features_pl = (
    pl.scan_parquet("feature_store.parquet")
    .filter(pl.col("is_active") == True)
    .with_columns(
        (pl.col("feature_a") - pl.col("feature_a").mean()).over("category").alias("norm_a")
    )
    .collect()
)

# 借助 PyArrow Extension Arrays 进行低开销零拷贝桥接,供 scikit-learn / LightGBM 消费
pandas_df = clean_features_pl.to_pandas(use_pyarrow_extension_array=True)
3. 自动化影子双跑 Diff 校验脚本模版
在持续集成(CI)或影子调度作业中,使用如下核验逻辑保障业务无感切换:
def verify_pipeline_consistency(df_pandas: pd.DataFrame, df_polars: pl.DataFrame):
    """核对两端产出在行数、数值与分布上的严格一致性"""
    # 1. 行列形状核验
    assert df_pandas.shape == df_polars.shape, f"维度不匹配: pandas {df_pandas.shape} vs polars {df_polars.shape}"

    # 2. 转换为一致排序后进行字段核验
    pl_as_pd = df_polars.to_pandas().sort_values(by="primary_key").reset_index(drop=True)
    df_pandas_sorted = df_pandas.sort_values(by="primary_key").reset_index(drop=True)

    # 3. 校验浮点数容差与缺失值分布
    pd.testing.assert_frame_equal(
        df_pandas_sorted,
        pl_as_pd,
        check_dtype=False,  # 容忍某些int32/int64的存储差异
        atol=1e-5,          # 容忍多线程并发归约带来的微小浮点误差
        rtol=1e-5
    )
    print("[PASS] 影子流水线校验通过,数值完全对齐。")
五、现场高分结构化口述参考模板
将上述工程逻辑提炼为面试现场可直接表达的口述结构,语言自然、逻辑闭环,能够让面试官在 3 分钟内明确感受到候选人的架构设计素养:
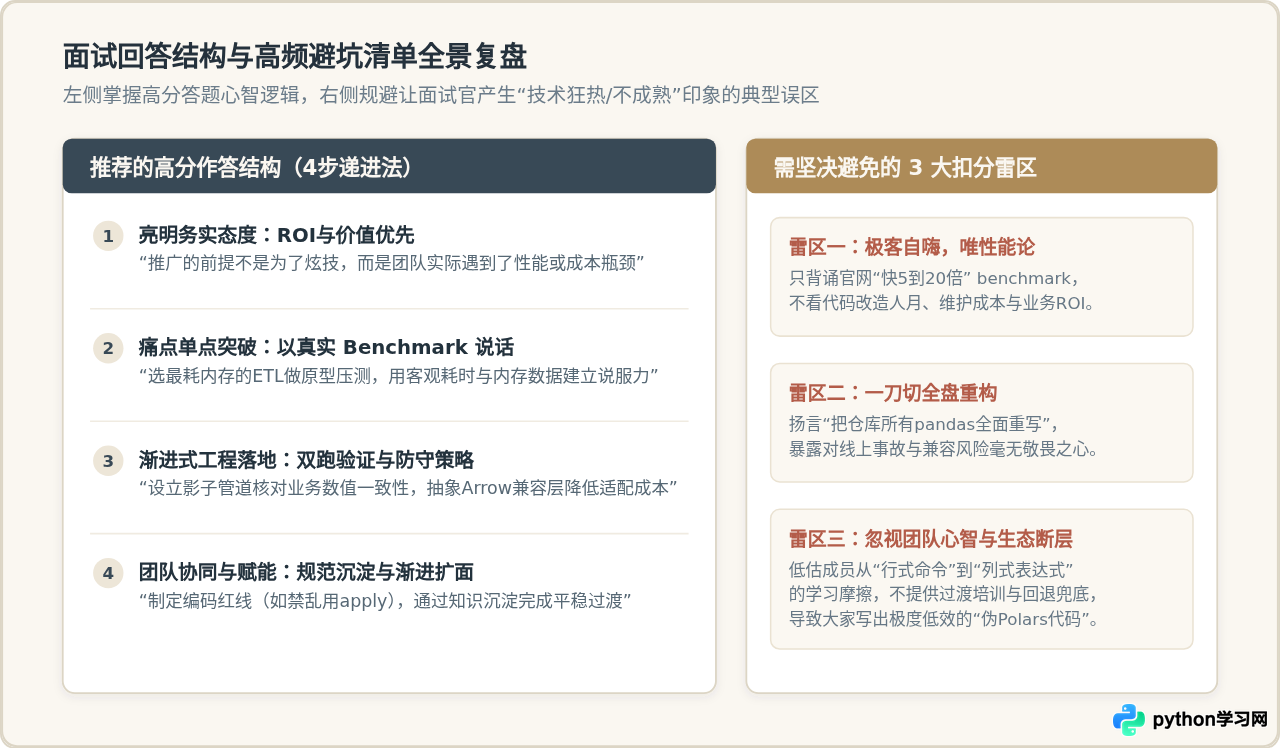
“在团队里推行 Polars 替代 pandas,我的核心思路是‘务实 ROI 驱动、小步单点试点、严格影子验证、渐进赋能扩面’,而不是一上来搞一刀切的全量重写。
首先,明确评估边界。Polars 的核心优势在于原生多核并行、Arrow 列式内存以及 Lazy 优化器,能成倍降低处理耗时和内存消耗;而 pandas 的优势是庞大的历史生态与团队使用惯性。因此,我不会主张重写所有代码,而是将切入点放在‘面临性能瓶颈或 OOM 痛点的千万级离线批处理 ETL 脚本’上,存量稳定的小脚本坚决维持原状。
其次,落地分四步推进:
第一步是单点压测立标杆。选一个最痛的批处理脚本重写核心计算,量化 CPU 利用率、峰值内存和耗时数据,用真实的 Benchmark 报告争取团队与负责人的认可。
第二步是影子双跑防风险。在生产环境旁路并行两套作业,编写 Diff 工具核验两周以上的业务输出,重点拉齐浮点容差、缺失值与排序规则,确保计算结果 100% 正确。
第三步是规范沉淀降摩擦。沉淀团队开发规范,明确‘默认使用 Lazy 模式、严禁滥用 apply’等编码红线,并封装数据读写与基于 Arrow 的 to_pandas 零拷贝转换桥,解决下游模型库兼容问题。
第四步是团队赋能与渐进扩面。通过案例复盘会与代码评审引导团队逐步掌握表达式语法,将 Polars 纳入新模块的默认基线模版,完成架构的平滑过渡。
最后,设置安全回退机制。在接口层保留配置开关,若试点任务遇到偶发底层异常,可一秒切回原有的 pandas 备用链路,确保生产稳定永远放在首位。”
六、避坑清单:必须警惕的三大扣分雷区
为了确保回答万无一失,还需要在作答时主动避开常见思维陷阱,避免触发面试官对候选人工程心智不成熟的隐忧:
在回答中全程只复读“Polars 比 pandas 快 10 倍”,却对业务改造成本、测试回归人月和维护开销视而不见。成熟的工程师懂得:当计算耗时只占整个业务周期的 1% 时,将其优化 10 倍对商业价值的贡献几乎为零。
声称“推动全公司统一技术栈,限期将老仓库中的 pandas 全部替换掉”。这种激进表态往往暴露了缺乏实际大中型系统维护经验,对线上兼容事故与业务连续性缺乏基本敬畏。
认为只要发个文档大家就能自然用好 Polars。实际上,pandas 的“命令式/索引查找”习惯极难扭转,团队如果不经培训,极易写出 for iterrows() 或嵌套 apply() 的低劣代码,不仅并发优势全无,还会因内存频繁解包造成更大负担。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









