

数据科学从业者首选:Jupyter Notebook作为免费Python IDE的优势与用法
深入解析为什么Jupyter Notebook成为数据科学从业者的首选免费Python交互式开发环境。涵盖其核心优势、架构运作原理、从安装到上手的完整步骤、高效快捷键与魔法命令,以及数据探索与建模中的最佳实践。
对于从事数据分析、机器学习和统计建模的专业人员而言,编写代码只是整个探究流程的一部分,更核心的工作是即时检验数据假设、洞察数据分布并直观呈现实验结果。Jupyter Notebook 凭借轻量灵活的单元格交互模式、图文与代码混排的叙事能力以及完全开源免费的生态支持,已成为数据科学从业者首选的 Python 集成开发与实验环境。本文将直接解析其相对于传统脚本型 IDE 的关键优势、底层解耦架构,并提供从环境配置、核心快捷键操作到探索性数据分析(EDA)工作流的完整实操指南。
一、为什么数据科学从业者偏爱 Jupyter Notebook
在传统的集成开发环境(如 PyCharm、VS Code 纯脚本模式)中,开发者的基本操作流程通常是编写完整文件、启动脚本进程,并在终端观察最终输出。这种模式极适合构建工程结构严谨、逻辑分支明确的后台系统或服务接口,但在面对充满未知变数的数据分析任务时,却暴露出显著的效率短板。
数据科学的核心是“探索”。分析师在读取一份数个吉字节(GB)的交易日志或图像数据后,需要不断执行微调:检查缺失字段、计算均值、绘制直方图、尝试不同特征工程组合。如果每次微调一段三行的清洗逻辑,都要重启解释器并重新把庞大的数据集从磁盘载入内存,将浪费大量无谓的等待时间。Jupyter Notebook 正是针对这种痛点给出了优雅的解决方案:
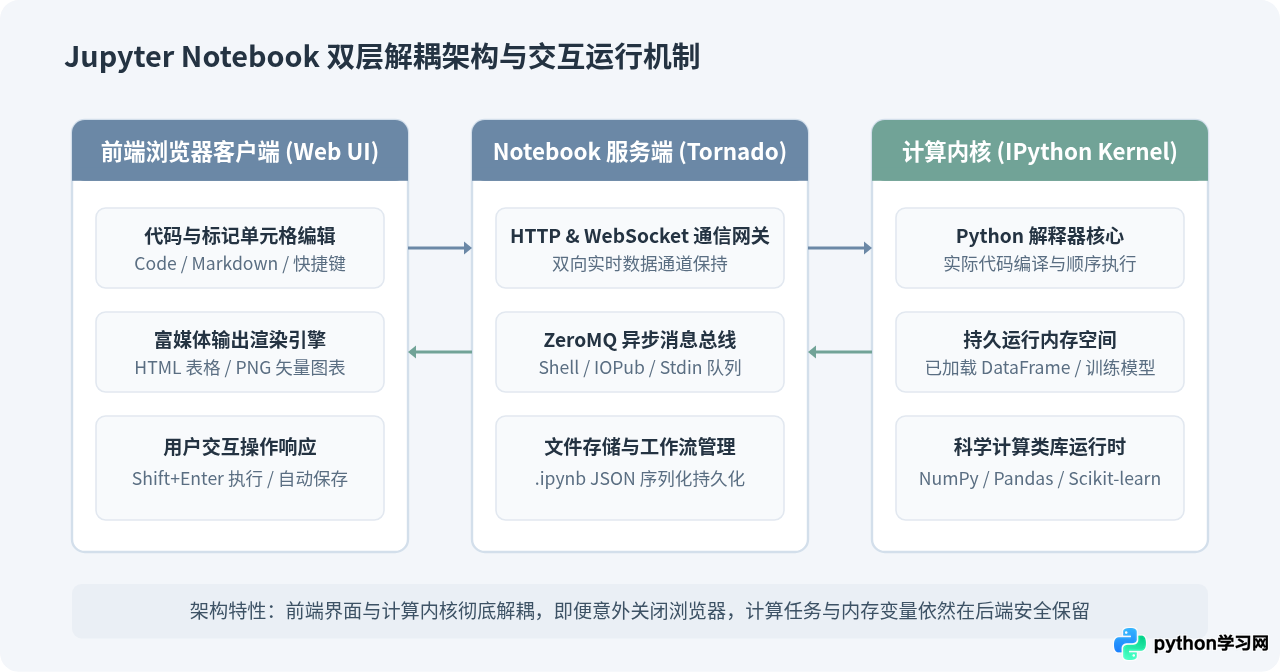
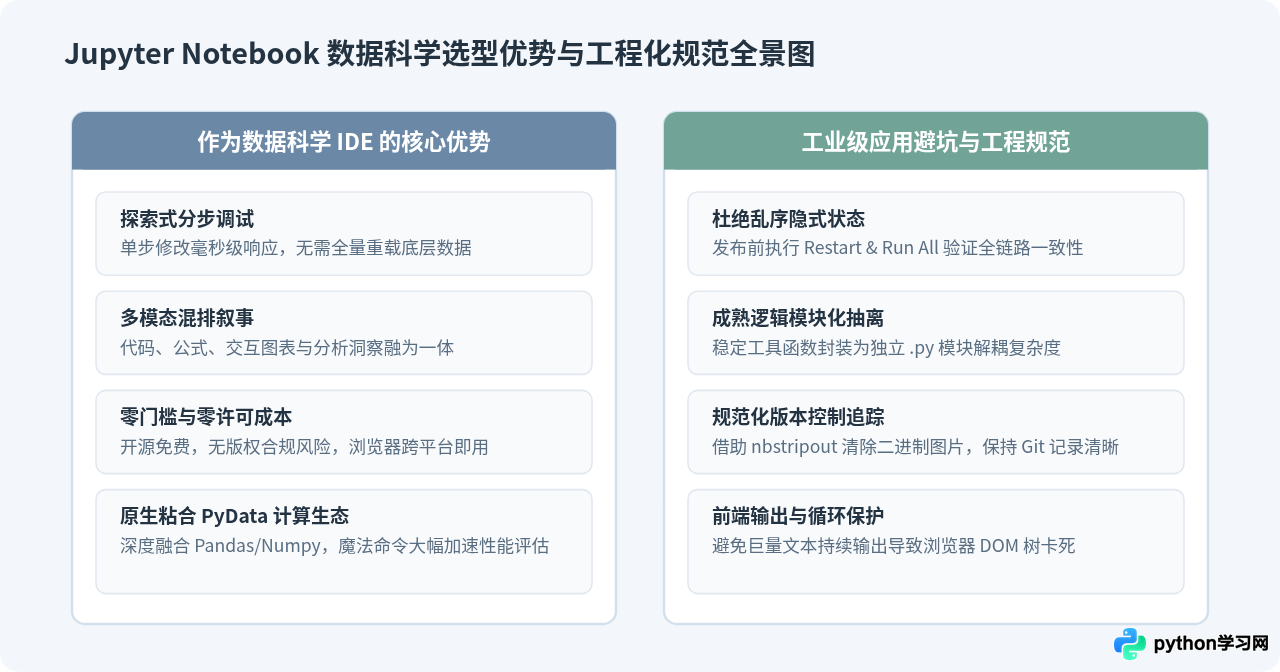
- 分块执行与内存状态持久驻留:Jupyter 采用基于单元格(Cell)的交互计算模式。用户可以将数据读取、特征处理、绘图可视化拆分放置在不同的单元格中。一旦前面的数据加载单元格执行完毕,数据对象就会持续保存在后台 Python 内核的内存空间中;后续修改和重新运行分析代码时,只需毫秒级即可得到反馈。
- 代码、图表与文档一体化呈现:Jupyter 原生支持 Markdown 标记语言、LaTeX 数学公式与富媒体输出。表格数据不仅能以美观的 HTML 交互网格展示,Matplotlib、Seaborn 等库生成的统计图表也能直接内嵌在对应代码单元格正下方,形成一份逻辑完整、兼具说明与结论的可执行分析报告。
- 完全开源免费与轻量便携:基于宽松的 BSD 开源协议,个人开发者与商业团队均无需支付任何软件授权或订阅费用。服务端基于标准的 Web 协议运行,既能在个人笔记本电脑上本地单机使用,也可部署于高性能云端 GPU 服务器,用户只需通过普通浏览器即可跨平台接入使用。
- 与 PyData 科学计算生态的无缝粘合:IPython 内核提供了极为强大的自动补全、即时文档窥探以及一系列独有的“魔法命令(Magic Commands)”,使得调试代码瓶颈、性能分析和环境管理变得极为顺手。
二、从零开始:搭建与启动 Jupyter Notebook 环境
为了保障不同项目之间的库版本不产生冲突,最稳健的做法是为数据科学项目创建独立的 Python 虚拟环境,并在该虚拟环境中安装 Jupyter 及其依赖库。
1. 创建独立虚拟环境与安装
打开终端(Windows 平台使用 PowerShell 或 CMD,macOS/Linux 使用 Terminal),进入你的工作目录,依次执行以下命令:
# 1. 创建名为 ds_env 的虚拟环境
python3 -m venv ds_env

# 2. 激活虚拟环境
# macOS / Linux:
source ds_env/bin/activate
# Windows:
# .\ds_env\Scripts\activate

# 3. 在当前虚拟环境中安装 Jupyter 及常用数据科学库
pip install --upgrade pip
pip install jupyter pandas numpy matplotlib seaborn scikit-learn
如果使用的是 Anaconda 发行版,由于 Anaconda 已经默认集成了 Jupyter 及常用科学计算库,也可以直接使用 conda 命令创建专用环境:
# Conda 用户可选命令
conda create -n ds_env python=3.10 jupyter pandas scikit-learn matplotlib seaborn -y
conda activate ds_env
2. 启动服务与访问
激活环境后,在终端输入启动命令:
jupyter notebook执行该命令后,终端将输出运行日志,并自动调用系统默认浏览器打开工作区仪表盘(Dashboard),访问地址通常为 http://localhost:8888/tree。如果服务运行在没有安装图形界面的远程服务器上,可添加参数指定端口并不自动调起浏览器:
# 远程或容器环境中常用启动方式
jupyter notebook --no-browser --port=8888 --ip=0.0.0.0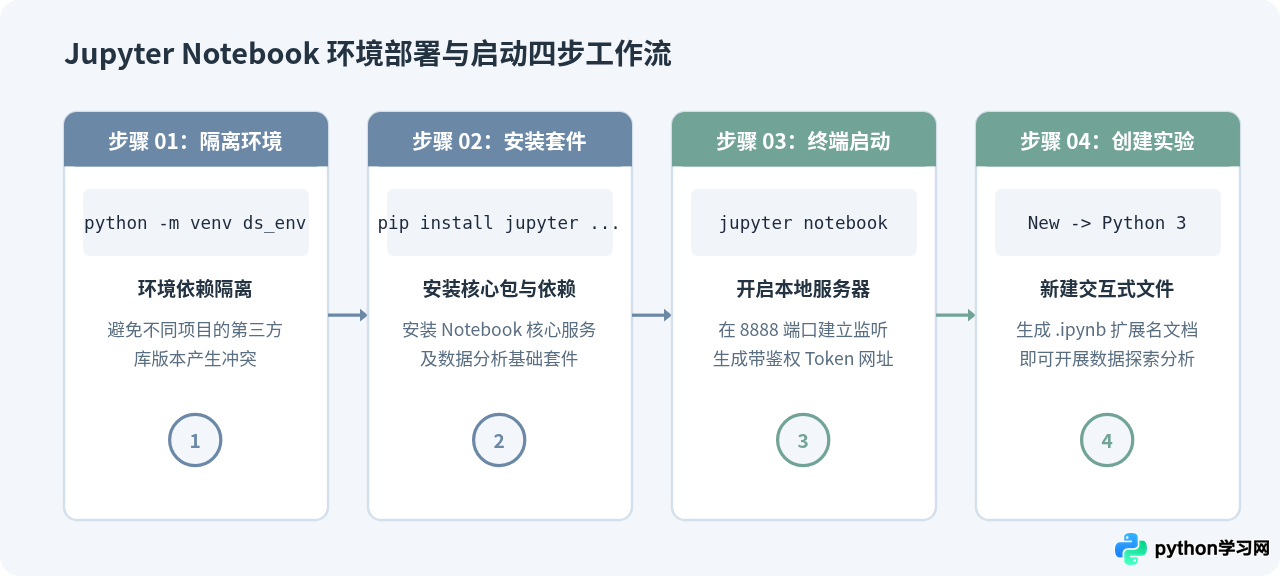
三、日常高频操作:双模式与必备快捷键
很多初学者使用 Jupyter 时过度依赖鼠标点按工具栏,这会显著打断数据探索时的思考节奏。Jupyter 借鉴了 Vim 编辑器的“模式转换”设计哲学,将操作状态分为命令模式(Command Mode)和编辑模式(Edit Mode)。
- 编辑模式:单元格边框显示为绿色(或左侧出现粗条高亮),此时光标在输入框内闪烁,所有按键均直接输入为代码或文本。从命令模式进入编辑模式,只需按键盘的
Enter键。 - 命令模式:单元格边框显示为灰色或蓝色,光标不再闪烁,此时键盘按键充当操作整个单元格结构的快捷指令。从编辑模式退回命令模式,按键盘的
Esc键。
| 按键指令 | 适用模式 | 功能描述与应用场景 |
|---|---|---|
Shift + Enter |
所有模式 | 执行当前单元格,并在执行完成后自动选中或新建下一个单元格(最常用的推进键)。 |
Ctrl + Enter |
所有模式 | 执行当前单元格,但光标和焦点仍保持停留在当前单元格内(常用于反复调试单块代码)。 |
A / B |
命令模式 | 在当前单元格上方(Above)或下方(Below)插入一个新的空白单元格。 |
D, D |
命令模式 | 连续按两次字母 D,快速删除当前所在的单元格。 |
M / Y |
命令模式 | 按 M 将单元格转换为 Markdown 格式;按 Y 重新转回 Python 代码单元格。 |
Shift + Tab |
编辑模式 | 光标停留在函数名或参数括号内时按下,立即弹出官方函数签名与文档说明。 |
四、加速数据分析的“魔法命令(Magic Commands)”
IPython 内核内建了数十种特殊的魔法命令,用于增强开发体验。以 % 开头的为“行魔法(Line Magic)”,仅对当前单行生效;以 %% 开头的为“单元格魔法(Cell Magic)”,对整个单元格内容生效。
1. 常用魔法命令示例
# 1. 确保 Matplotlib 绘制的图像在 Notebook 内联输出显示
%matplotlib inline

# 2. 测量一段代码单次执行的真实墙上耗时(Wall time)
%time [x**2 for x in range(100000)]

# 3. 对耗时较短的算法进行统计基准测试(自动多次循环评估均值与标准差)
%timeit -n 100 -r 3 sorted([5, 2, 9, 1, 5, 6])

# 4. 打印当前内存在运行中的所有全局变量及其类型、内存占用
%whos

# 5. 直接执行操作系统终端指令(使用英文感叹号前缀)
!pip list | grep pandas实用提示:使用 %lsmagic 可以列出当前内核环境下支持的所有行魔法与单元格魔法命令;如果想查看某个魔法命令的详细文档,在名称后追加问号即可,例如 %timeit?。
五、数据科学典型工作流:从探索到建模实战
在数据科学项目中,一个典型的 Notebook 通常由若干逻辑连贯的单元格依次组成。以下展示从加载数据、切片探索、统计可视化到基础模型拟合的标准闭环:
# 单元格 1:导入核心库并设定展示配置
import pandas as pd
import numpy as np
import matplotlib.pyplot as plt
import seaborn as sns
from sklearn.model_selection import train_test_split
from sklearn.linear_model import LogisticRegression
from sklearn.metrics import classification_report

%matplotlib inline
plt.rcParams['font.sans-serif'] = ['PingFang SC', 'Microsoft YaHei', 'sans-serif']
plt.rcParams['axes.unicode_minus'] = False
# 单元格 2:模拟样本数据并直接检查前五行结构
np.random.seed(42)
sample_size = 500
data = pd.DataFrame({
'特征A_访问时长': np.random.normal(loc=12, scale=4, size=sample_size),
'特征B_购买频次': np.random.poisson(lam=3, size=sample_size),
'高价值用户': np.random.choice([0, 1], size=sample_size, p=[0.7, 0.3])
})
# 无需写 print(),直接将变量名置于最后一行即可触发富媒体渲染
data.head()# 单元格 3:数据探索性统计与分布可视化
plt.figure(figsize=(8, 4))
sns.boxplot(x='高价值用户', y='特征A_访问时长', data=data, palette=['#6B88A6', '#71A397'])
plt.title('高价值用户与访问时长分布对比')
plt.xlabel('高价值标识 (0: 普通, 1: 高价值)')
plt.ylabel('访问时长 (分钟)')
plt.show()# 单元格 4:切分训练集与测试集,拟合模型并评估
X = data[['特征A_访问时长', '特征B_购买频次']]
y = data['高价值用户']
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.2, random_state=42)
model = LogisticRegression()
model.fit(X_train, y_train)
y_pred = model.predict(X_test)
# 输出评估报告
print(classification_report(y_test, y_pred, digits=4))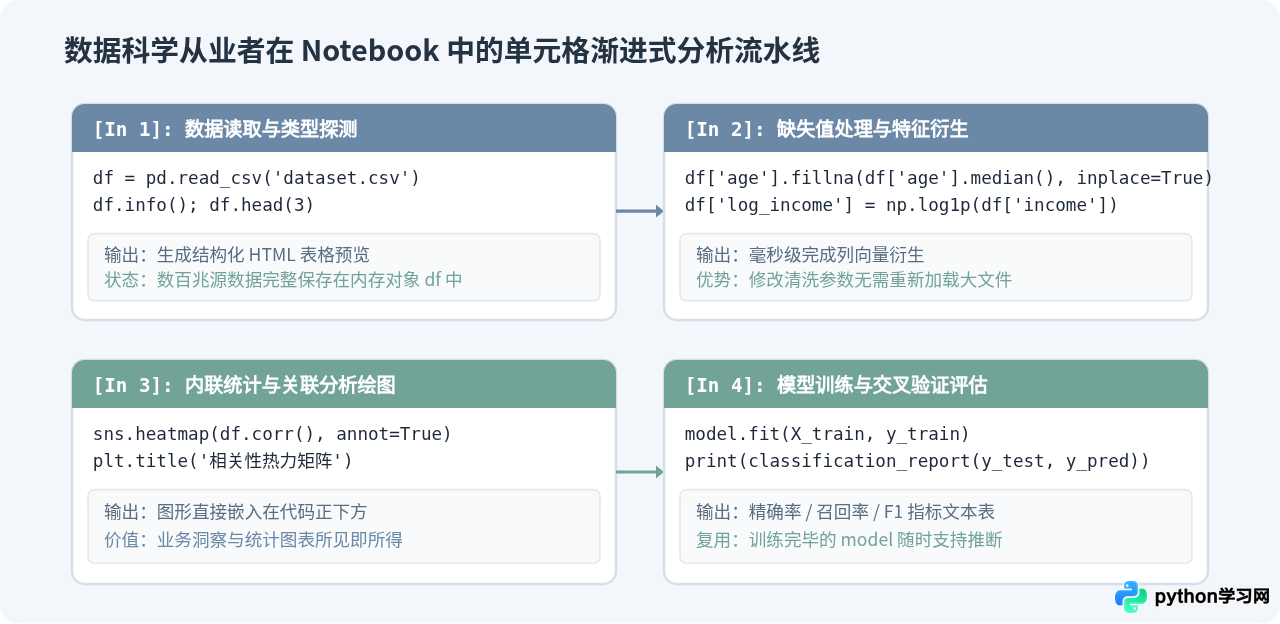
六、工程实践边界与避坑指南
虽然 Jupyter Notebook 在探索阶段极具生产力,但由于其高度灵活的自由度,若不遵守良好的工程纪律,容易产生“隐式状态混乱”和“代码难以维护”的问题。以下是专业从业人员总结的关键防护原则:
- 防范隐式状态与乱序执行陷阱(Hidden State):单元格左侧的
In [12]数字标明了其实际执行的先后顺序。如果在开发过程中向上回滚修改了变量定义却未重新运行中间单元格,当前内存状态将与页面自上而下的视觉顺序严重脱节。最佳实践:在导出或分享 Notebook 之前,务必点击菜单栏的Kernel -> Restart & Run All(重启内核并从头运行所有单元格),确保整篇文档具备 100% 的可复现性。 - 避免在单元格中无节制输出海量文本:如果在未做限制的
for循环中持续print()数万行文本,所有字符串都会被实时发送并填充至浏览器的 DOM 树中,导致前端标签页极度卡顿甚至崩溃。对于大规模迭代,应使用tqdm进度条库或定期抽样输出。 - 成熟逻辑适时抽离为
.py模块:Notebook 的最佳定位是“试验场”与“展示画板”。当数据清洗逻辑、自定义指标函数经过验证稳定后,应当将这些纯业务逻辑代码抽取为同目录下的独立 Python 模块(例如utils.py),在 Notebook 中仅使用from utils import clean_data引用。这样既保持了主界面的清晰整洁,也便于团队代码评审与单元测试。 - 版本控制与代码差异(Git Diff)管理:
.ipynb底层是以 JSON 格式存储的纯文本文件,其中包含了庞大的 Base64 编码图片数据及元数据,直接使用 Git 提交容易产生冗长混乱的冲突差异。建议在团队仓库中集成开源工具nbstripout(在提交前自动剔除图表输出数据),或配合jupytext将 Notebook 双向同步映射为干净的 Markdown / Python 脚本。
七、总结
Jupyter Notebook 并不是传统代码编辑器或工程化 IDE 的简单替代品,而是专注于“实验验证与交互洞察”的高效科学计算工作台。通过利用其分步执行保留内存的特性,数据科学从业者得以从漫长死板的“编写-运行-重载”循环中解放出来,将注意力集中在数据洞见与特征算法本身。结合合理的虚拟环境隔离、规范的快捷键与工程化清理法则,Jupyter Notebook 构成了每一位数据科学工作者最值得信赖的数字化实验伙伴。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









