

Python新手必知的5个高频报错及快速解决方法
针对Python初学者最常遇到的5类高频报错(SyntaxError、IndentationError、NameError、TypeError、IndexError),系统梳理报错原因、排查线索、修复对比及验证方案,帮助快速建立规范的代码调试习惯。
Python 解释器在运行异常时输出的 Traceback(回溯信息),常被初学者视作阻碍,但它本质上是程序在出错瞬间提供的现场快照。只要掌握这套包含错误类型、具体行号及上下文调用链的排错指引,90% 的新手问题都能在数分钟内排查并修复。本文梳理 Python 学习中最易遇到的 5 类核心高频报错,结合具体场景分析诱发原因、提供对比代码,并给出标准的定位与解决路径。
一、排错基石:四步看懂 Traceback 错误回溯
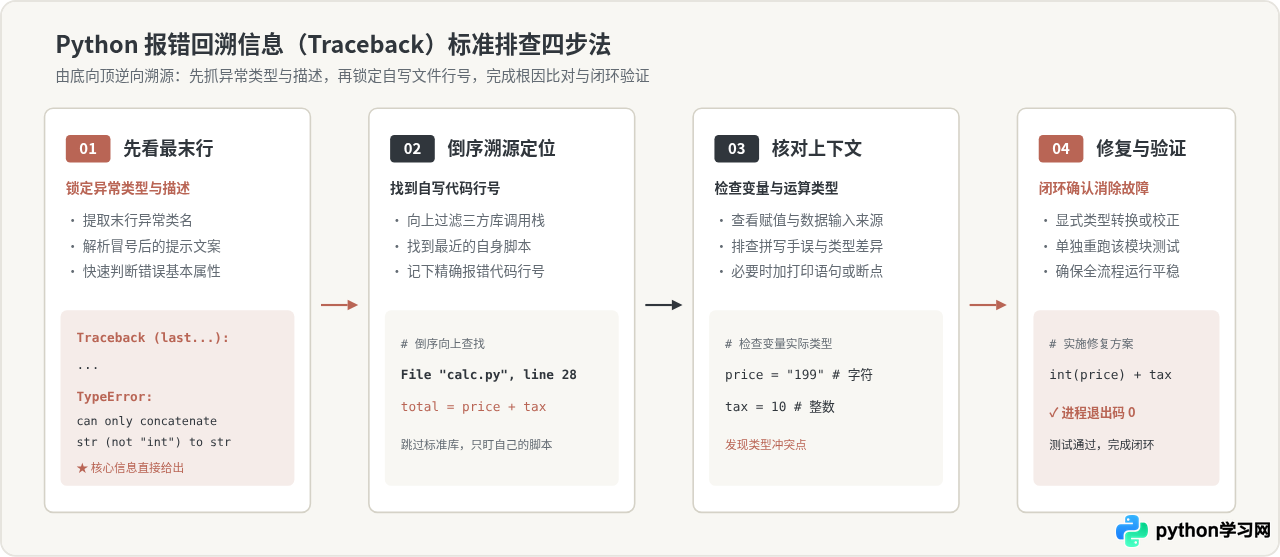
当 Python 脚本遇到无法继续执行的状况时,终端会打印一段由若干行组成的回溯日志。许多初学者习惯性地只看最上面一行,或者因为看到大段英文报错而不知所措。其实,阅读 Traceback 的正确顺序是“从底向上、顺藤摸瓜”。
- 第一步(先看末行):回溯信息的最后一行直接标明了异常类型(Exception Type)和错误简述。例如
TypeError: can only concatenate str (not "int") to str,已明确指出试图将字符串与整数直接相加。 - 第二步(倒序找行号):从最后一行向上倒推,找到由你编写的
.py业务代码文件及具体行号(如File "main.py", line 12),避开 Python 自带标准库或第三方库的深层内部文件。 - 第三步(核对上下文):回到编辑器中打开对应行,检查该行引用的变量名拼写、括号是否对称、数据类型是否与预期匹配。
- 第四步(修改并验证):针对定位到的根因修改代码,通过隔离运行或执行单测确认该错误不再抛出。
二、高频报错 1:SyntaxError(语法错误)
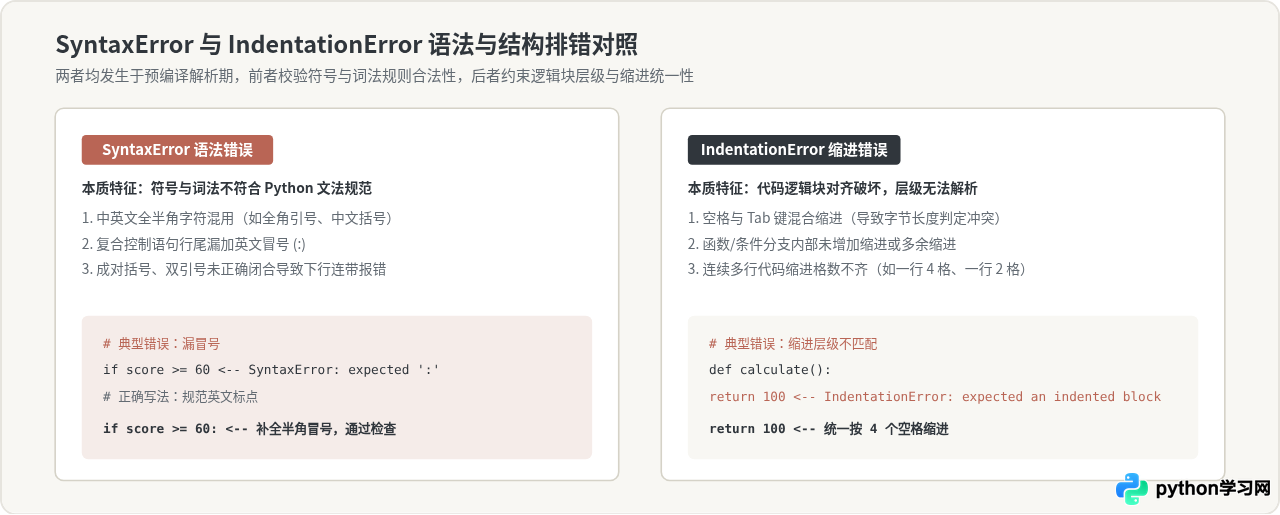
SyntaxError 发生在代码运行之前的语法解析(Parsing)阶段。由于代码违反了 Python 的基础语法规范,解释器无法将其转换为抽象语法树(AST),因此程序甚至不会开始执行第一条业务逻辑。
1. 常见诱发场景
- 遗漏末尾冒号:在
if、elif、else、for、while、def、class、try、except等复合语句的行尾遗漏半角冒号:。 - 误用全角/中文标点符号:输入法在中文状态下打出全角括号
()、全角引号“”、中文逗号,或中文冒号:。 - 括号或引号未成对闭合:单引号与双引号混用、多层嵌套括号漏写右括号。注意:当某行末尾漏写括号时,Python 解释器常常会将
SyntaxError标记在下一行,因为解释器一直在等待当前语句结束。 - 保留关键字被用作变量名:将
def、class、for、pass、return等系统关键字作为变量或函数名称。
2. 报错重现与修复对比
错误示例
# 示例 1:条件语句漏掉末尾冒号
age = 18
if age >= 18
    print("成年")

# 示例 2:中英文标点混用(使用了中文分号和括号)
print("Hello World")

# 终端输出反馈(示例):
# SyntaxError: expected ':'
# SyntaxError: invalid character ')' (U+FF09)
正确修复代码
# 修复 1:补全半角英文冒号
age = 18
if age >= 18:
    print("成年")

# 修复 2:统一使用英文半角括号
print("Hello World")验证技巧:在保存文件后,可以使用 Python 内置编译模块检查语法合法性:python -m py_compile script.py。若没有任何错误输出,说明代码已顺利通过语法解析检查。
三、高频报错 2:IndentationError(缩进错误)
Python 是少数依赖缩进层级来组织代码块结构的编程语言。当代码的前后缩进量不一致,或者无法与外层代码块对应时,解释器就会抛出 IndentationError。它属于 SyntaxError 的一个子类,同样在编译解析期被触发。
1. 常见诱发场景
- 意外缩进(unexpected indent):在不需要缩进的行(例如紧随无嵌套的模块最外层代码)添加了空格。
- 缩进未闭合匹配(unindent does not match any outer indentation level):内层代码向外回退缩进时,空格数量与外层代码不一致(例如外层缩进了 4 个空格,内层退回时只留了 3 个空格)。
- 空格(Space)与制表符(Tab)混用:在同一文件中部分行用 Tab 键缩进,部分行用连续空格缩进。虽然在部分文本编辑器中看起来对齐,但 Python 3 严格禁止混用并会抛出
TabError: inconsistent use of tabs and spaces in indentation。
2. 修复方案与环境配置规范
为彻底杜绝缩进错误,建议在代码编辑器中完成以下两项配置:
- 开启“显示不可见字符”(Render Whitespace):让空格显示为微小的浅色点,让 Tab 键显示为带有箭头的符号,一眼识破混用。
- 设置“Tab 转换为 4 个空格”(Insert Spaces / Tab Size = 4):按 Tab 键时编辑器自动补齐 4 个标准半角空格,符合 PEP 8 官方编码规范。
四、高频报错 3:NameError(变量或函数未定义)
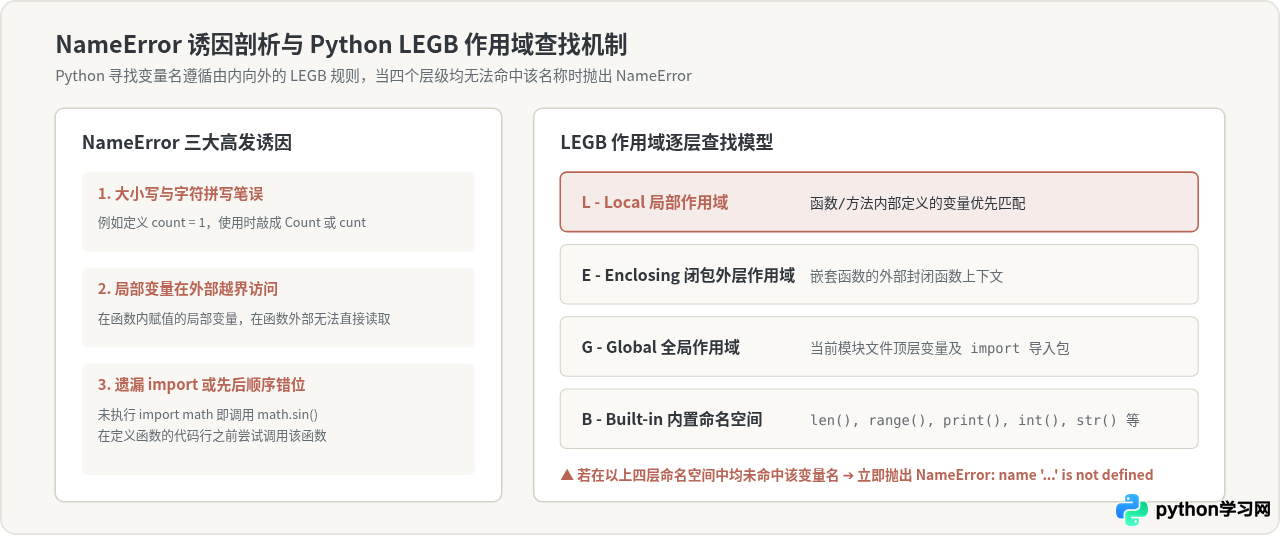
NameError 发生在运行阶段。当 Python 执行到某一语句,试图读取某个标识符(变量、函数、类或模块)所代表的值时,在当前命名空间乃至全局命名空间中都未检索到该名称,便会触发 NameError: name 'xxx' is not defined。
1. 常见诱发场景
- 拼写手误与大小写敏感:Python 对大小写极其严格。例如声明了
user_name,后续使用时误写成username或User_name。 - 先使用、后定义:在变量被赋值或函数被定义之前就尝试调用它。
- 作用域(Scope)越界访问:在函数内部定义的局部变量,试图在函数外部直接调用。
- 忘记导入模块或导入名不匹配:调用了
math.sqrt()或json.dumps(),但文件顶部遗漏了import math或import json。
2. 修复代码对比
典型错误与修复示例
# 错误示例:试图在外部访问函数内局部变量
def set_status():
    status_code = 200

set_status()
print(status_code)  # NameError: name 'status_code' is not defined

# 正确修复方案 A:通过 return 返回值传递数据
def get_status():
    status_code = 200
    return status_code

status_code = get_status()
print(status_code)  # 成功输出 200

# 正确修复方案 B:检查拼写与模块引入
import math
print(math.sqrt(16))  # 确保模块已导入,拼写与原库保持一致
五、高频报错 4:TypeError(类型不兼容与调用错误)
TypeError 表明操作符或内置函数接收到了与其预期不符的数据类型。Python 是强类型动态语言,变量本身没有固定类型,但变量指向的底层对象具有严格类型,解释器绝不会在非相容类型之间做隐式强制转换。
1. 常见诱发场景
- 字符串与数字直接用
+拼接:例如"Total: " + 100。在 Python 中,加号既表示算术加法也表示序列连接,但绝不允许str与int混合加运算。 - 对象不可调用(object is not callable):误将变量名命名为与内置函数相同的名字(例如自定义了
list = [1, 2, 3],后续尝试使用new_l = list());或者对普通变量多加了调用括号()。 - 参数数量或关键字不匹配:调用函数时少传了必填位置参数,或传参名称与函数签名不一致。
2. 典型修复示例
错误与优化对照
# 错误场景 1:类型拼接
age = 22
msg = "年龄是:" + age  # TypeError: can only concatenate str (not "int") to str

# 推荐修复:使用 f-string 格式化(Python 3.6+)
msg = f"年龄是:{age}"

# 错误场景 2:变量名覆盖内置函数
list = [10, 20, 30]    # 危险:覆盖了内置类型构造器 list
data = list((40, 50))  # TypeError: 'list' object is not callable

# 正确规范:避免与内置命名空间发生冲突
number_list = [10, 20, 30]
data = list((40, 50))  # 正常使用内置 list 构造器
六、高频报错 5:IndexError(索引越界)
IndexError 通常表现为 IndexError: list index out of range。当代码试图通过下标访问列表、元组或字符串中不存在的位置时抛出。
1. 常见诱发场景
- 混淆 0-based 计数规则:Python 序列索引从
0开始计数。一个包含 5 个元素的列表,最大有效正向索引是4。初学者常误以为最后一个是[5]。 - 空列表直接取值:当查询或数据筛选返回空列表
[]时,直接读取items[0]会立刻崩溃。 - 循环中的边界偏差(Off-by-one):使用
while或计数器遍历时,循环终止条件写成了i <= len(lst)而非i < len(lst)。
2. 防御性编程与修复策略
排查 IndexError 的核心思想是建立防御机制。在获取数据前核验长度,或使用更安全的遍历与获取方式:
items = ["苹果", "香蕉", "橙子"]

# 错误操作:越界访问
# print(items[3])  # IndexError: list index out of range

# 安全防御方案 1:取值前判空或判断长度
if items:
    print(f"第一个元素是:{items[0]}")

# 安全防御方案 2:切片操作容错(切片越界不会报错,只会返回空或截断部分)
sub_items = items[0:10]  # 返回全部 3 个元素,不会抛出 IndexError

# 安全防御方案 3:使用直接迭代替代下标索引遍历
for item in items:
    print(item)
七、总结:5 大高频报错速查与排查策略全景
掌握常见错误的关键在于把握“触发时机”与“检查重点”。以下总结表梳理了 5 类报错的排查策略,帮助开发者在遇到报错时快速形成排查回路。
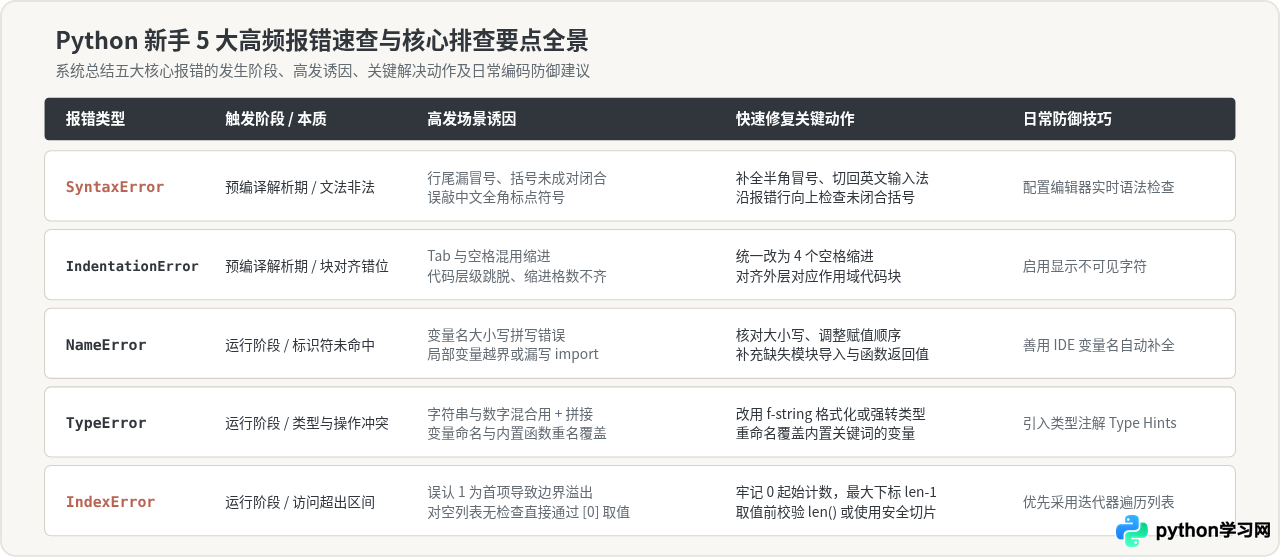
排查报错并非低效的反复试错,而是逻辑推理过程。在开发过程中遇到报错时,遵循“看末行确定异常性质 ➔ 倒序定位自身代码 ➔ 检查类型与作用域 ➔ 防御性修正验证”的四步闭环,不仅能迅速解决当下的代码阻碍,更能逐步培养出稳健规范的编码习惯。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









