

python必背源代码选择排序代码
本文提供标准Python选择排序必背源代码,深入解析算法双重循环控制、单趟极值定位与就地交换机制,结合完整数据演进追踪与复杂度分析,帮助读者快速掌握并规范编写选择排序。
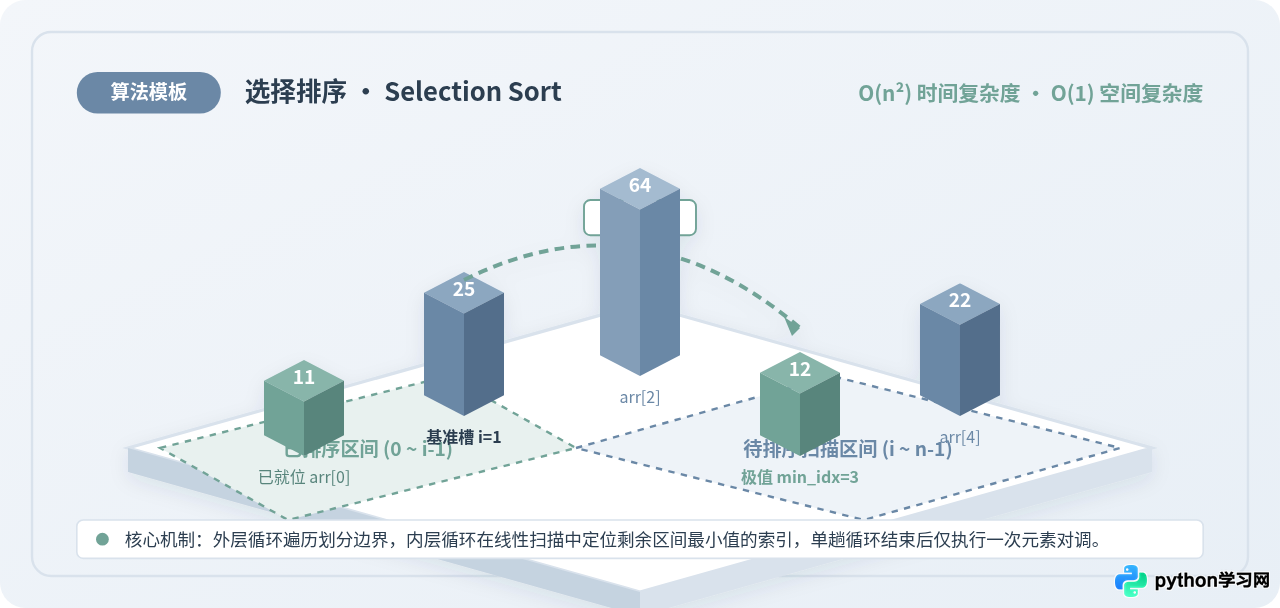
一、选择排序核心必背源代码
在各类编程考试、求职面试以及算法基础复习中,选择排序的 Python 实现强调结构紧凑、变量语义清晰、原地交换安全。以下是符合工业规范与教学考评的标准必背代码:
def selection_sort(arr):
    """
    选择排序(升序)标准实现
    :param arr: 待排序的数值列表(原地修改)
    :return: 排序后的原列表引用
    """
    n = len(arr)
    # 外层循环:控制未排序区间的起始位置 i,共进行 n - 1 轮
    for i in range(n - 1):
        min_idx = i  # 暂定当前未排序区间的首个位置为最小值索引

        # 内层循环:在剩余未排序元素中线性遍历,查找更小值的索引
        for j in range(i + 1, n):
            if arr[j] < arr[min_idx]:
                min_idx = j  # 发现更小值,仅更新索引,不进行列表元素写操作

        # 单趟扫描完全结束后,若最小值位置发生改变,则就地交换
        if min_idx != i:
            arr[i], arr[min_idx] = arr[min_idx], arr[i]

    return arr
这段代码之所以被称为“必背版”,原因在于其结构具有极高的逻辑自洽性:外层指针 i 严格定义已排序边界;内层指针 j 专职搜寻局部极值;末尾利用 Python 的元组解包特性 arr[i], arr[min_idx] = arr[min_idx], arr[i] 高效完成变量值的互换,无需申请额外临时中间变量。
二、单趟极值搜寻与就地交换的执行机制
许多初学者在背诵该算法时,容易将其与冒泡排序混淆。要彻底掌握该算法,必须看清其“单趟扫描”内部究竟发生了什么。
选择排序每一趟的目标极其纯粹:为当前目标槽位 i 寻找整个未排序区间中的最小元素。在执行过程中,算法严格划分为三个阶段:
- 基准锚定:每轮开始时,算法假定
arr[i]就是当前剩余序列里的最小值,即min_idx = i。 - 纯读扫描:内层指针
j从i + 1遍历至末尾n - 1。在此期间,算法仅进行条件读取arr[j] < arr[min_idx]。一旦条件成立,仅仅将标尺min_idx重新赋值为j,期间完全不修改数组内容。 - 单次换位:只有当内层循环彻底跑完、确认
min_idx确实找到了更小数值后,才触发一次物理对调。
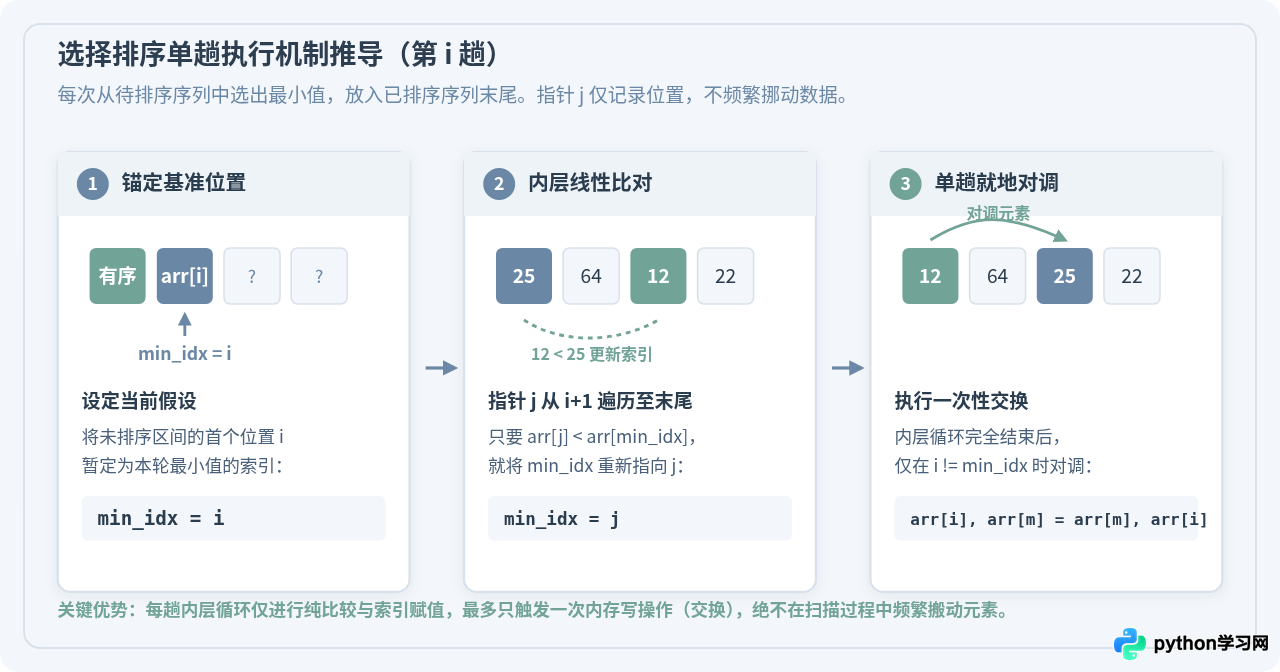
这种“只记索引、趟末才换”的机制,使得选择排序在一整趟循环中最多只发生 1 次交换。相比于冒泡排序在扫描过程中一遇到逆序就立即执行元素对调,选择排序大幅削减了内存写入动作。
三、完整排序轮次数据流转追踪
以具体列表 [64, 25, 12, 22, 11](长度 n = 5)为例,我们可以完整跟踪其 4 轮排序状态的演进细节:
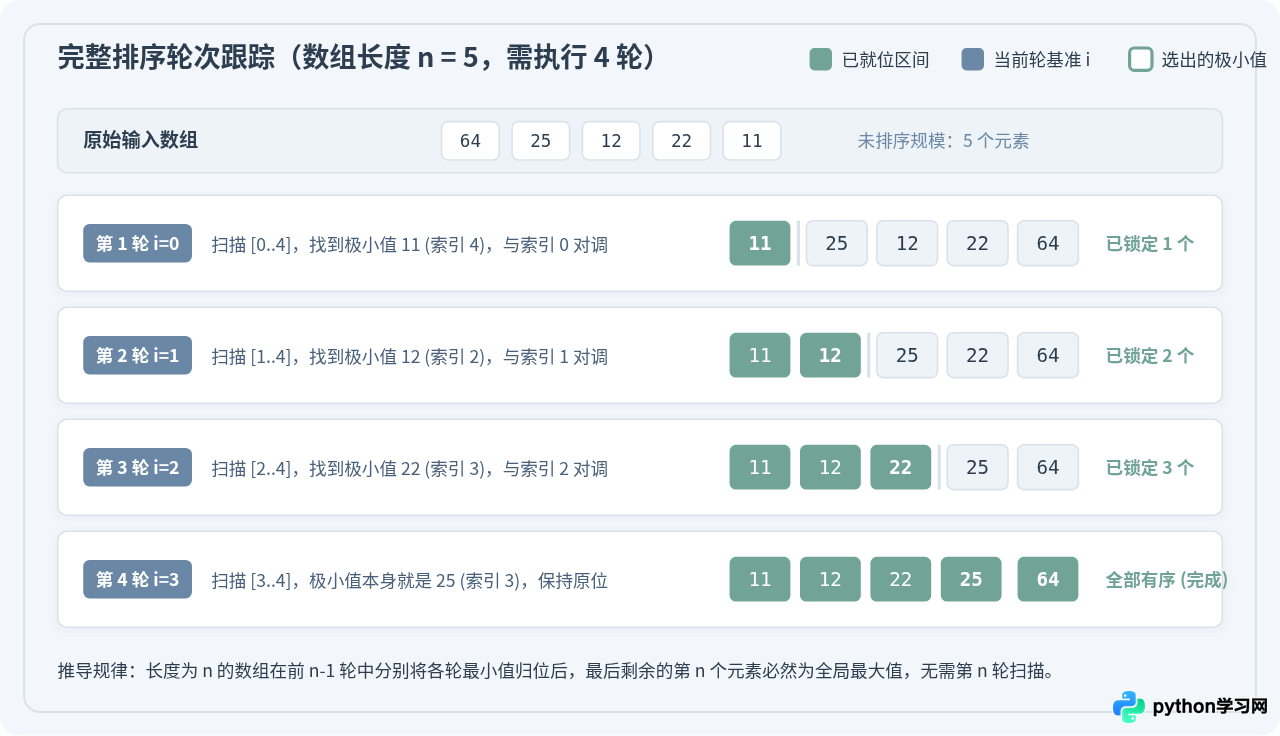
各轮详细推演过程如下:
- 第 1 轮(i = 0):未排序区间为
[64, 25, 12, 22, 11]。从 25 开始扫描,逐个比较后定位到全局最小值为 11(索引 4)。将arr[0](64)与arr[4](11)对调。此时数组变为[11 | 25, 12, 22, 64],前 1 个元素完全有序。 - 第 2 轮(i = 1):未排序区间为
[25, 12, 22, 64]。指针从 12 开始扫描,找到极小值 12(索引 2)。将arr[1](25)与arr[2](12)对调。数组变为[11, 12 | 25, 22, 64],前 2 个元素完全有序。 - 第 3 轮(i = 2):未排序区间为
[25, 22, 64]。扫描发现极小值为 22(索引 3)。将arr[2](25)与arr[3](22)对调。数组变为[11, 12, 22 | 25, 64],前 3 个元素完全有序。 - 第 4 轮(i = 3):未排序区间为
[25, 64]。扫描发现极小值本身就是 25(索引 3),min_idx == i成立,无需对调。数组变为[11, 12, 22, 25 | 64]。
因为每一轮都会将未排序区间的绝对最小值放置在当前轮次的目标槽位上。当进行完第
n - 1 轮时,前 n - 1 个元素均已严格归位,留在最后索引位置上的单丁元素必然不小于前面所有元素,因此它已经天然有序,无需再发起第 n 轮遍历。
四、双重循环结构与代码控制流映射
编写选择排序代码时,代码层级和循环上下界是决定程序能否正常运行的核心细节。
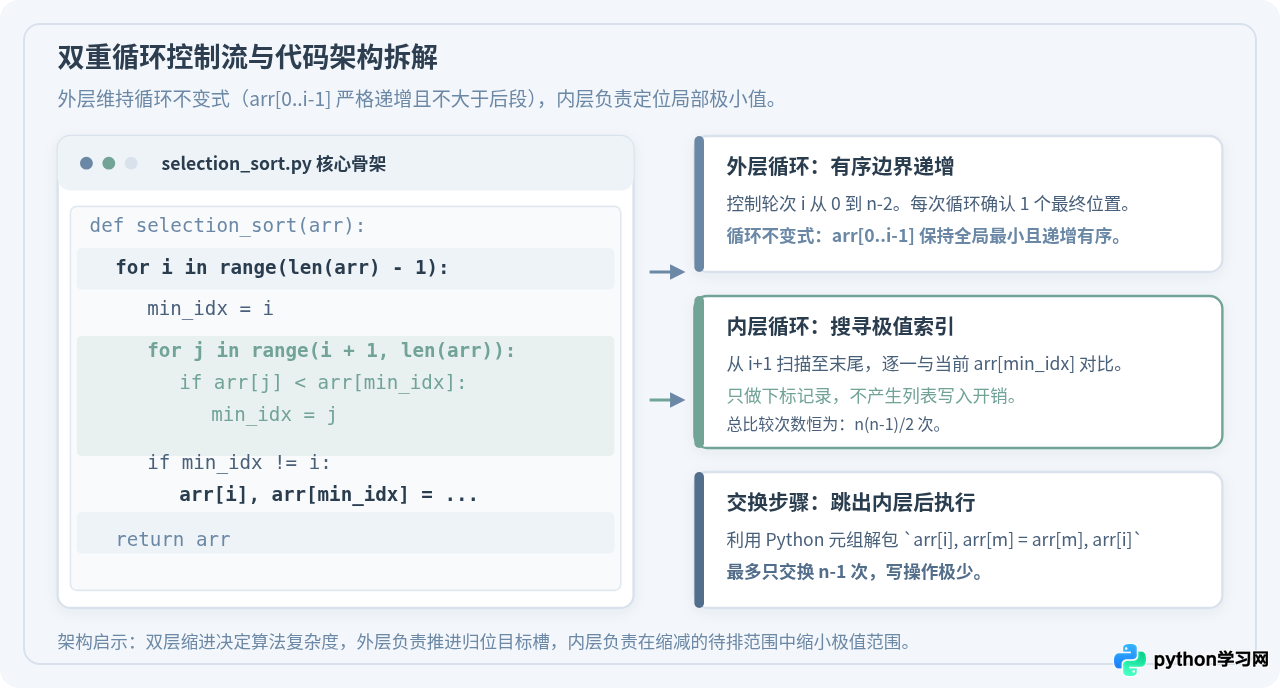
掌握以下三处边界与作用域约定,即可在手写代码时做到零失误:
- 外层循环边界为什么是
range(n - 1):如前文推导,i的取值范围是0, 1, ..., n - 2。最后剩余的 1 个元素不需要也不应该单独作为一轮起点。 - 内层循环起点为什么是
i + 1:在第i轮中,位置i上的值已经赋值给了min_idx作为初始基准,自己与自己比较毫无意义。因此扫描应该从下一个位置i + 1紧接着往后比对,避免多余计算。 - 交换语句的位置为什么在外层缩进:交换语句
arr[i], arr[min_idx] = ...必须与内层for循环对齐(处于外层循环体下),绝对不能写在内层循环内部。如果在内层循环扫描途中遇到较小值就立即交换,算法就会退化为带有冗余开销的低效交换,破坏选择排序的极值特性。
五、运行测试、性能特征与横向对比
为了验证代码的正确性,我们提供一段包含常规用例、逆序用例、含重复项用例及单元素边界的完整测试脚本:
# 执行环境:Python 3.6+ 标准解释器
if __name__ == "__main__":
    test_cases = [
        [64, 25, 12, 22, 11],        # 基础无序列表
        [5, 4, 3, 2, 1],              # 极端完全逆序
        [1, 2, 3, 4, 5],              # 已经完全有序
        [3, 1, 4, 1, 5, 9, 2, 6],        # 含有重复元素
        [42],                          # 单元素边界
        []                             # 空列表边界
    ]

    for case in test_cases:
        original = list(case)
        result = selection_sort(case)
        print(f"原数组: {original} -> 排序后: {result}")
运行结果(标为示例输出):
原数组: [64, 25, 12, 22, 11] -> 排序后: [11, 12, 22, 25, 64]
原数组: [5, 4, 3, 2, 1] -> 排序后: [1, 2, 3, 4, 5]
原数组: [1, 2, 3, 4, 5] -> 排序后: [1, 2, 3, 4, 5]
原数组: [3, 1, 4, 1, 5, 9, 2, 6] -> 排序后: [1, 1, 2, 3, 4, 5, 6, 9]
原数组: [42] -> 排序后: [42]
原数组: [] -> 排序后: []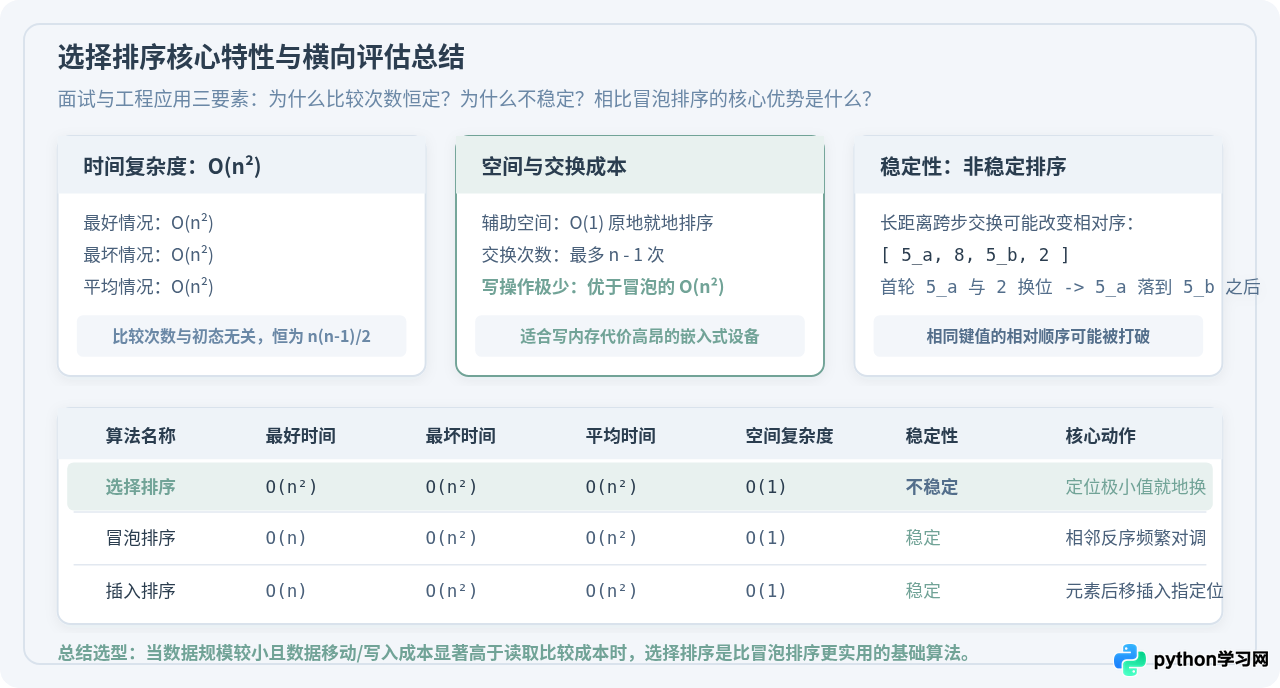
核心技术特征总结
- 时间复杂度:恒定为 O(n²):无论输入数据是完全随机、完全逆序还是已经完全有序,内层循环的比对次数都是
(n-1) + (n-2) + ... + 1 = n(n-1)/2。因此最好、最坏与平均时间复杂度均为 O(n²)。 - 空间复杂度:O(1):所有对调操作都在原列表中进行,仅需要一个额外的索引标尺变量
min_idx,属于标准的原地排序(In-place Sort)。 - 稳定性:非稳定排序(Unstable):选择排序跨越多个元素直接进行长距离交换,会破坏相同元素的相对先后次序。例如序列
[5_a, 8, 5_b, 2],第一趟5_a就会与2交换,变成[2, 8, 5_b, 5_a],导致原本在前面的5_a跑到了5_b后面。 - 适用场景:选择排序的突出优点在于数据移动次数极少(最多只有
n - 1次交换)。在闪存、EEPROM 或写操作成本极高、读取成本较低的特定嵌入式软硬件场景下,选择排序比频繁写入的冒泡排序更具实际优势。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









