

Python切片步长为0会怎么?常见逻辑陷阱与错误分析
深入解析在Python中切片步长传入0时的报错机制、底层原理、三大常见动态计算陷阱以及工业级代码中的防御性编程修复方案。
ValueError: slice step cannot be zero。Python 语言规范绝不允许切片步长为 0,因为切片的本质是按固定偏移量对指针进行递推,步长为 0 意味着位移量停滞,在数学和迭代语义上都会导致无法终止的死循环。本文直接呈现该错误发生的底层机制,拆解现实业务中最容易触发此异常的动态计算陷阱,并给出标准工业级的防御性处理方案。
1. 错误现象与底层的不可行性
无论是列表、元组、字符串,还是显式调用的 slice() 对象,只要步长取值为 0,Python 解释器就会在求值瞬间抛出异常。我们先来看一个最直观的代码片段与抛出的异常跟踪栈:
# 示例代码:直接或间接传入步长为 0
data = [10, 20, 30, 40, 50]

# 写法一:直接在切片语法中写 0
result = data[::0]

# 写法二:通过 slice 对象传参
s = slice(0, 5, 0)
result = data[s]
# 运行输出的报错信息(示例)
Traceback (most recent call last):
File "test_slice.py", line 4, in <module>
result = data[::0]
ValueError: slice step cannot be zero许多初学者会疑惑:为什么步长为 0 不能像乘法乘以 0 那样“自然返回空列表”,或者“仅返回起始位置的单个元素”?理解这一点的关键在于切片的底层索引递推公式。
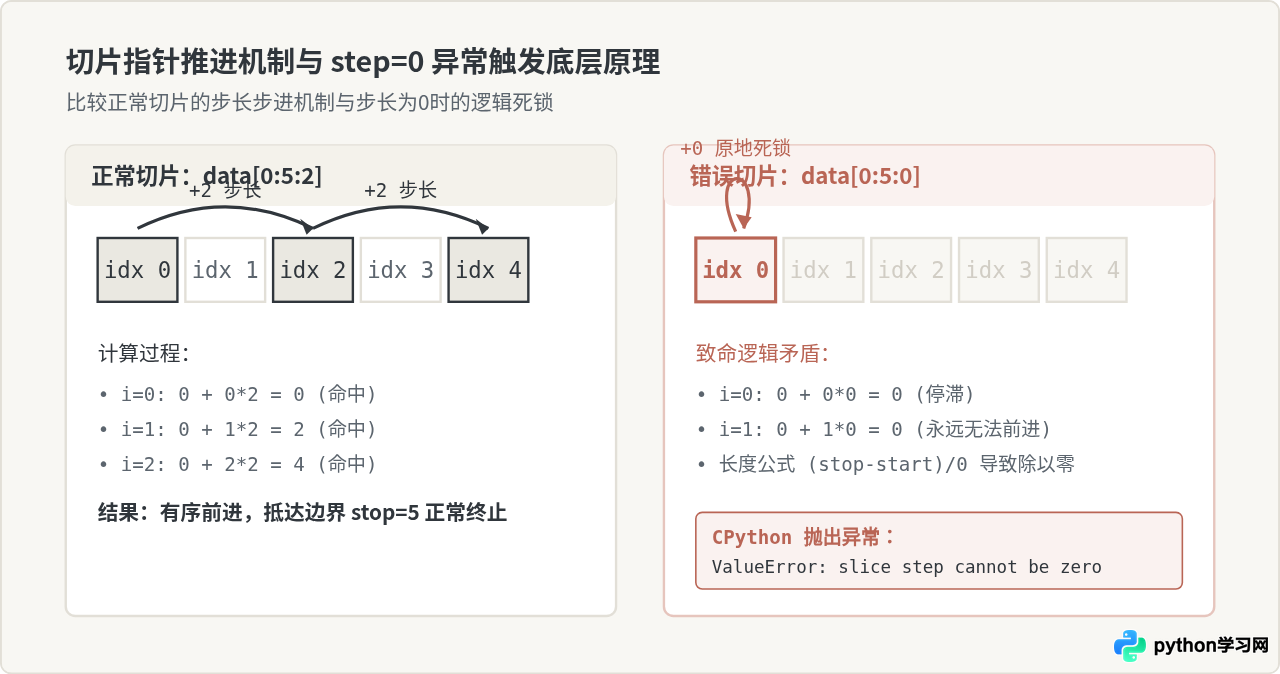
在 Python 的底层实现(CPython 的 PySlice_GetIndicesEx 函数)中,切片生成的有效索引序列定义如下:
index[i] = start + i * step (其中 i = 0, 1, 2, ...)
当 step = 0 时,对于任意非负整数 i,计算出的目标索引恒为 start。这就带来两个根本性的逻辑矛盾:第一,如果指针永远停留在起点,它永远无法到达终止边界 stop,计算切片长度的公式 (stop - start) / step 会出现零除;第二,若将其当成无限序列,切片操作必须返回离散的有限容器,这将产生无法自洽的歧义。因此,Python 官方在 C 语言层面设置了强制断言,杜绝了步长为 0 的存在。
2. 现实开发中步长为 0 的三大逻辑陷阱
在实际工程项目中,几乎没有开发者会直接硬编码写下 data[::0]。这个错误绝大多数是在变量传递、数值动态计算或类型转换过程中意外产生的。以下三类场景是产生该错误的高发区:
陷阱一:整除计算导致步长归零
在批量处理数据、数据抽样或分页计算时,我们常会根据元素总量和期望分组数动态计算步长。例如希望从序列中均匀抽取 n 个样本点:
total_count = len(dataset)      # 例如当前由于筛选,仅剩 5 条数据
target_samples = 10             # 期望抽样数量为 10
# 开发者误用整除运算
step = total_count // target_samples  # 5 // 10 结果直接归零:0

# 随后执行切片直接崩溃
sampled = dataset[::step]       # 抛出 ValueError
当除数大于被除数,或者被除数本身因过滤变成 0 时,整除操作 // 会毫无提示地输出 0,随后传递给切片引发致命异常。
陷阱二:字典获取与布尔判断默认值设置不当
在从 Web API 查询参数、配置文件或命令行选项解析步长时,若开发者误将 0 作为默认无操作的标记,就会掉入陷阱:
# 客户端未传 step,或者误传了 0
request_params = {"start": 0, "stop": 100, "step": 0}

# 逻辑假定 0 表示默认
raw_step = request_params.get("step", 0)

# 如果直接切片,未做非零重定向
sub_items = items[raw_step:]    # 若写成 items[::raw_step] 则崩溃
陷阱三:浮点比例转换与类型强制截断
在数字图像处理、音频重采样或量化交易系统中,常使用百分比或比例系数来决定跳跃采样率。int() 转型时的向零截断效应常常产生意想不到的 0:
sampling_rate = 0.08  # 采样比率低于 0.1
step = int(sampling_rate * 10)  # 0.8 经 int() 截断后变为 0

# 随后发生崩溃
sampled_frames = frames[::step]  # ValueError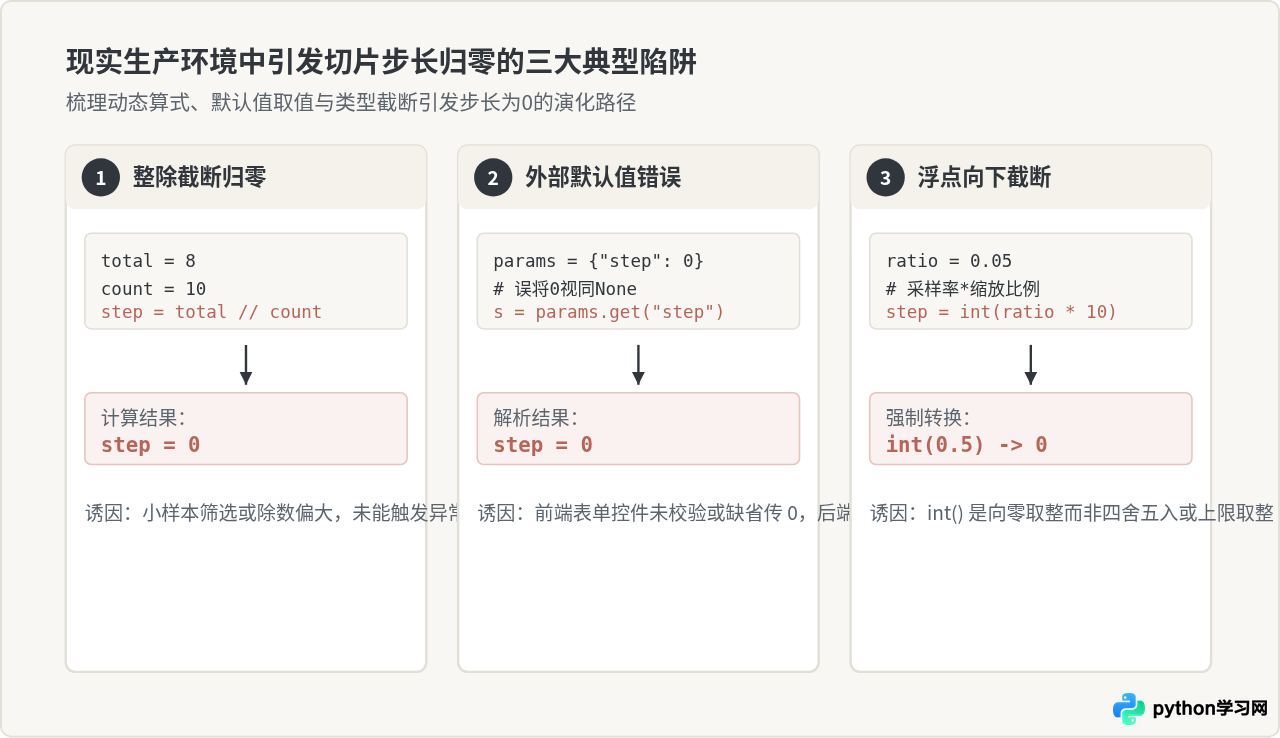
3. 第三方科学计算库(NumPy / Pandas)的表现
在数据分析和科学计算领域,许多人会好奇:高度优化的 C/Fortran 扩展库(如 NumPy 和 Pandas)是否对步长为 0 做了特殊处理?
答案是完全一致:NumPy 和 Pandas 依然严格遵循 Python 标准行为,直接抛出 ValueError,绝不容忍步长为 0。
import numpy as np
import pandas as pd

arr = np.array([1, 2, 3, 4, 5])
# NumPy 数组切片
try:
    _ = arr[::0]
except ValueError as e:
    print(f"NumPy 报错: {e}")  # 输出: slice step cannot be zero

df = pd.DataFrame({"val": [10, 20, 30]})
# Pandas 索引器 iloc
try:
    _ = df.iloc[::0]
except ValueError as e:
    print(f"Pandas 报错: {e}")  # 输出: slice step cannot be zero
这意味着在做数据处理管线时,不要抱有任何“某些库可以容忍零步长”的侥幸心理,防线必须筑在切片操作发生之前。
4. 防御性编程实践与修复策略
为了保证程序的健壮性,应对步长计算做前置校验或容错降级。以下是三种推荐的实践方案:
策略一:前置有效性断言与显式拦截
如果切片步长为 0 属于严重业务异常(例如说明传入的数据结构已被破坏或参数非法),应当第一时间主动拦截并抛出语义更明确的业务异常,而不是等待底层抛出通用的 ValueError:
def sample_records(records, raw_step):
    if raw_step == 0:
        raise ValueError("采样步长不可为0,请检查数据筛选条件与抽样配置")
    return records[::raw_step]
策略二:安全回退降级(设置保底步长)
在数据展示或非关键采样的场景下,若允许容错,可设置保底步长为 1,或者向上取整:
import math

# 方案 A:针对除法计算,采用向上取整保底为 1
safe_step = max(1, math.ceil(total_count / target_samples))

# 方案 B:显式判断 0 并回退
safe_step = 1 if calculated_step == 0 else calculated_step

# 切片安全执行
result = dataset[::safe_step]step = raw_step or 1 处理负步长!虽然
0 or 1 的结果是 1,能够把 0 变成 1,但如果业务本身允许反向切片(例如步长为 -1 或负数),由于非零负数在布尔上下文中为真,(-1) or 1 依然为 -1,看似没问题;但在某些重置逻辑中容易混淆含义。建议始终使用显式的 if step == 0 判定,保持代码意图清晰。
策略三:封装通用安全切片工具函数
对于复杂项目,可将切片逻辑封装为纯函数,统一边界与容错处理:
def safe_slice(sequence, start=None, stop=None, step=None, fallback_step=1):
    """
    对序列进行安全切片,当 step 为 0 时自动降级为 fallback_step
    """
    if step == 0:
        step = fallback_step
    return sequence[start:stop:step]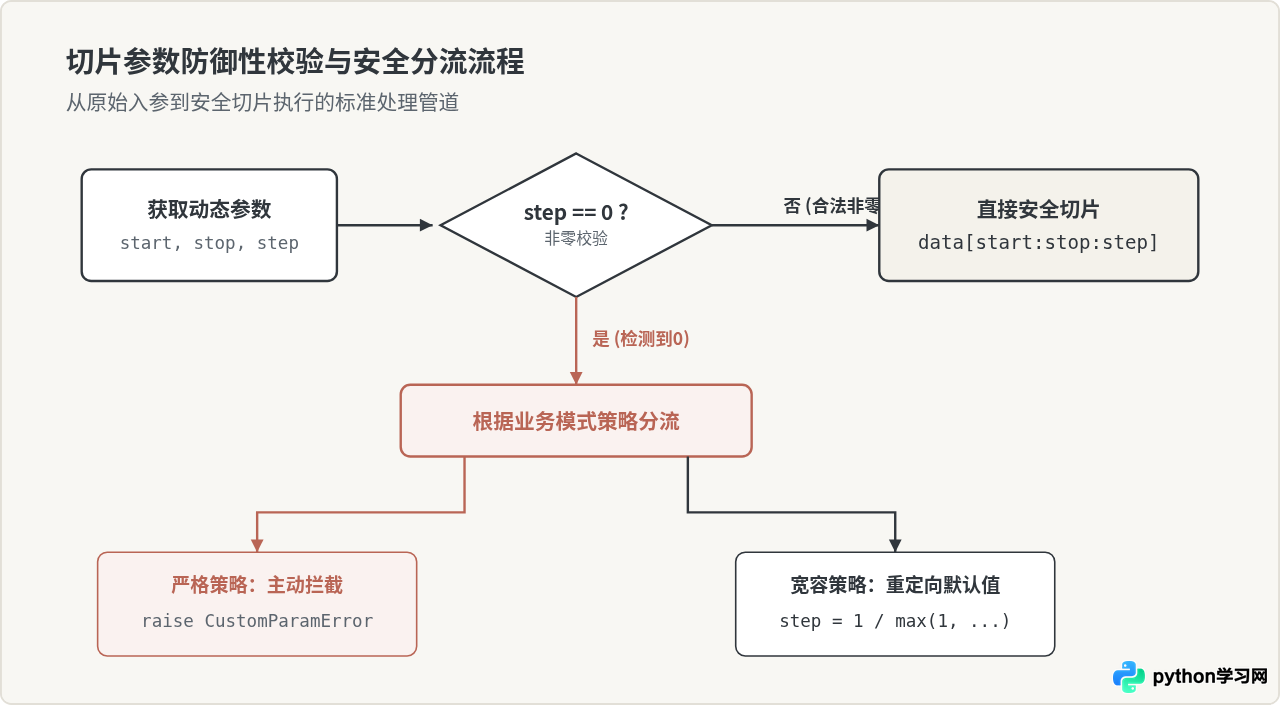
5. 切片边界与特殊参数行为速查
在 Python 语法中,切片操作对越界索引和不同步长有着极其宽容却又边界鲜明的规则。为了在日常编码中建立清晰的心智模型,以下对各类切片参数的实际行为做汇总对比:
| 切片表达式 | 参数行为特征 | 返回值 / 执行效果 | 是否抛出异常 |
|---|---|---|---|
data[::0] |
步长明确赋值为 0 | 直接中断 | 是 (ValueError) |
data[::None] 或 data[:] |
步长省略或传入 None | 等价于 step=1,逐项遍历完整复制 | 否 |
data[::-1] |
负步长 | 逆序切片,反转整个序列 | 否 |
data[2:2] |
起点与终点相等 (start == stop) | 返回空容器 [] |
否 |
data[100:200] |
索引大幅超出序列真实长度 | 自动截断,返回空容器 [] |
否 (自动容错截断) |
data[5:2:1] |
正步长但起点大于终点 | 不满足推进条件,返回空容器 [] |
否 |
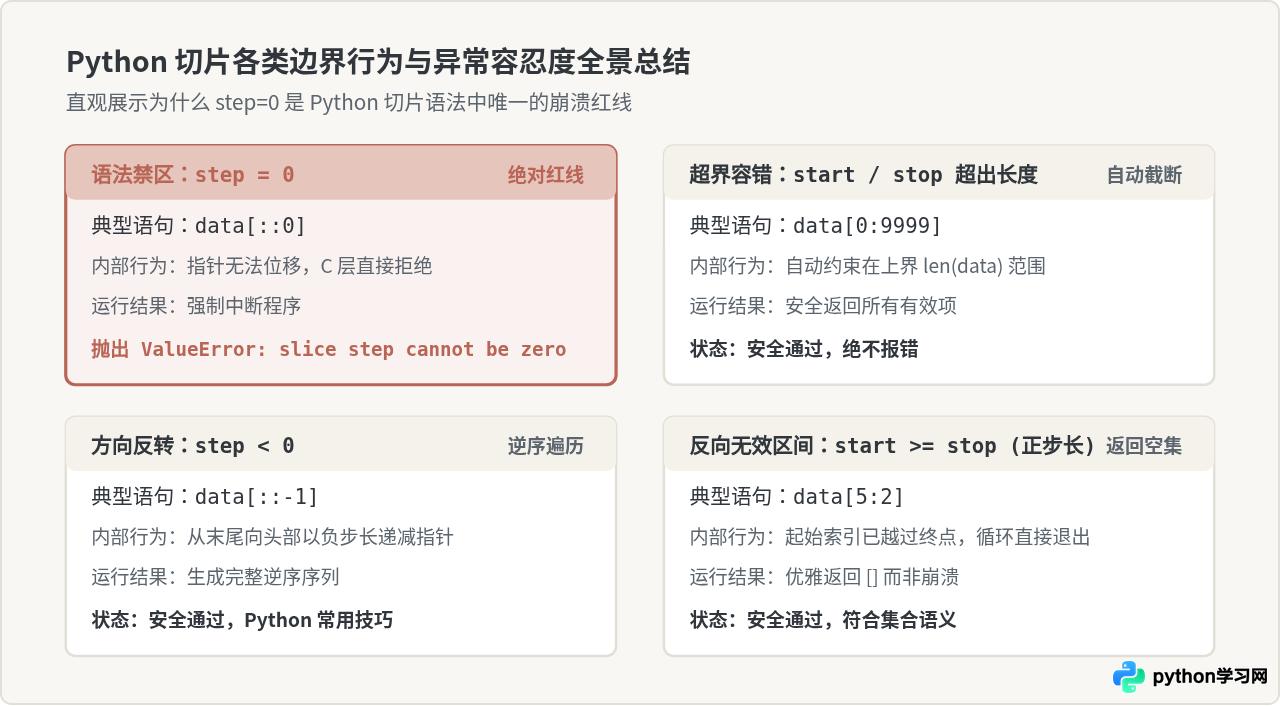
总结
在 Python 的设计哲学中,切片机制表现出极高的宽容度:无论是索引越界、反向逆序,还是区间重叠,解释器都能通过自动截断或返回空列表实现静默容错。唯独在步长为 0 这件事上,Python 选择了零容忍——直接抛出 ValueError: slice step cannot be zero。
只要牢记其底层的离散位移原理,并在可能产生动态步长的算式中做好非零校验、向上取整或兜底重定向,就能彻底杜绝此类隐蔽崩溃,编写出高稳定性的 Python 代码。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









