

Python中用in运算符还是index()判断元素存在更合适

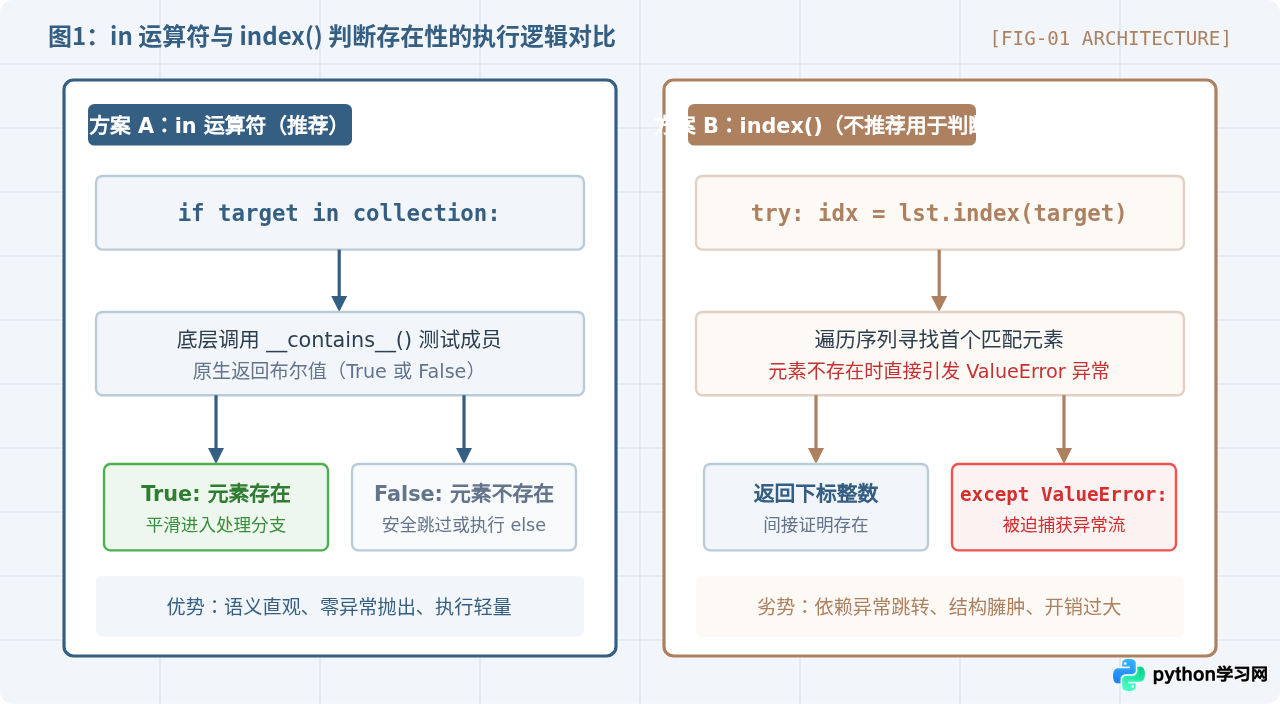
在 Python 中判断一个元素是否存在于容器中,使用 in 运算符是绝大多数场景下的最佳选择。in 运算符专门用于成员隶属测试,返回直观的布尔值 True 或 False,语法贴合自然语言、意图明确,且适用于列表、元组、集合、字典及字符串等各类容器。相比之下,index() 方法的核心职责是“定位元素的首个索引下标”,当元素不存在时会直接抛出 ValueError 异常;若用它来判断存在性,必须使用额外的 try...except 结构进行防御性捕获,无论在可读性、控制流设计还是执行开销上都明显劣于 in。
一、核心差异对比与快速决策依据
为了直观展现两种方式在语法特性、错误处理和适用边界上的差别,下表汇总了核心维度的关键特征:
| 比较维度 | in 运算符 |
index() 方法 |
|---|---|---|
| 设计目的 | 成员隶属测试(判断是否存在) | 元素检索定位(获取首次出现的索引下标) |
| 返回值类型 | bool(True 或 False) |
int(下标数值) |
| 元素不存在时的行为 | 平滑返回 False,无异常 |
直接引发 ValueError 异常 |
| 容器支持范围 | 列表、元组、集合、字典键、字符串等 | 仅支持列表(list)、元组(tuple)、字符串(str)等有序序列 |
| 用于存在性判断的代码复杂度 | 极低,一行 if item in container: |
较高,需包裹 try...except ValueError: |
| 综合推荐指数 | ★★★★★(判断存在性的官方与社区标准方式) | ★☆☆☆☆(仅用于确实需要获取下标的场景) |
二、in 运算符的运作机制与核心优势
in 是 Python 语言内置的成员测试运算符(Membership Operator),其语法结构直接反映了程序员的业务意图。在具体执行时,in 具有以下关键优势:
1. 语义贴合、易于维护
代码应当具备良好的自解释性。使用 if target in users: 能够清晰表达“若用户存在则执行”的意图;而使用 index() 进行判断则将简单的是非问题复杂化,增加了后续维护者的理解成本。
# 示例:使用 in 进行成员存在性判断
fruits = ["apple", "banana", "orange", "grape"]
target = "banana"

# 优雅且地道的 Pythonic 写法
if target in fruits:
    print(f"成功找到水果:{target}")
else:
    print(f"列表中未找到:{target}")
2. 广泛兼容各类容器类型
in 运算符不仅能在列表(list)和元组(tuple)中使用,在集合(set)、字典(dict)乃至生成器和自定义对象中同样通用:
- 字典查找:
key in my_dict会高效校验字典键是否存在。 - 集合查找:
item in my_set能够充分利用哈希表加速。 - 字符串匹配:
"py" in "python"用于子串的包含性校验。
三、容器底层检索机制与时间复杂度分析
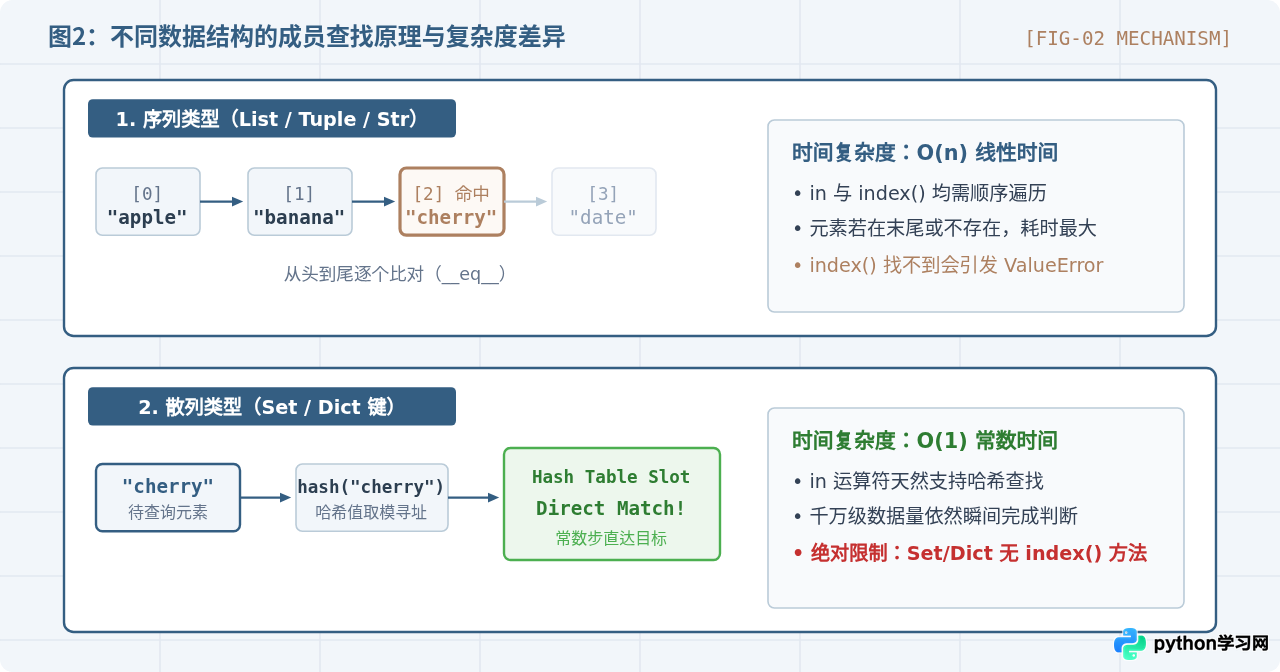
了解数据结构的底层实现,有助于更清楚地认识 in 与 index() 在性能上的异同。无论是 in 还是 index(),在序列容器(如 list)中寻找元素时,底层都必须从头部开始按顺序向后逐项扫描,直到找到目标或遍历结束。因此,它们在列表上的最坏时间复杂度均为 $O(n)$。
然而,当业务场景对检索性能有严苛要求时,in 展现出了 index() 完全不具备的扩展能力:我们可以将列表转化为集合(set)或字典(dict),将时间复杂度从 $O(n)$ 直接降为 $O(1)$。集合和字典并没有 index() 方法,因此如果代码强依赖 index(),将无法直接平滑迁移到高性能哈希结构中。
四、为什么不建议用 index() 来判断元素存在
部分初学者由于其他编程语言(如 JavaScript 中的 indexOf 或 C# 中的 IndexOf)的使用惯性,误以为 Python 的 index() 在找不到元素时也会返回 -1,进而写出类似 if lst.index(x) != -1: 的逻辑。这在 Python 中会导致严重的程序崩溃。
lst.index(x) 且 x 不在 lst 中时,解释器会立即抛出 ValueError: '...' is not in list,而不是返回特殊错误码。
如果坚持使用 index() 来判断存在性,就必须采用异常捕获机制:
# 反面示例:使用 index() 和异常捕获来判断存在性
items = ["alpha", "beta", "gamma"]
target = "delta"

# 这种写法代码繁琐,且破坏了正常的控制流
try:
    pos = items.index(target)
    exists = True
except ValueError:
    exists = False

if exists:
    print("元素存在")
else:
    print("元素不存在")
这种做法存在两个显著弊端:
- 异常处理的高额运行时开销:在 Python 中,构造异常对象、记录回溯栈帧(Traceback)以及进行异常分发是相对耗时的操作。如果在循环或高频接口中使用异常处理不存在的情况,会使性能下降数倍。
- 违背 Python 规范与可读性原则:Python 哲学强调“简单优于复杂”。一个纯粹的布尔值逻辑判断,完全没有必要将其包裹为 try/except 结构。
五、既需判断存在又需获取索引时的正确做法
在实际编码中,读者常常会遇到“如果元素存在,则需要获取其下标进行后续操作”的复合需求。针对这一场景,不能盲目套用单一逻辑,而应根据代码规模与概率分布选择合适的操作方式。
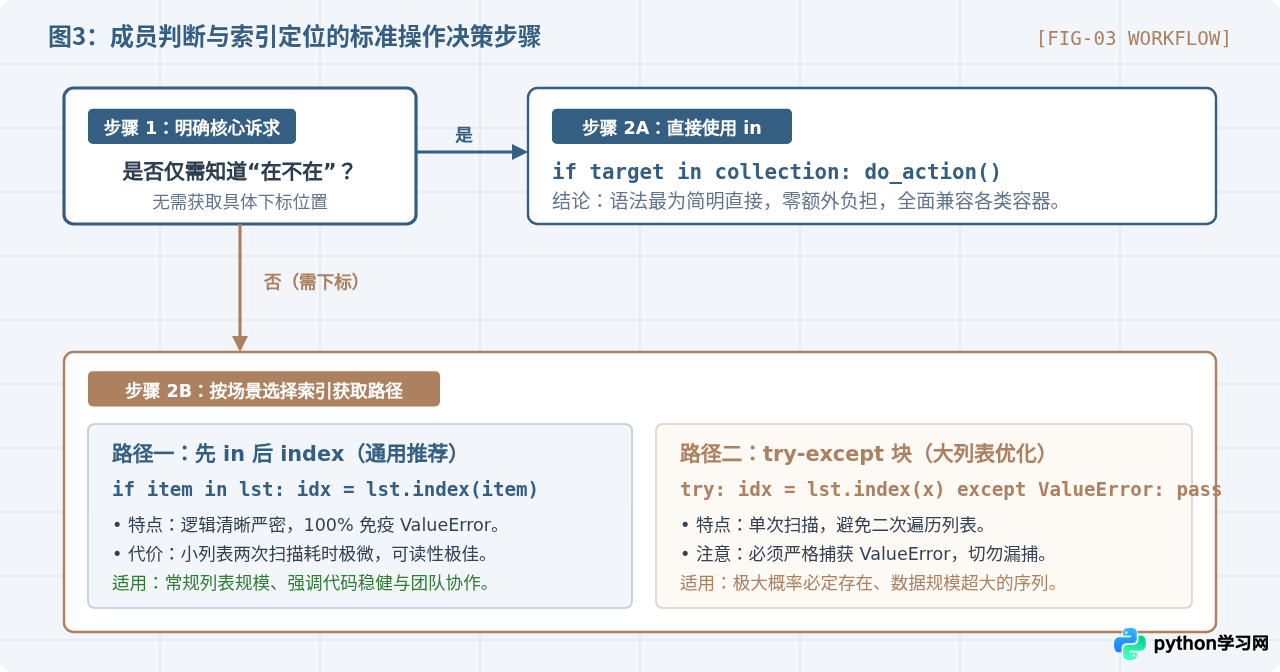
方法 1:先用 in 守卫,再调用 index()(推荐写法)
对于常规规模的列表,先通过 in 确保元素存在,然后再安全调用 index(),是绝大多数业务逻辑的最佳平衡方案:
elements = ["log_1", "log_2", "log_3"]
key = "log_2"

# 先用 in 守卫,100% 杜绝 ValueError 异常抛出
if key in elements:
    position = elements.index(key)
    print(f"元素在索引 {position} 处")
else:
    print("未找到该元素")
虽然该方案在最坏情况下会进行两次顺序扫描,但在列表规模通常在成百上千项以内时,其纳秒级的耗时完全可以忽略,而换来的则是清晰无异常跳转的结构。
方法 2:大序列且极大概率存在时的 try-except 优化
如果列表包含百万级项,且根据业务特征该元素有 99% 以上的概率存在,为了避免两次遍历带来的双倍线性耗时,可以直接调用 index() 并显式捕获 ValueError:
# 针对大列表的单次遍历优化方案
try:
    position = large_list.index(target_item)
    handle_found(position)
except ValueError:
handle_not_found()此方案的核心前提是“绝大多数情况下不会抛出异常”,这样才能保证高效的单次线性扫描红利不会被异常堆栈的开销抵消。
方法 3:在遍历中同步获取索引
如果原本就需要遍历整个列表进行处理,建议直接借助内置函数 enumerate(),在循环中一步完成元素匹配与索引提取:
tasks = ["download", "parse", "clean", "save"]
target_task = "clean"

found_idx = None
for idx, task in enumerate(tasks):
    if task == target_task:
        found_idx = idx
        break

if found_idx is not None:
    print(f"找到任务,下标为:{found_idx}")
六、常见注意事项与避坑指南
- 字符串的特殊方法 find():字符串类型拥有专有的
str.find(sub)方法,当子串不存在时会返回-1。但在单纯判断“子串是否存在”时,if "abc" in text:依然比if text.find("abc") != -1:更加简洁直观。 - 对象等值比较机制(
__eq__):不管是in还是index(),底层都依赖对象的等值比较。如果列表中存放的是自定义类实例,必须确保类内部正确实现了__eq__方法,否则比对将退化为对象的内存地址比较(身份比较)。 - 浮点数比对陷阱:列表中若包含浮点数,由于 IEEE 754 精度误差,
0.1 + 0.2 in [0.3]的结果为False。在涉及浮点数时应改用math.isclose()进行容差遍历判断。
七、决策总结与全景矩阵
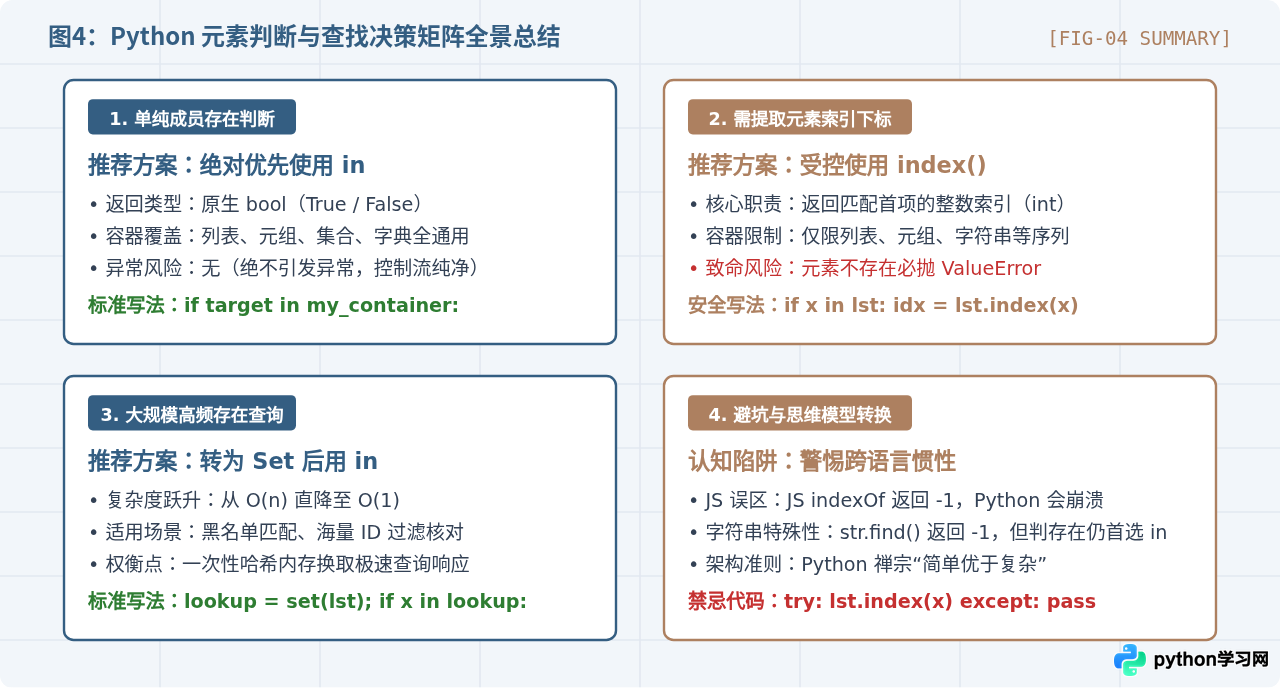
in 运算符;只有在业务逻辑“必须取得该元素的下标位置”时,才去调用 index() 或 enumerate(),并且在调用 index() 时必须搭配 in 守卫或精准的 ValueError 异常捕获以确保程序健壮运行。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









