

Python find与index在字符串定位截取中的区别及异常处理

在 Python 字符串处理中,定位特定子串并以此为基准进行切片截取是极为高频的基础操作。str.find() 与 str.index() 都能精确返回目标子串首次出现的起始索引,参数签名也完全一致,二者的根本差异在于未找到目标子串时的响应行为:find() 默认返回整数 -1,而 index() 则会直接抛出 ValueError 异常。这一返回值层面的机制分歧,直接决定了后续截取操作的代码结构、安全性边界以及异常处理策略。
一、核心机制与设计初衷对照
两个方法在语法形式上均接收三个参数:str.find(sub[, start[, end]]) 和 str.index(sub[, start[, end]])。其中 sub 为待查找子串,可选的 start 与 end 用于限定搜索区间。当目标子串存在时,二者返回值毫无二致;但当目标子串缺失时,二者体现了截然不同的设计哲学:
find()的哨兵值设计:属于宽松型查找,返回-1作为未匹配的“哨兵标识”。它假设未匹配可能是常态业务情况,把后续控制流的判断权交给显式的数值比较。index()的快速失败设计:属于契约型查找,抛出ValueError: substring not found。它遵循 Python 的快速失败(Fail-Fast)原则,假定目标应当存在,若缺失则属于数据异常或契约破坏,必须通过异常机制中断或转入专属分支。
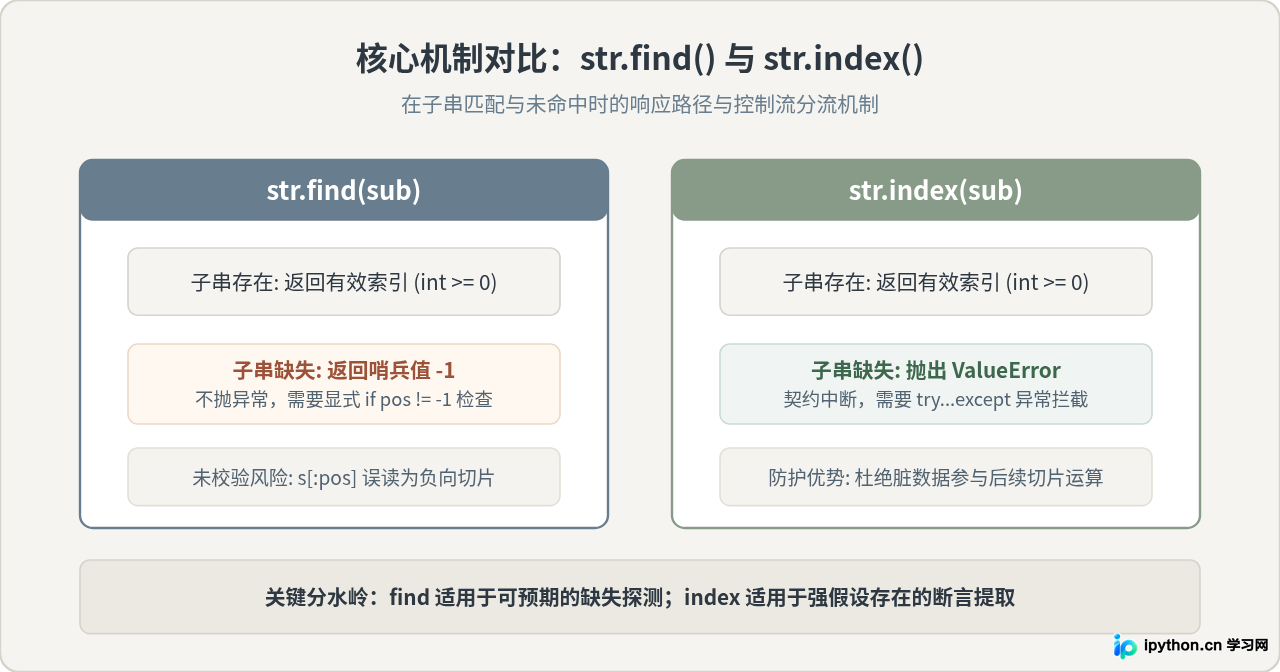
二、字符串定位截取中的致命隐患:负索引切片陷阱
在编写提取逻辑时,开发者往往需要找到分隔符位置,并切取分隔符之前或之后的内容。例如从 "filename.tar.gz" 或键值对 "user_id:9527" 中截取前缀。
若误用 find() 且省略有效性检查,直接将返回结果带入切片语法,会引发严重的静默数据截断 Bug。在 Python 切片规则中,-1 并不代表“切片无效”,而是被解析为“倒数第一个元素”。
# 演示环境:Python 3.8+ 交互式终端
raw_data = "article_content_without_delimiter"

# 预期目标:截取冒号 ':' 之前的内容
pos = raw_data.find(":")  # 结果为 -1

# 致命错误:直接切片
result = raw_data[:pos]

# 示例输出:
# 'article_content_without_delimite'(末尾的 'r' 被静默剔除!)当 find() 未匹配到冒号时返回 -1,raw_data[:-1] 将截取除最后一个字符外的全部内容。系统不会产生任何报错日志,但输出的数据已发生损坏。此类缺陷在测试阶段不易察觉,进入生产环境后极难排查。
反观 index(),当传入相同的未命中字符串时,程序会立即中断:
# 使用 index() 时的表现
pos = raw_data.index(":")

# 示例输出(标准错误):
# Traceback (most recent call last):
#   File "<stdin>", line 1, in <module>
# ValueError: substring not found
虽然中断导致程序停摆,但这构成了典型的“快速失败”:它阻止了错误数据被进一步写入数据库或下游流水线。
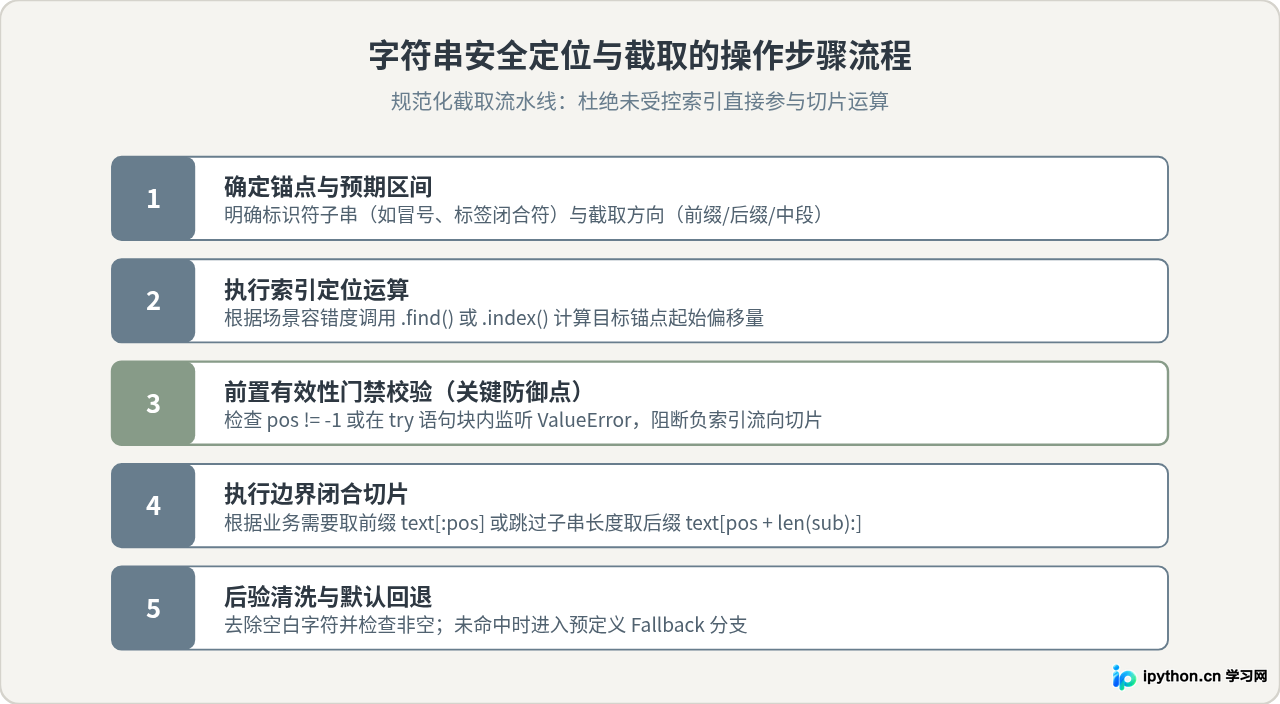
三、定位截取的操作流程与规范步骤
为了保证截取操作兼具稳健性与正确性,规范的定位截取应严格遵循“定位、校验、切片、后验”四步操作流:
四、两套典型的异常防御编码模式
在工程实践中,根据数据来源与业务契约的不同,通常采用以下两套截然不同的防御模式。
模式 1:find() 的显式守卫分支(针对非严格数据)
当待解析的字符串允许不包含分隔符,且缺失分隔符属于业务逻辑中的一种可能分支时,推荐使用 find() 配合显式 != -1 守卫:
def extract_domain_prefix(url_text: str) -> str:
    """提取协议前缀,如 'https://example.com' 提取 'https'。
    若无协议前缀,返回空字符串。
    """
    delimiter = "://"
    pos = url_text.find(delimiter)

    # 显式守卫:严格拦截 -1
    if pos != -1:
        return url_text[:pos]

    # 未匹配时的正常业务回退
    return ""

# 测试示例
print(extract_domain_prefix("https://example.com"))  # 示例输出: 'https'
print(extract_domain_prefix("ftp://files.org"))       # 示例输出: 'ftp'
print(extract_domain_prefix("example.com/index.html")) # 示例输出: ''
模式 2:index() 的结构化异常捕获(针对契约化数据)
当字符串格式受到协议或结构规范严格约束(如标准日志格式、固定协议包头)时,分隔符必须存在。此时使用 index() 配合 try...except ValueError 能够保持主业务逻辑的流畅度,并在数据破损时统一归集异常:
def parse_log_timestamp(log_line: str) -> str:
    """从形如 '[2026-10-09 14:00:00] INFO: payload' 中截取时间戳。
    缺失方括号被视作脏数据或协议违规。
    """
    try:
        start_idx = log_line.index("[") + 1
        end_idx = log_line.index("]", start_idx)
        return log_line[start_idx:end_idx]
    except ValueError as exc:
        # 捕获缺失引起的结构破损,避免脏数据静默流转
        raise KeyError(f"日志条目缺失标准时间戳定界符: {log_line!r}") from exc

# 测试示例
valid_line = "[2026-10-09 14:00:00] System ready."
print(parse_log_timestamp(valid_line))  # 示例输出: '2026-10-09 14:00:00'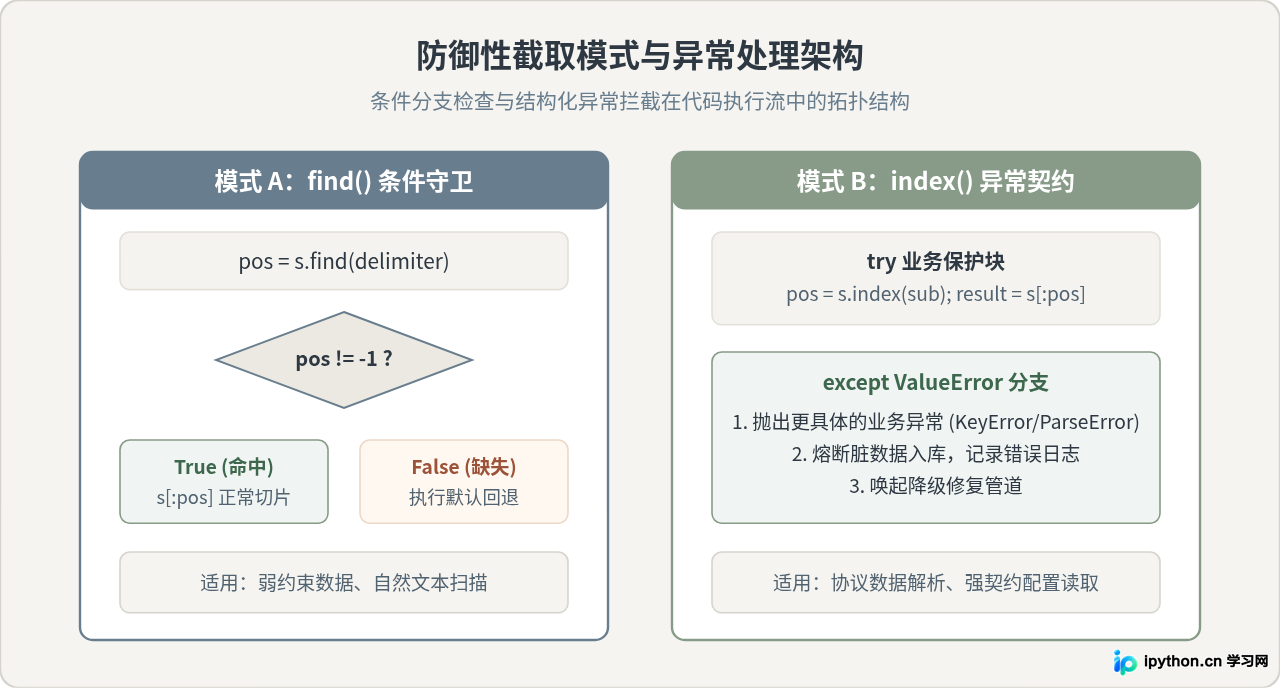
五、性能考量与替代方案(partition / split)
在性能层面,find() 与 index() 在底层均由 CPython 的快速字符串匹配算法(类似 Boyer-Moore-Horspool 变种)实现。在成功命中的情况下,两者的耗时几乎完全一致。
当面临大量未命中场景时:
- 频繁触发
index()的ValueError异常会带来显著的异常栈创建与栈回溯开销。如果业务预期有超过 20% 的请求无法命中,find()的条件判断在性能上明显占优。 - 如果未命中概率极低(小于 1%),采用
index()的try...except结构不仅语义更精准,而且在正常路径下完全没有if分支判断开销(遵循 EAFP 原则:请求原谅比请求许可更容易)。
更安全的截取替代:str.partition()
如果业务目的仅仅是“根据单个分隔符切分前后两部分”,Python 提供了语义更高层且天生免除索引越界风险的内置方法 str.partition(sep):
# str.partition() 会固定返回包含 3 个元素的三元元组:(head, sep, tail)
text = "archive.2026.log"

head, sep, tail = text.partition(".")
# 命中时: head='archive', sep='.', tail='2026.log'

# 当未匹配到分隔符时:
head, sep, tail = "standalone_text".partition(".")
# 未命中时: head='standalone_text', sep='', tail=''
使用 partition() 能够直接规避手动计算切片索引与加减偏移量的琐碎工作,是单分隔符二分截取场景的首选工具。
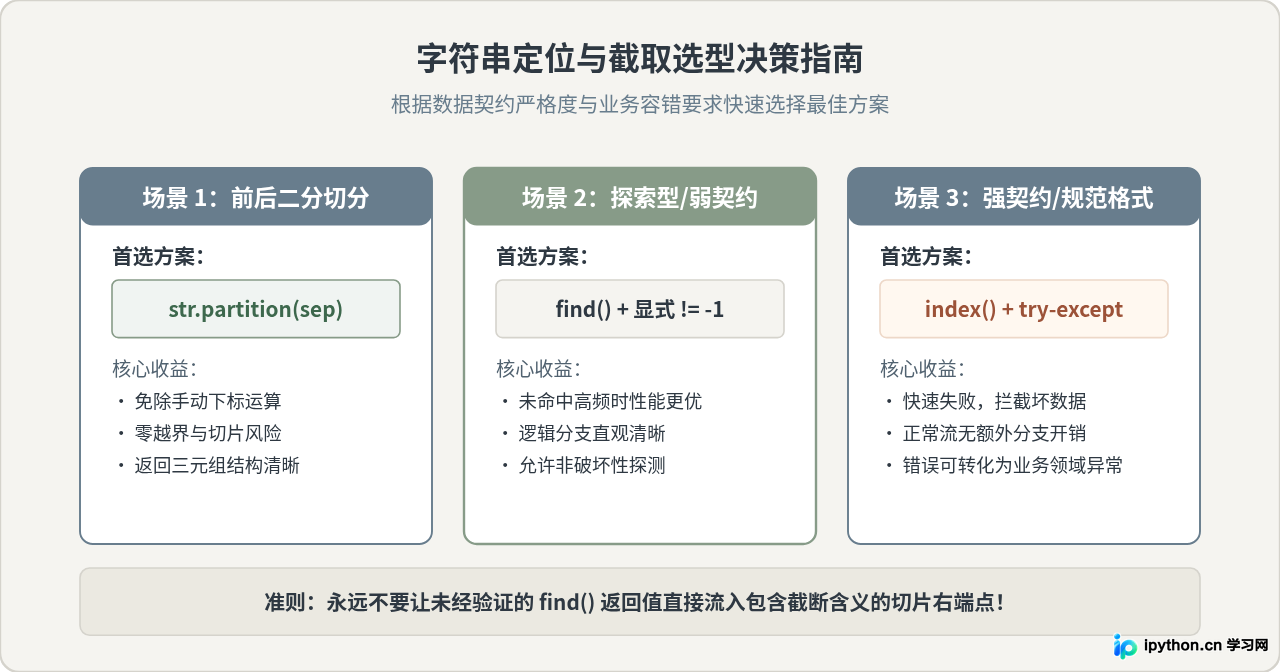
六、场景选型总结与决策指南
为了帮助开发者在不同业务场景中做出清晰的技术选型,下表归纳了两种方法与替代方案的核心指标:
| 方法 | 未命中响应 | 直接切片风险 | 代码风格推荐 | 典型适用场景 |
|---|---|---|---|---|
str.find() |
返回 -1 |
极高(触发负向切片,静默丢失末字符) | LBYL(显式检查 != -1) |
自然语言模糊查找、搜索关键字高亮探测 |
str.index() |
抛出 ValueError |
无(中断执行,无法进入切片) | EAFP(try...except 拦截) |
结构化报文解析、协议帧解包、配置键值对提取 |
str.partition() |
返回 (s, '', '') |
零(无需索引运算) | 结构解构模式 | 单字符/单单词定界截取前后缀 |
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









