

Python列表与字典合并:extend、update及解包操作详解
深入详解Python中列表与字典的合并操作,全面对比extend、update、加号、星号解包以及Python 3.9合并运算符的机制、原地修改与新对象生成的差异及避坑要点。
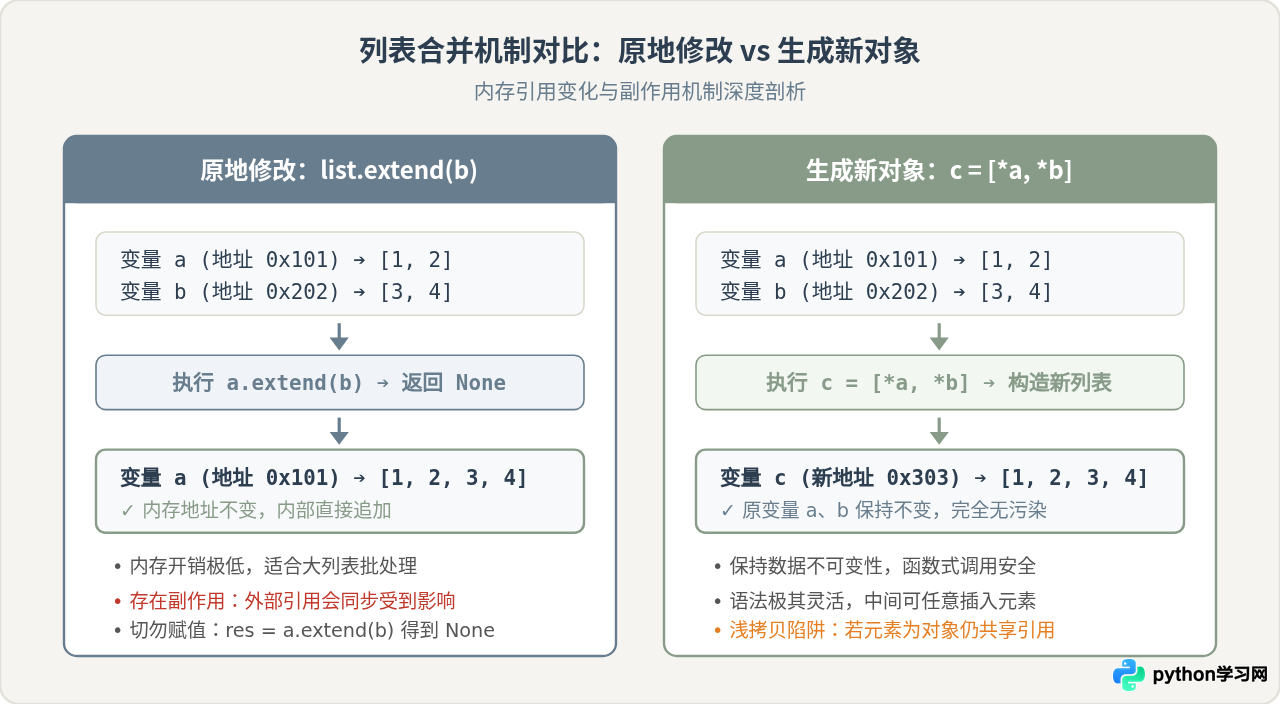
在 Python 日常开发中,集合类数据的合并是最高频的基础操作之一。合并的核心分水岭在于处理模式的差异:是“原地修改已有对象”,还是“构建并返回一个全新对象”。列表主要依赖 extend() 方法实现就地扩充,或通过加号 + 与单星号解包 [*a, *b] 生成新列表;字典则主要依托 update() 原地更新键值,或采用双星号解包 {**d1, **d2} 以及 Python 3.9 引入的合并运算符 | 产生新字典。掌握这两种机制不仅关乎语法书写,更是避免隐式副作用、浅拷贝陷阱及内存损耗的关键。
一、列表合并的核心方式与行为特征
列表作为有序且可变的序列容器,合并的核心需求通常包含两类场景:一是需要直接向现有列表中追加批量数据以复用原有内存引用;二是不破坏参与合并的原始列表,派生出一份独立的完整数据。
1. 原地扩展:list.extend()
extend() 是 Python 列表的内置方法。它接收一个可迭代对象(如列表、元组、集合或生成器),逐个解包其内部元素并直接追加到调用列表的尾部。
# 示例:使用 extend 原地合并列表与元组
fruits = ["apple", "banana"]
more_fruits = ("cherry", "date")

# 直接在 fruits 原对象上追加
fruits.extend(more_fruits)

print("fruits 内容:", fruits)fruits 内容: ['apple', 'banana', 'cherry', 'date']
注意要点:extend() 的执行属于纯就地修改,其方法返回值为 None。初学者常犯将结果重新赋值的错误,例如写成 fruits = fruits.extend(more_fruits),这会导致 fruits 变量意外变为 None 并丢失原列表。
2. 运算符拼接:加号 +
使用加号 + 进行合并属于表达式求值。它的两端必须严格都是列表类型(传入元组或集合会抛出 TypeError),运算结果是一个由解释器全新分配的列表对象。
# 示例:使用加号生成新列表
base_ids = [101, 102]
extra_ids = [201, 202]

combined_ids = base_ids + extra_ids

print("combined_ids:", combined_ids)
print("base_ids 是否未受影响:", base_ids == [101, 102])combined_ids: [101, 102, 201, 202]
base_ids 是否未受影响: True
3. 序列解包:[*list1, *list2]
从 Python 3.5 起,解包泛化允许在列表字面量中直接使用单星号 * 进行展开。相比加号拼接,解包操作的自由度更高,不仅能够同时解包列表、元组、集合与迭代器,还允许在解包过程中灵活插入常量元素。
# 示例:灵活的单星号解包
primary_ranks = [1, 2, 3]
secondary_ranks = (4, 5)

# 在解包中直接穿插离散值与不同类型的可迭代对象
all_ranks = [0, *primary_ranks, 99, *secondary_ranks]

print("all_ranks:", all_ranks)all_ranks: [0, 1, 2, 3, 99, 4, 5]
二、字典合并机制与键冲突覆盖原则
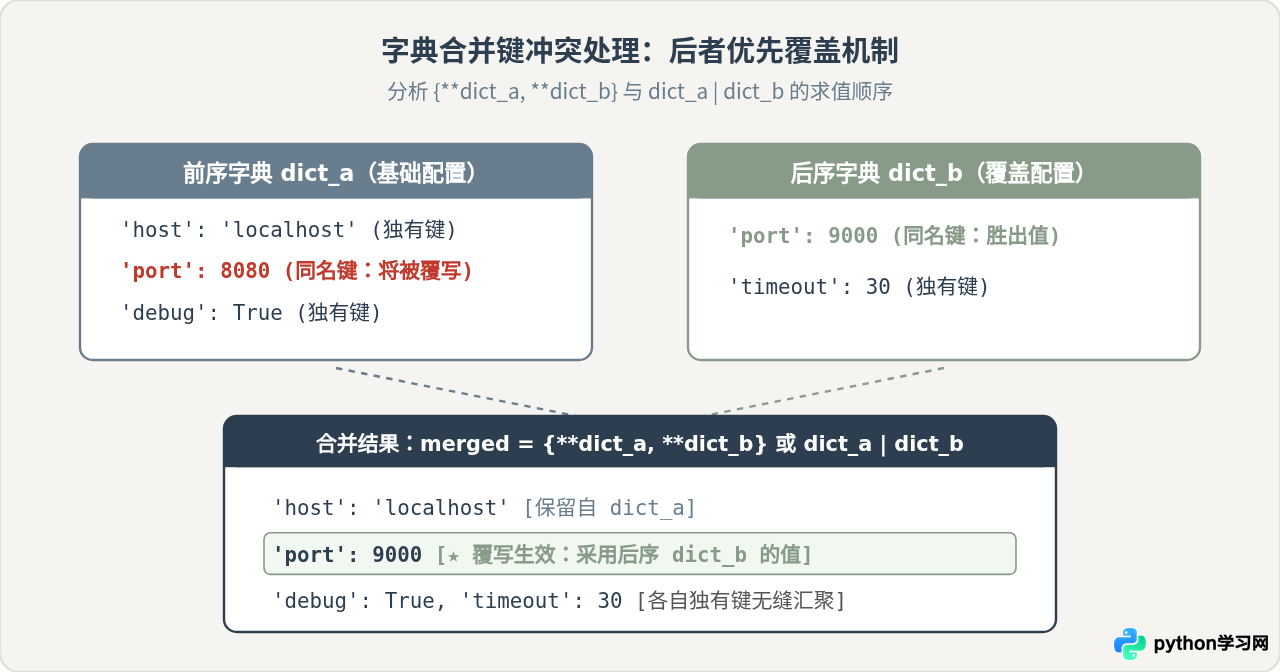
字典作为键值映射(Key-Value Mapping)容器,其合并逻辑与列表存在根本不同:字典的键具有全局唯一性约束。当两个参与合并的字典包含相同的键时,必须有明确且可预测的“冲突判定与覆盖策略”。
1. 原地更新:dict.update()
update() 是字典提供的就地变更方法。它可以接收另一个字典,或由 (key, value) 键值对组成的可迭代对象,还可以接收关键字参数。如果目标字典中已存在相同的键,该键的值会被新提供的值直接覆写;如果不存在,则新增键值对。与 extend() 相同,update() 返回 None。
# 示例:使用 update 原地更新配置
server_config = {"host": "127.0.0.1", "port": 8080, "debug": True}
override_config = {"port": 9000, "timeout": 30}

# 原地更新 server_config
server_config.update(override_config)

print("更新后的配置:", server_config)更新后的配置: {'host': '127.0.0.1', 'port': 9000, 'debug': True, 'timeout': 30}
2. 双星号解包:{**dict1, **dict2}
双星号 ** 用于字典解包,将各字典展开为键值对并组装进全新的字典花括号中。解包操作的核心规则是“后者胜出(Last Wins)”:当多个字典中出现同名键时,靠右放置的字典解包结果会无条件覆盖靠左字典的对应值。
# 示例:双星号解包生成新字典
default_settings = {"theme": "light", "notifications": True, "cache_size": 100}
user_settings = {"theme": "dark", "cache_size": 256}

merged_settings = {**default_settings, **user_settings}

print("合并后的配置:", merged_settings)
print("原配置是否被修改:", default_settings["theme"] == "light")合并后的配置: {'theme': 'dark', 'notifications': True, 'cache_size': 256}
原配置是否被修改: True
3. Python 3.9+ 现代化运算符:| 与 |=
PEP 584 为字典类型正式引入了联合运算符(Union Operators)。其中 | 用于创建新字典,|= 用于就地更新现有字典。这一改动让字典合并的语法表现力与集合、数值运算保持了一致性,语义极为直观。
# 示例:Python 3.9+ 字典合并运算符
dict_a = {"id": 1, "status": "pending"}
dict_b = {"status": "completed", "retries": 0}

# 1. 表达式合并(生成新字典)
new_dict = dict_a | dict_b

# 2. 原地合并运算符
dict_a |= dict_b

print("new_dict:", new_dict)
print("dict_a (就地更新后):", dict_a)new_dict: {'id': 1, 'status': 'completed', 'retries': 0}
dict_a (就地更新后): {'id': 1, 'status': 'completed', 'retries': 0}
三、操作实施与关键决策流程
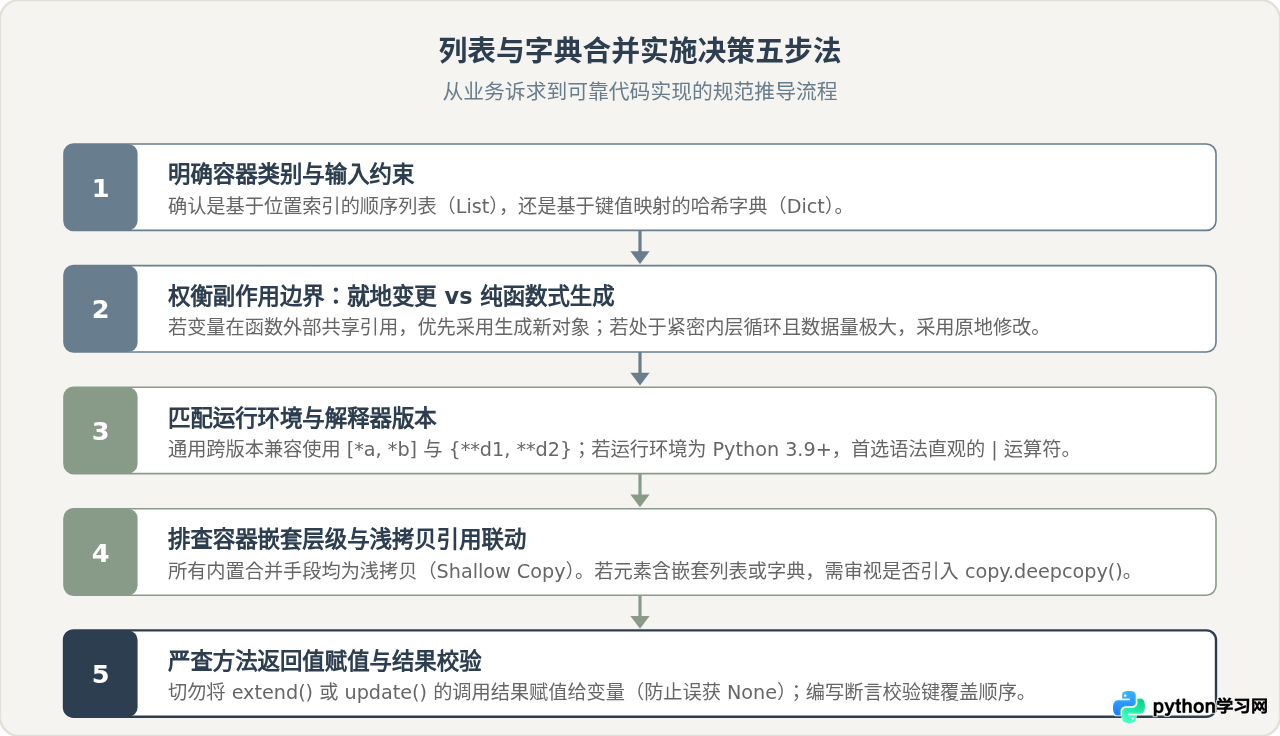
在工程实践中,选择具体的合并方式应当遵循严谨的判定路径。开发者需要依次审视数据结构类型、副作用容忍度、运行环境版本以及嵌套结构的共享引用风险。
四、关键情境差异深度对比与避坑指南
为了在实际编码中写出高健壮性代码,理解两种关键情境下的行为差异至关重要。
1. 情境对比:不可变性保证 vs 内存就地修改
在设计函数参数传递与模块接口时,选择“原地修改”还是“返回新对象”会产生截然不同的架构影响:
- 原地修改(extend / update / |=):直接在原内存地址中追加槽位或重写哈希桶,避免了分配全新底层数组带来的额外开销。在处理数十万条数据批处理时,性能优势显著。但在多模块协作或多线程共享数据时,原地修改会悄悄改变外部变量,导致高度隐蔽的并发与状态污染 Bug。
- 生成新对象(+ / 解包 / |):原数据获得完整的只读保护,满足无副作用函数(Pure Function)的设计原则,逻辑清晰易于单元测试。代价是必须重新分配内存并完整遍历拷贝元素指针,当数据规模庞大时会带来瞬间的内存峰值。
如果函数内部对传入的可变对象调用了 extend() 或 update(),调用者外部的实参会同步受损。若非明确需要“输出参数”模式,函数内部应优先使用解包或合并运算符构造新对象返回。
2. 核心陷阱:所有内置合并手段均为浅拷贝
无论是 extend()、+、星号解包、update() 还是 | 运算符,它们在将元素或键值对组装时,复制的都仅仅是“对象的指针引用”,而非递归复制对象实体本身。对于多层嵌套结构,这一点极其容易引发非预期联动。
# 示例:浅拷贝陷阱演示
dict1 = {"meta": {"page": 1, "size": 20}}
dict2 = {"status": "ok"}

# 表面上生成了新字典
merged = {**dict1, **dict2}

# 修改合并后字典中的嵌套字典
merged["meta"]["page"] = 2

# 检查原始 dict1:同样被修改!
print("dict1 的 meta.page:", dict1["meta"]["page"])dict1 的 meta.page: 2
要彻底切断多层嵌套结构的引用耦合,单纯使用合并语法是不够的,必须借助标准库 copy.deepcopy() 进行深度递归复制。
五、全景总结与方法特性速查
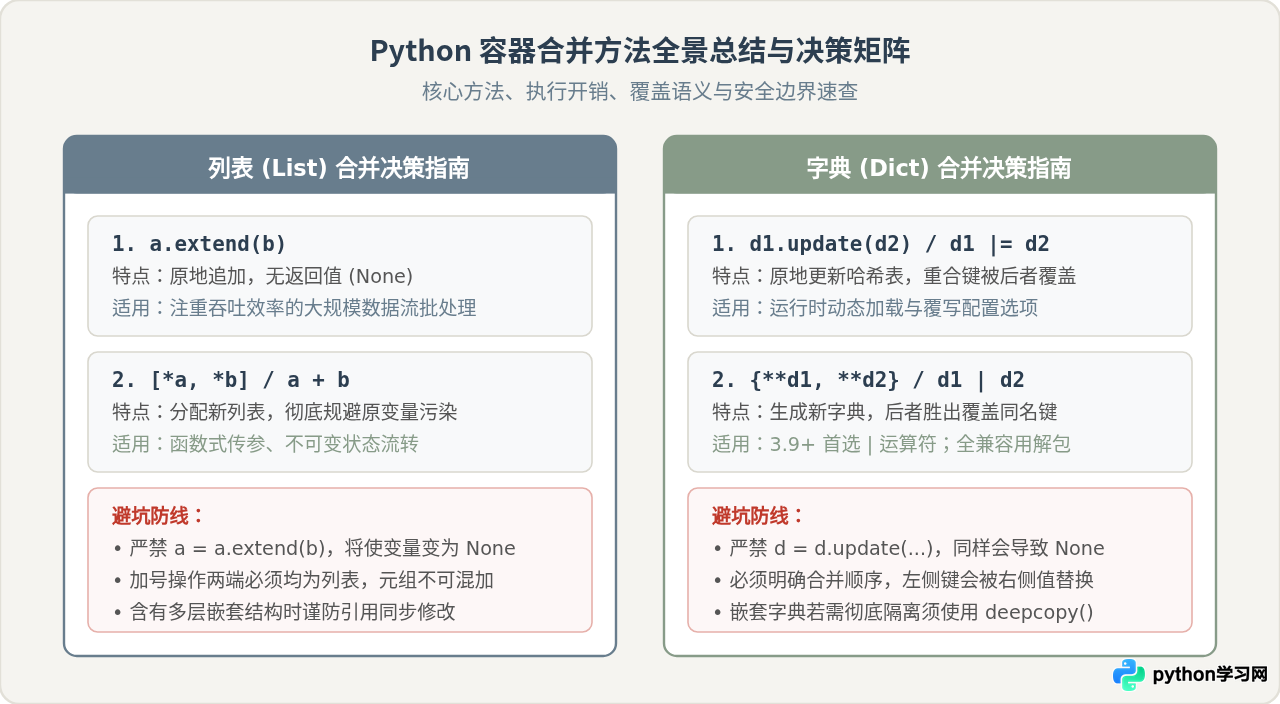
在 Python 的实际应用中,各种合并方法各有其明确的适用边界与取舍标准。下表梳理了本文涵盖的全部合并手段的特性矩阵,便于在工程选型中快速对照参考。
| 操作语法 | 容器类型 | 修改原对象 | 产生新对象 | 核心优势与推荐场景 |
|---|---|---|---|---|
list.extend(iter) |
列表 | 是(就地) | 否(返回 None) | 单次调用性能最高,适合大批量流水线数据归拢 |
list1 + list2 |
列表 | 否 | 是 | 语法直观,适合简短表达式,两端必须严格为列表 |
[*a, *b] |
列表 | 否 | 是 | 最灵活,支持任意可迭代类型混合及常量元素穿插 |
dict.update(other) |
字典 | 是(就地) | 否(返回 None) | 支持字典、键值对序列与关键字参数,适合配置覆写 |
{**d1, **d2} |
字典 | 否 | 是 | 通用解包语法,全版本支持,遵循后者胜出覆盖规则 |
d1 | d2 (3.9+) |
字典 | 否 | 是 | 现代化优雅语法,意图清晰,推荐 Python 3.9+ 环境首选 |
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









