

不用NumPy,Python标准库怎么生成随机数矩阵
在不依赖第三方库NumPy的情况下,如何使用Python标准库random模块与列表推导式高效、安全地生成随机整数与浮点数二维矩阵,并深入解析常见浅拷贝陷阱与内存开销。
在没有安装或无法引入第三方依赖 NumPy 的环境下,Python 生成随机数矩阵的核心方案是利用标准库 random 配合嵌套列表推导式(Nested List Comprehension)。Python 原生语法使用二阶列表(即列表的列表)表示二维网格结构,通过两层推导式可以分别控制行数与列数,以简洁、纯原生且无内存共享副作用的方式快速构造所需的随机矩阵。
一、核心做法:嵌套列表推导式
生成矩阵通常需要确定行数(rows)与列数(cols)。根据业务需求的不同,标准库 random 提供了多种随机发生器:
random.random():生成[0.0, 1.0)区间内的均匀浮点数。random.randint(a, b):生成[a, b]区间内的闭区间整数。random.uniform(a, b):生成指定浮点区间[a, b]内的连续随机数。
以下是生成 3 行 4 列浮点数矩阵与整数矩阵的标准代码:
import random

rows = 3
cols = 4

# 1. 生成 [0.0, 1.0) 范围的浮点数矩阵
float_matrix = [[random.random() for _ in range(cols)] for _ in range(rows)]

# 2. 生成 [10, 99] 范围的双位数整数矩阵
int_matrix = [[random.randint(10, 99) for _ in range(cols)] for _ in range(rows)]

print("浮点矩阵示例:")
for row in float_matrix:
    print([round(val, 3) for val in row])

print("\n整数矩阵示例:")
for row in int_matrix:
    print(row)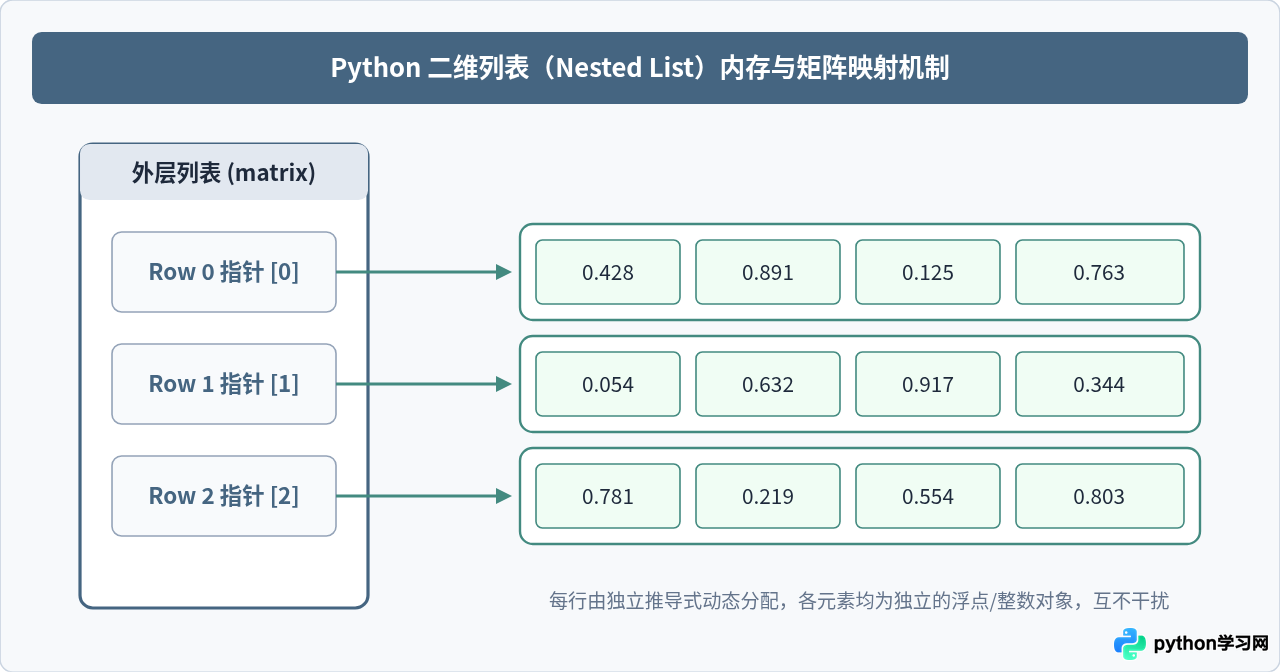
二、标准操作流程与步骤拆解
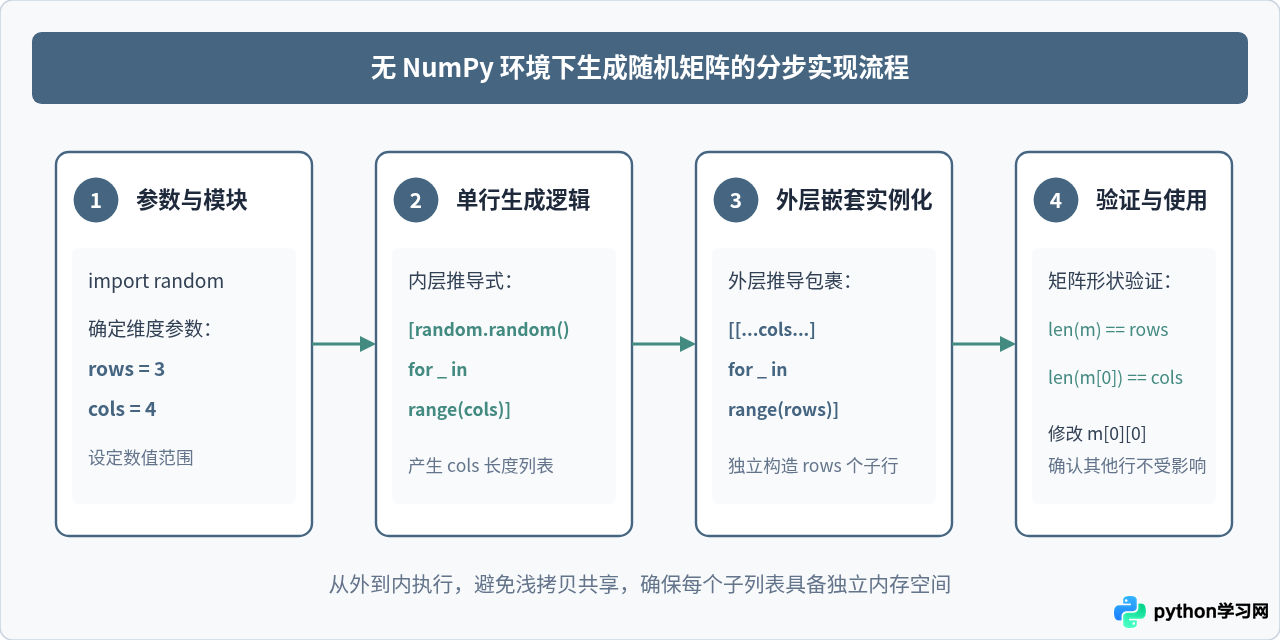
为了让代码具有良好的可维护性与复用性,构造矩阵时通常遵循以下四个确定性步骤:
- 步骤一:导入模块与配置参数。引入
random模块,明确定义目标行数rows、列数cols以及取值上下界。 - 步骤二:确定单行生成逻辑。通过内层推导式
[func() for _ in range(cols)]产生具有指定列数的一维列表。 - 步骤三:外层循环嵌套实例化。外层循环执行
rows次,每次执行都触发内层推导式新建一个全新的子列表对象。 - 步骤四:形状校验与索引测试。检查
len(matrix) == rows与len(matrix[0]) == cols,确保矩阵边界正确。
三、必须规避的浅拷贝陷阱
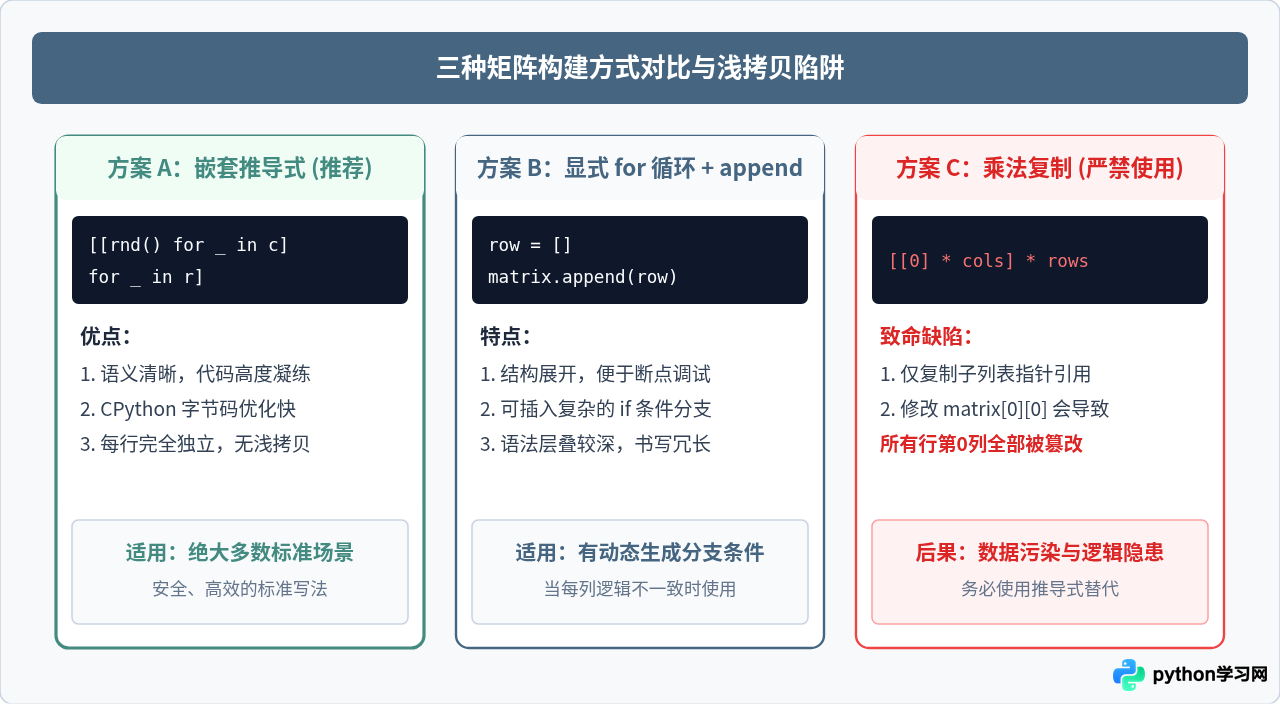
初学者在尝试快速初始化二维列表时,经常会尝试使用乘法操作符 *,例如:
# 错误示例:浅拷贝引用复制
bad_matrix = [[0] * 4] * 3注意:使用 [[0] * cols] * rows 生成矩阵是极其危险的。外层的乘法操作并未创建多个新的子列表,而是将同一个内部列表的内存地址重复引用了 rows 次。一旦修改 bad_matrix[0][0] = 99,你会发现所有行的第 0 列都会同步变成 99。
四、更多常见需求与扩展模式
1. 生成正态(高斯)分布矩阵
如果需要模拟物理测量、统计误差或金融随机波动,可以使用 random.gauss(mu, sigma):
import random

# 生成均值为 0,标准差为 1 的 4x4 正态分布矩阵
rows, cols = 4, 4
gaussian_matrix = [
    [random.gauss(0.0, 1.0) for _ in range(cols)]
    for _ in range(rows)
]
2. 从离散集合或带权重抽样构造矩阵
对于分类标签、稀疏离散值或模拟网格游戏地图,可以使用 random.choice() 或 random.choices():
import random

# 从 ['A', 'B', 'C'] 中按不同概率权重生成 3x5 标签矩阵
labels = ['A', 'B', 'C']
weights = [0.6, 0.3, 0.1]
categorical_matrix = [
    random.choices(labels, weights=weights, k=5)
    for _ in range(3)
]
这里每一行直接通过 random.choices(..., k=cols) 生成一个全新的长度为 cols 的独立列表,执行效率相较单元素循环更优。
3. 生成器表达式:超大规模矩阵的惰性加载
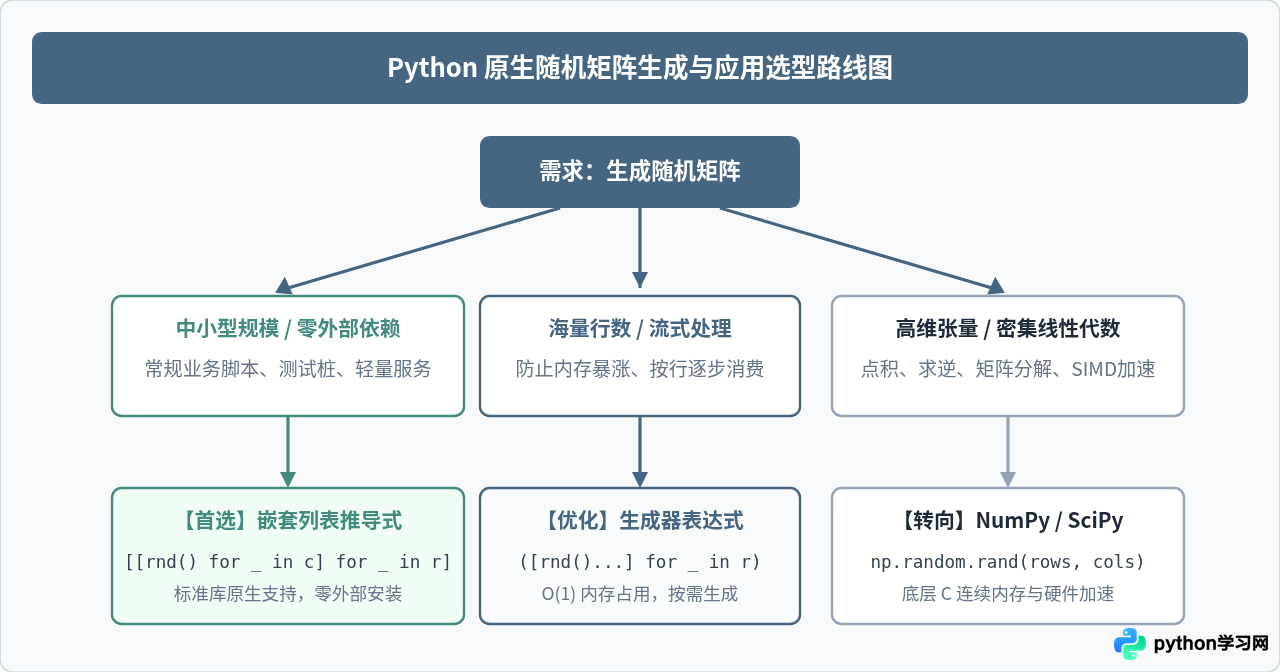
当需要的矩阵行数非常庞大(例如数十万行),直接一次性生成完整的嵌套列表会消耗巨大的内存。若数据处理是按行流式消费的,改用生成器表达式可以实现零内存常驻:
import random

# 惰性生成器:按需产生每一行,不在内存中持久化全量列表
rows, cols = 1_000_000, 10
matrix_stream = (
    [random.random() for _ in range(cols)]
    for _ in range(rows)
)

# 逐行消费,内存占用恒定维持在极小水准
for index, row in enumerate(matrix_stream):
    if index >= 3:
        break
    print(f"Row {index}:", [round(x, 2) for x in row])
五、封装与打印:通用工具函数
为了让控制台输出更符合数学上的矩阵对齐效果,可以封装一个通用的构造与格式化打印函数:
import random

def create_random_matrix(rows, cols, generator=random.random):
    """
    使用指定的生成函数构造二维随机数矩阵
    :param rows: 行数
    :param cols: 列数
    :param generator: 随机函数,默认 random.random
    :return: 独立二维列表
    """
    return [[generator() for _ in range(cols)] for _ in range(rows)]

def print_matrix(matrix, precision=2):
    """规整打印矩阵内容"""
    for row in matrix:
        formatted = [f"{val:6.{precision}f}" if isinstance(val, float) else f"{val:4d}" for val in row]
        print("[" + ", ".join(formatted) + " ]")

# 测试调用
m = create_random_matrix(4, 4, lambda: random.randint(1, 50))
print_matrix(m)
六、技术选型与适用边界
是否引入 NumPy 取决于具体的应用场景与计算规模:
- 适合使用 Python 标准库场景:轻量化脚本、微服务、无网络安装环境、仅用于算法单元测试桩(Mock 数据)、维度较小(千级元素以内)的常规数据处理。
- 必须选用 NumPy 场景:后续需要进行矩阵乘法(
@运算)、转置求逆、特征值分解、广播(Broadcasting)计算,或者元素规模达百万级以上需要连续内存布局与 SIMD 矢量硬件加速。
总结
不用 NumPy 生成随机数矩阵,最简洁规范的方式就是使用 Python 标准库的 random 模块与嵌套列表推导式。关键在于理解二维列表是“外层列表持有多个内层列表引用”的数据结构,始终通过独立迭代构建每一行,彻底规避乘法操作符带来的浅拷贝陷阱。掌握这一方法,能够在零外部依赖的前提下,高效安全地应对各类测试与基础算法开发任务。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









