

Python字符串切片详解:怎么提取子串及设置步长
深入解析Python字符串切片的核心机制,讲解如何灵活提取子串、正负索引与左闭右开区间规则、步长参数的设置技巧以及常见易错陷阱与实战模式。
在 Python 中,从字符串中截取指定子串最基础且最高效的方式是使用切片(Slice)操作。其标准语法形式为 string[start:stop:step],通过指定起始索引、结束索引以及可选的步长,开发者可以用单行表达式完成从截取子串、抽取固定间隔字符到整串倒序输出的各类需求。掌握这一特性的关键,在于理解 Python 索引的“左闭右开”区间规则以及正负步长对扫描方向的决定性控制。
一、切片基本结构与索引定位原理
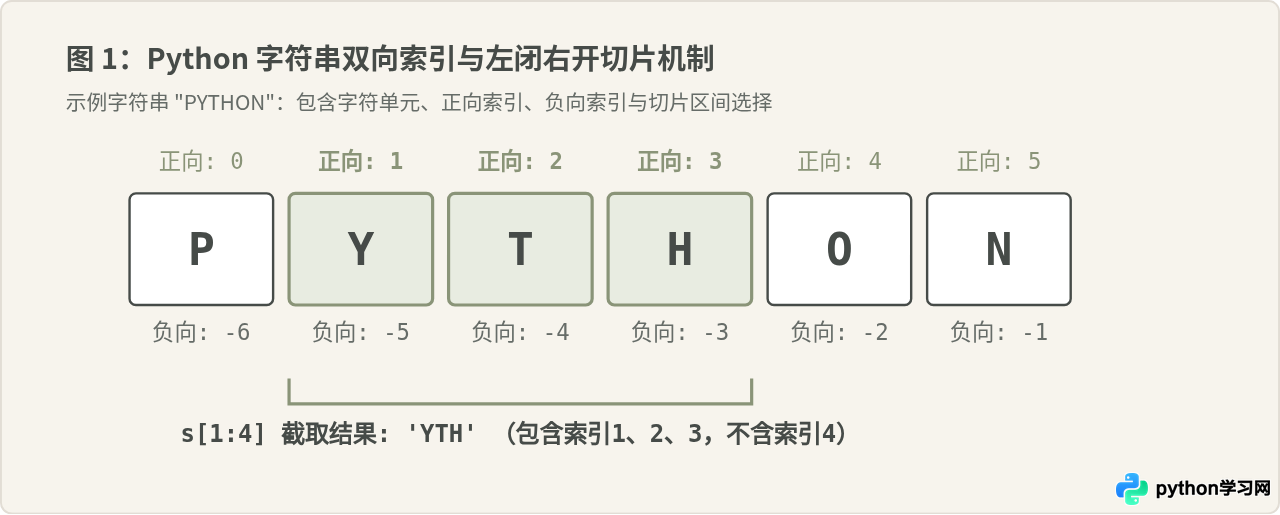
Python 字符串是一种不可变的有序序列,序列中的每一个字符都有两个对应的索引编号:正向索引从开头的 0 依次递增,负向索引则从末尾的 -1 依次递减。切片操作的基础形式是包含冒号的括号表达式:
# 切片标准完整格式
string[start:stop:step]

# 最常用的基础切片(步长默认为 1)
string[start:stop]
在这个表达式中,各参数的具体含义如下:
- start(起始索引):截取开始的位置,对应的字符会被包含在结果中。
- stop(结束索引):截取结束的位置,对应的字符不包含在结果中(数学上的左闭右开区间
[start, stop))。 - step(步长):每次移动的步进跨度,默认为
1。步长不仅决定取字符的频率,正负号还决定了扫描移动的方向。
二、提取子串的具体操作与缺省边界
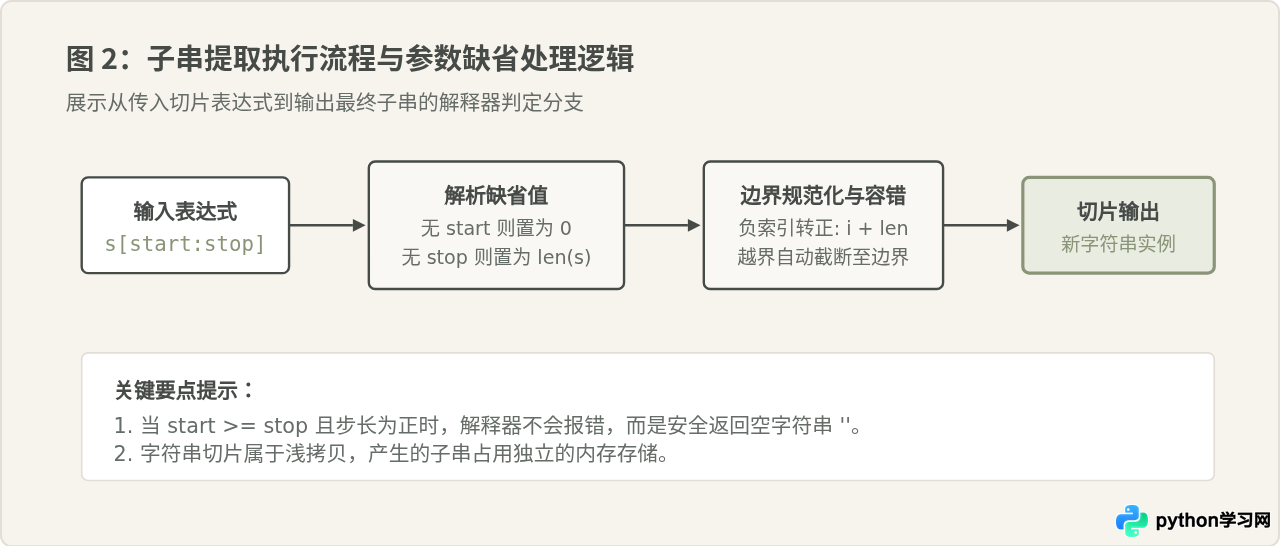
在实际代码编写中,start 和 stop 并不总是需要全部显式写出。Python 为切片提供了便捷的省略规则:当参数缺省时,解释器会自动将其补充为序列的自然边界。
1. 省略 start:从头开始截取
当切片表达式为 [:stop] 时,系统默认 start = 0。例如提取前 4 个字符:
# 示例代码:提取前缀
text = "PythonCode"
prefix = text[:6]
# 输出结果说明:得到 "Python"(索引 0 至 5)
2. 省略 stop:一直截取到末尾
当切片表达式为 [start:] 时,系统默认截取至字符串的最后一个字符(含末尾)。例如去掉前 6 个字符获取剩余内容:
# 示例代码:提取后缀
text = "PythonCode"
suffix = text[6:]
# 输出结果说明:得到 "Code"(从索引 6 开始直至字符串结尾)
3. 同时省略:生成浅拷贝副本
表达式 [:] 会从头完整复制到尾部,得到内容完全相同的新字符串:
# 示例代码:完整复制
copy_str = text[:]
# 输出结果说明:得到 "PythonCode"初学者容易将单字符索引提取 text[index] 与切片 text[start:stop] 混淆。如果访问 text[99],Python 会直接报 IndexError: string index out of range 异常;但切片操作具备内置边界截断特性,例如 text[2:999] 不会报错,而是温和地在遇到字符串实际终点时停止,返回从索引 2 到结尾的全部子串。
三、步长(Step)详解:正向跳跃与负向反转
步长是切片中最灵活也最容易引起理解偏差的参数。步长同时肩负两项职责:绝对值大小决定跳跃步幅,符号决定扫描方向。
1. 正步长(Step > 0):自左向右跳跃
当步长为正整数时,切片从 start 索引开始,每次索引增加 step,直到达到或超过 stop 为止。常见场景包括提取奇数位或偶数位字符:
numbers = "0123456789"

# 隔一个取一个(获取偶数数字)
even_chars = numbers[0:10:2]
# 示例输出:'02468'

# 从索引 1 开始隔一个取一个(获取奇数数字)
odd_chars = numbers[1:10:2]
# 示例输出:'13579'
2. 负步长(Step < 0):自右向左反向提取
当步长为负数时,扫描方向从常规的“自左向右”反转为“自右向左”。每次索引变化为 index += step(即索引不断减小)。因此,此时必须满足:起始索引 start 大于 结束索引 stop,切片才能采到字符。
在负步长下,各参数的缺省行为也会同步反转:
start缺省值变为最后一个字符(索引 -1)。stop缺省值变为第一个字符之前的位置(包含开头的字符)。
这也是 Python 中最经典的“字符串反转”写法的底层原理:
# 字符串反转
original = "abcdef"
reversed_str = original[::-1]
# 示例输出:'fedcba'

# 带有显式区间的负步长切片
# 从索引 4 ('e') 倒序取到索引 1 ('b'),左闭右开故不含索引 1
sub_rev = original[4:1:-1]
# 示例输出:'edc'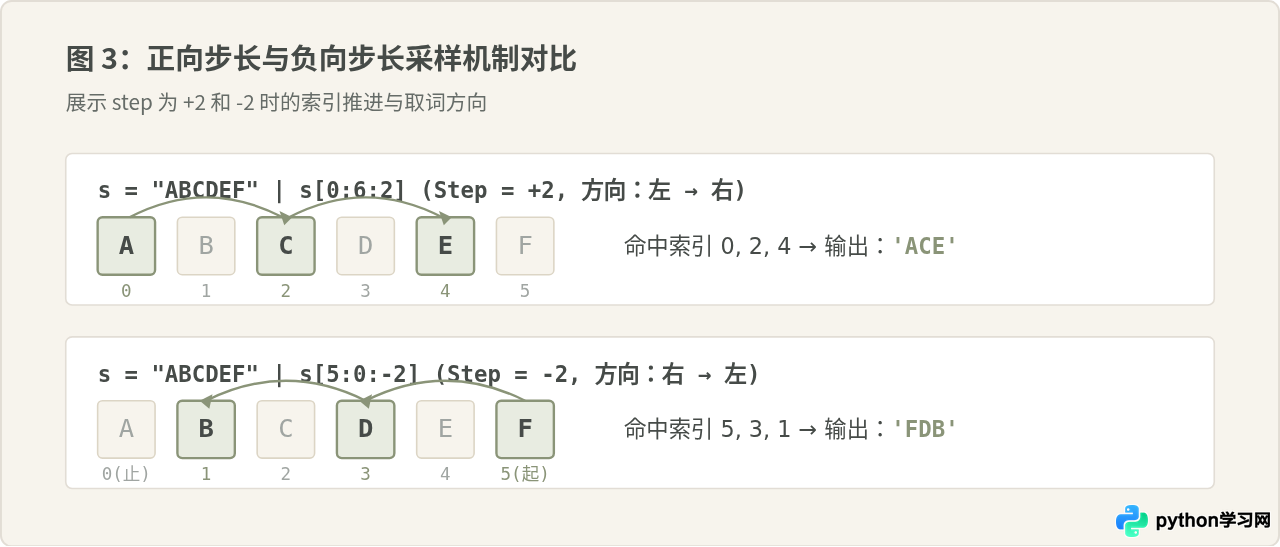
四、容易混淆的常见误区与避坑解析
误区一:想要截取到最后一个字符,却把 stop 写成了 -1
很多初学者知道 -1 代表字符串的最后一个字符,于是写出 s[2:-1],结果发现输出始终少掉了最后一个字符。原因在于“左闭右开”规则:当 stop = -1 时,表示截取到索引 -1 的前一个位置就截止,因此最后一个字符永远不会被选中。
正确做法:如果需要截取到字符串的最末尾,直接省略 stop,写成 s[2:] 即可。
误区二:负步长下没有颠倒 start 和 stop 导致返回空字符串
例如执行 s[1:5:-1],很多读者期望它把索引 1 到 5 的内容倒序输出,但 Python 实际返回的是空字符串 ''。这是因为步长为 -1 要求索引递减,但起始点 1 本身就比终点 5 小,在向左搜索时永远无法到达终点 5,条件立即终止。
正确做法:负步长必须保证 start > stop,如需截取相应区间的倒序,应写为 s[4:0:-1] 或先正向切片再逆序:s[1:5][::-1]。
误区三:误认为切片可以直接修改原字符串内容
Python 中字符串属于 Immutable(不可变)对象。切片操作只是从原字符串中读取指定位置的字符并拼接生成一个崭新的字符串对象,原变量中的内容绝不会发生任何改变。如果尝试给切片赋值(如 s[0:2] = 'AB'),Python 会直接抛出 TypeError: 'str' object does not support item assignment 异常。
五、常用切片模式速查与总结
在日常开发与文本处理中,合理组合 start、stop 与 step 能够高效解决多数子串提取需求。下表梳理了最常见的切片应用模板:
| 表达式 | 操作含义 | 示例(s = "HelloPython") | 实际输出 |
|---|---|---|---|
s[:n] |
获取前 n 个字符 | s[:5] |
'Hello' |
s[n:] |
跳过前 n 个字符,获取剩余全部 | s[5:] |
'Python' |
s[-n:] |
获取末尾倒数 n 个字符 | s[-6:] |
'Python' |
s[:-n] |
去除末尾倒数 n 个字符 | s[:-6] |
'Hello' |
s[::2] |
全串按步长 2 隔字采样 | s[::2] |
'HloPto' |
s[::-1] |
全字符串完整反转输出 | s[::-1] |
'nohtyPolleH' |
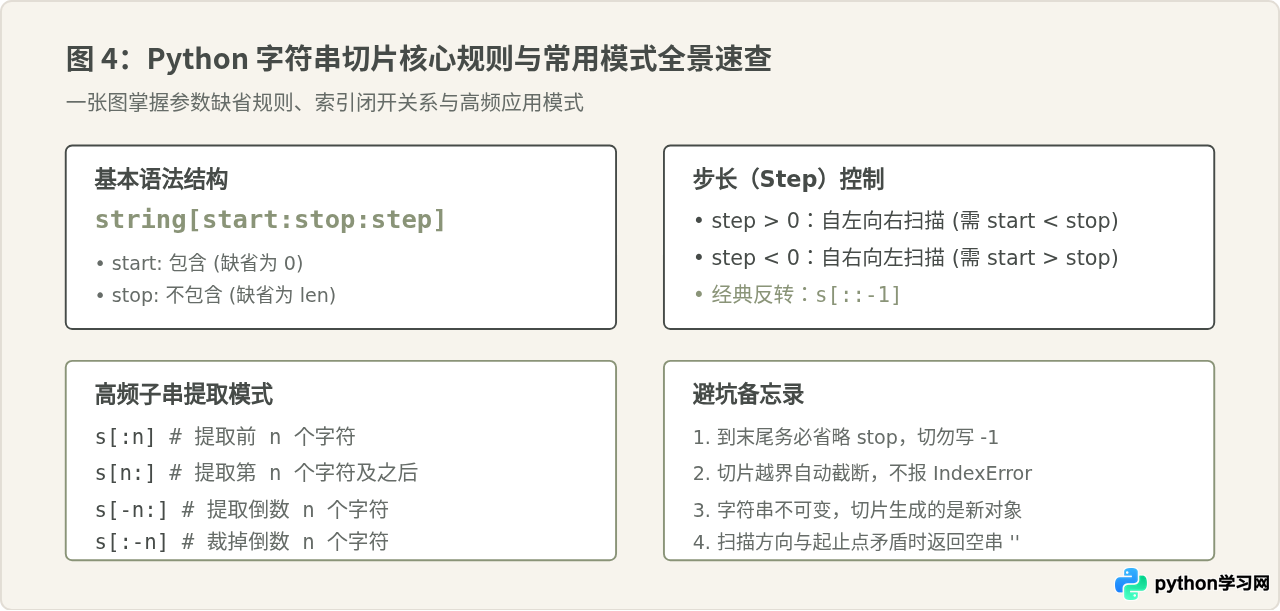
掌握了上述 [start:stop:step] 的三要素与边界缺省规则后,在处理各类文本截取、日志分析及数据清洗任务时,就能以简洁且符合 Pythonic 风格的代码准确完成子串提取与字符处理。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









