

怎么高效利用Python 3题库提升编程能力?
本文详细介绍如何高效利用Python 3题库提升编程能力,涵盖分阶段进阶路径、核心题型映射、单题四步闭环操作方法及常见误区避坑指南。
高效利用 Python 3 题库的关键不在于刷了多少道题目,而在于把题库作为“语法内化、数据结构选用与工程思维训练”的验证场。很多开发者在刷题时容易陷入盲目提交和死记硬背的误区,看似完成了上百道题,遇到实际项目需求依然无从下手。通过“按模块分阶突破、刻意写出 Pythonic 代码、题解逆向对比、单题闭环重构”的方法,才能将解题过程转化为稳定可靠的工程开发能力。
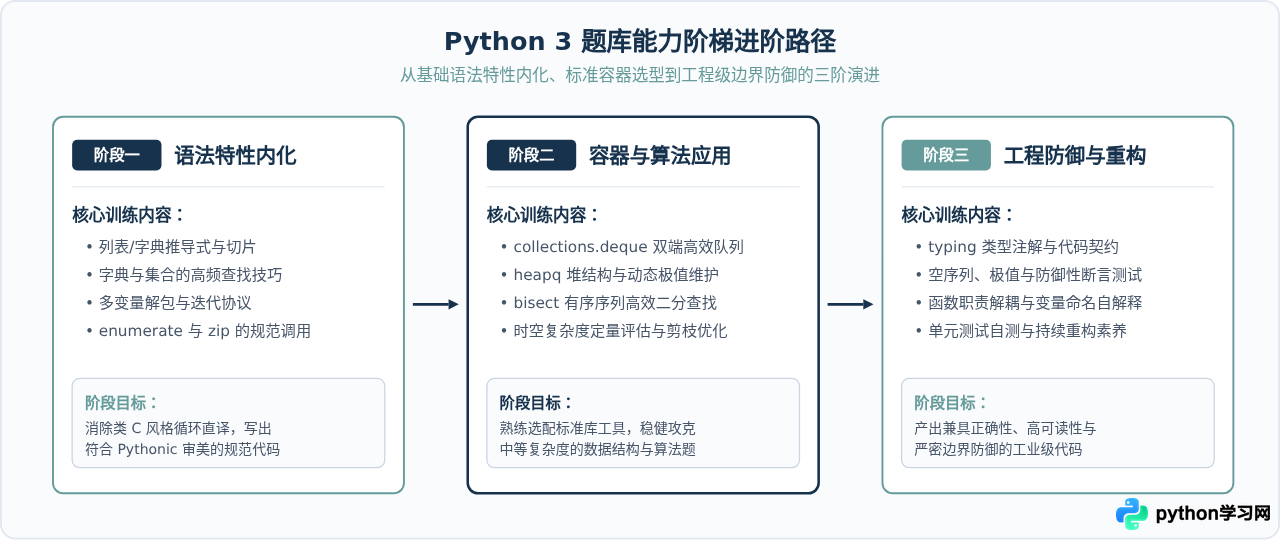
一、明确进阶节奏:题库选择与能力进阶路径
在不同技术阶段,题库所承担的训练目标完全不同。如果初学阶段直接挑战复杂的动态规划或图算法,容易产生挫败感;而在掌握算法原理后继续刷初级语法题,则是低效的重复劳动。合理规划进阶路径,是高效利用题库的第一步。
- 阶段一:语法特性内化。刚掌握 Python 3 基础语法的读者,重点不是算法设计,而是熟悉语言的核心惯用法。通过基础练习题熟练掌握列表推导式、切片、字典与集合高级操作、多重解包赋值,摆脱将 C 或 Java 代码直译为 Python 的写法习惯。
- 阶段二:容器与算法应用。在面对中等难度题目时,重点掌握标准库中的高级容器。学会利用
collections.deque实现高效双端操作、利用heapq处理动态极值、利用bisect进行有序检索,同时建立严格的时间与空间复杂度(Big-O)分析习惯。 - 阶段三:工程防御与重构。能够做出题目后,应关注代码的健壮性与可维护性。主动为函数添加
typing类型注解,严密防范空值、单元素和极值等边界情况,并按照高内聚标准拆分复杂函数。
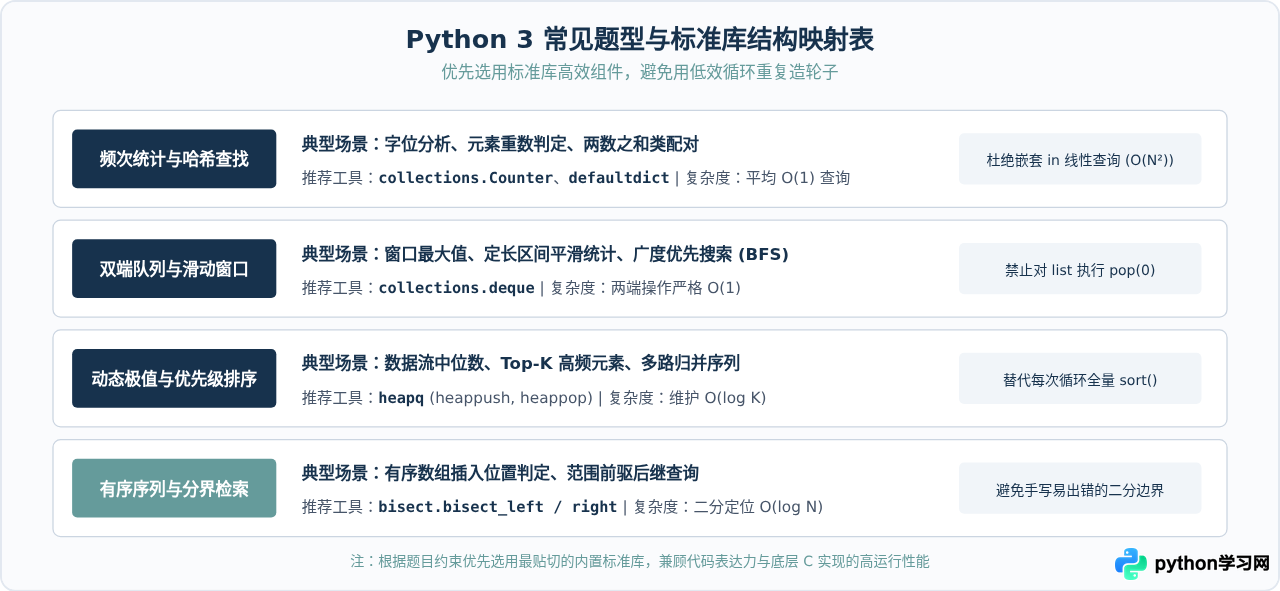
二、分类突破:核心题型与 Python 3 惯用结构映射
做题时切忌逐题盲目搜索答案,而应建立“模式识别”能力。Python 3 内置了大量针对常见算法模式优化的标准库模块,这些模块由底层 C 语言实现,不仅代码精简,运行效率也远高于纯手写的循环结构。
为了加深理解,以经典的“无重复字符的最长子串”为例,展示如何结合哈希字典与滑动窗口实现最优的线性时间解法:
# 环境要求:Python 3.8+
# 执行位置:本地 Python 解释器或标准题库编辑器

from typing import Dict

def length_of_longest_substring(s: str) -> int:
    """
    计算字符串中不含重复字符的最长子串长度。
    时间复杂度: O(N),仅遍历一次字符串
    空间复杂度: O(min(N, M)),M为字符集大小
    """
    last_seen: Dict[str, int] = {}
    max_length = 0
    left = 0

    for right, char in enumerate(s):
        # 如果当前字符已出现且在当前窗口内,将左边界收缩到重复位置的右侧
        if char in last_seen and last_seen[char] >= left:
            left = last_seen[char] + 1

        last_seen[char] = right
        max_length = max(max_length, right - left + 1)

    return max_length

# 示例验证与测试执行
if __name__ == "__main__":
    assert length_of_longest_substring("abcabcbb") == 3
    assert length_of_longest_substring("bbbbb") == 1
    assert length_of_longest_substring("pwwkew") == 3
    assert length_of_longest_substring("") == 0
print("示例测试全部通过:无重复字符最长子串长度为 3")注意:在上述实现中,通过 enumerate 一次性获取索引与元素,同时使用 last_seen 字典记录历史下标,直接通过更新 left 变量实现滑动窗口跳转,避免了频繁切片创建新字符串带来的内存分配开销。
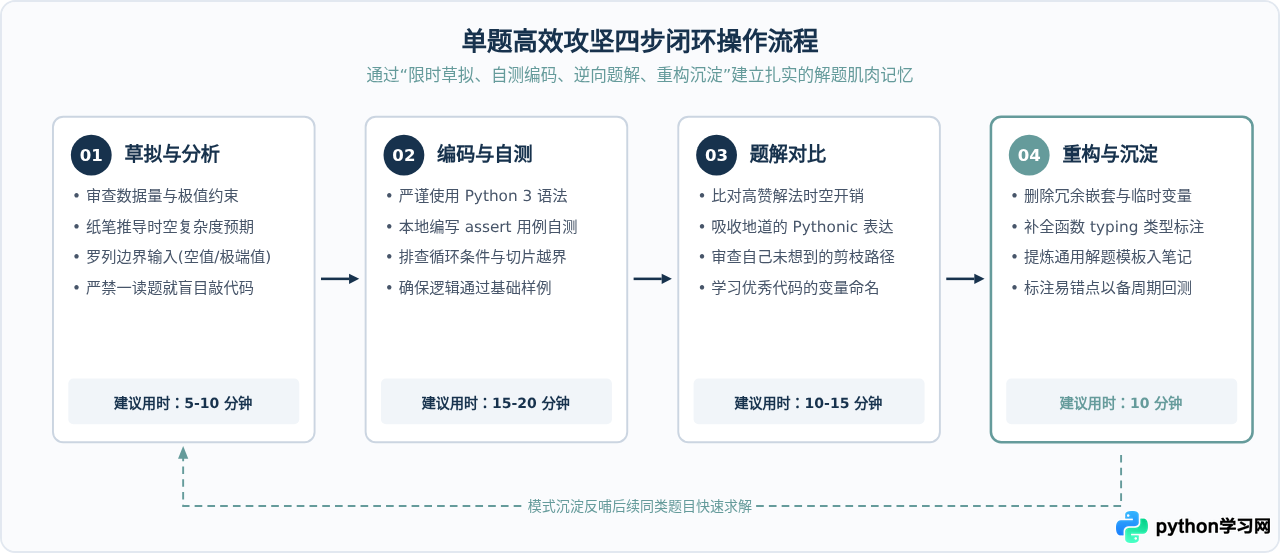
三、单题攻坚:高效刷题的四步闭环操作
很多开发者刷题效率低下的根源,在于“看题两分钟没思路就立刻翻答案”,或者“写完代码提交通过就算结束”。这两种做法都无法真正锻炼解题能力。科学的单题训练必须形成严谨的操作闭环:
代码重构对比:从能运行到工程级质量
很多初学者在提交通过后就立即跳到下一题,留下的往往是充满多层临时变量和低效逻辑的代码。通过主动对比与重构,可以显著提高代码鉴赏力与编写质量:
# 示例需求:提取列表中所有正数的平方,并按降序排序

# 常见初学者写法(冗长且存在不必要的空间占用)
def get_positive_squares_raw(numbers):
    res = []
    for i in range(len(numbers)):
        if numbers[i] > 0:
            res.append(numbers[i] * numbers[i])
    res.sort()
    res.reverse()
    return res

# 重构后 Pythonic 写法(表达清晰、无索引依赖、高内聚)
from typing import List

def get_positive_squares(numbers: List[int]) -> List[int]:
    """返回给定数字列表中正数的平方列表,按降序排列。"""
    return sorted((x * x for x in numbers if x > 0), reverse=True)

# 示例验证
if __name__ == "__main__":
    raw_input = [-3, 2, -1, 5, 4, 0]
    output = get_positive_squares(raw_input)
    print(f"处理结果: {output}")  # 输出示例: 处理结果: [25, 16, 4]
在重构版本中,我们使用生成器表达式 (x * x for x in numbers if x > 0) 配合 sorted(..., reverse=True),省去了中途构建多个临时列表和调用 reverse() 的开销,同时代码行数大幅缩减,意图一目了然。
四、避坑指南:题库训练中最易犯的四大误区
在利用题库提升能力的过程中,避开低效陷阱与掌握正向方法同样重要。以下四种常见误区,是导致“刷了很多题却写不好代码”的常见诱因:
- 误区一:只关注 AC 状态,忽视复杂度陷阱。在 Python 3 中,某些操作表面上只是一行代码,内部其实是高开销的线性扫描。例如在
while循环中频繁调用my_list.pop(0)会触发整个底层数组的内存搬移,时间复杂度从期望的 $O(1)$ 劣化为 $O(N)$,导致总体耗时飙升至 $O(N^2)$。处理队列操作必须坚决使用collections.deque。 - 误区二:盲目追求极端单行代码(One-liner)。有些开发者误以为把复杂的嵌套条件和推导式强行塞进一行代码就是“高级”。实际上,牺牲可读性和调试便利性的单行代码在工程实践中属于典型反模式。代码应当在保证优雅的同时保持直观清晰。
- 误区三:抄看官方题解后不进行独立重写。大脑在看懂别人写好的代码时容易产生“我已经掌握”的心理错觉。如果看了思路解析,应当关掉题解页面,间隔 15 分钟后从白板状态独立编写并通过所有测试用例。
- 误区四:孤立解题,缺乏跨题目的横向归纳。做完一道题后如果不做归纳,下一次遇到类似题型依然需要从零开始推导。必须把同一类的题目归类(例如滑动窗口、单调栈、回溯剪枝),提炼出统一的处理骨架。
避坑提醒:在做题时,如果发现自己的测试运行耗时极大,优先排查是否存在 in list 的线性查找(改用 set 或 dict),以及是否存在大对象的频繁全量拷贝(改用生成器或切片引用)。
五、总结与复盘:构建个人持续增量的编程能力库
高效利用题库的终极目标,是将题目的解法沉淀为自己工具箱中的通用组件。建议建立一个轻量级的个人 Markdown 或 Git 仓库,每做完一道典型题目,记录四个核心要素:题目本质模型、关键性能约束、Pythonic 核心实现、容易踩空的边界条件。
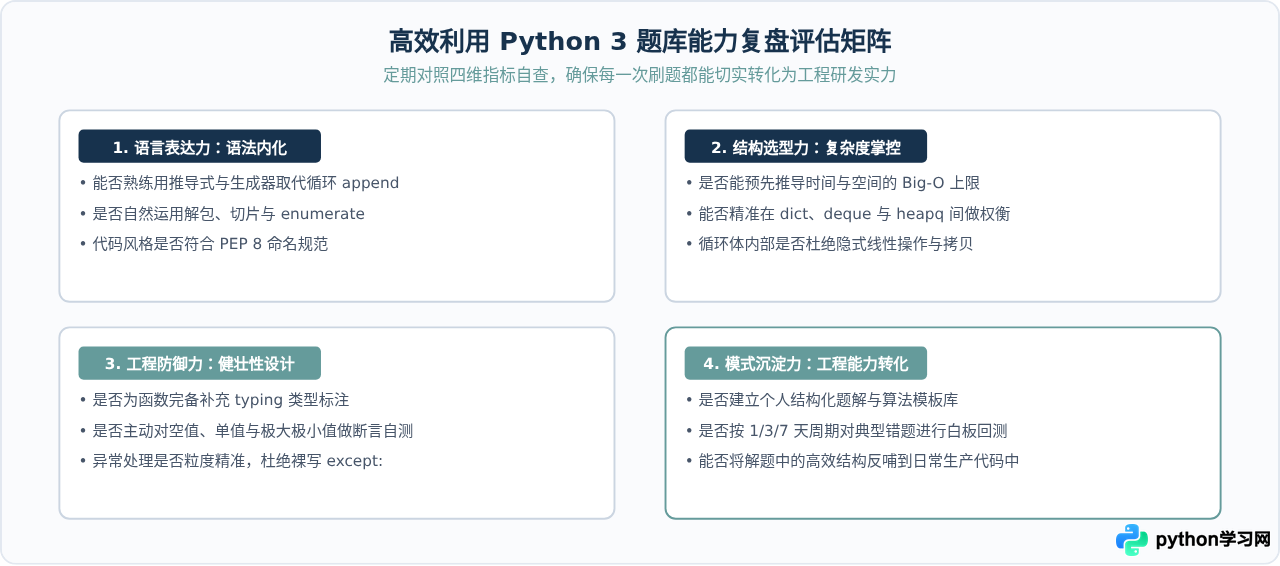
坚持按照这个标准严格要求每一道题目,刷题就不再是单调枯燥的数字累加,而是一场循序渐进的系统化工程训练。当你把 Python 3 的内置数据结构融会贯通,写出的每一行代码自然会具备工业级的高性能、高可读与高可靠性。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









