

python必背源代码*args和**kwargs代码
深入解析Python中*args与**kwargs的核心原理、必背源代码模板、参数解析顺序与解包机制,结合高频实战场景与图解,帮助开发者彻底掌握动态可变参数。
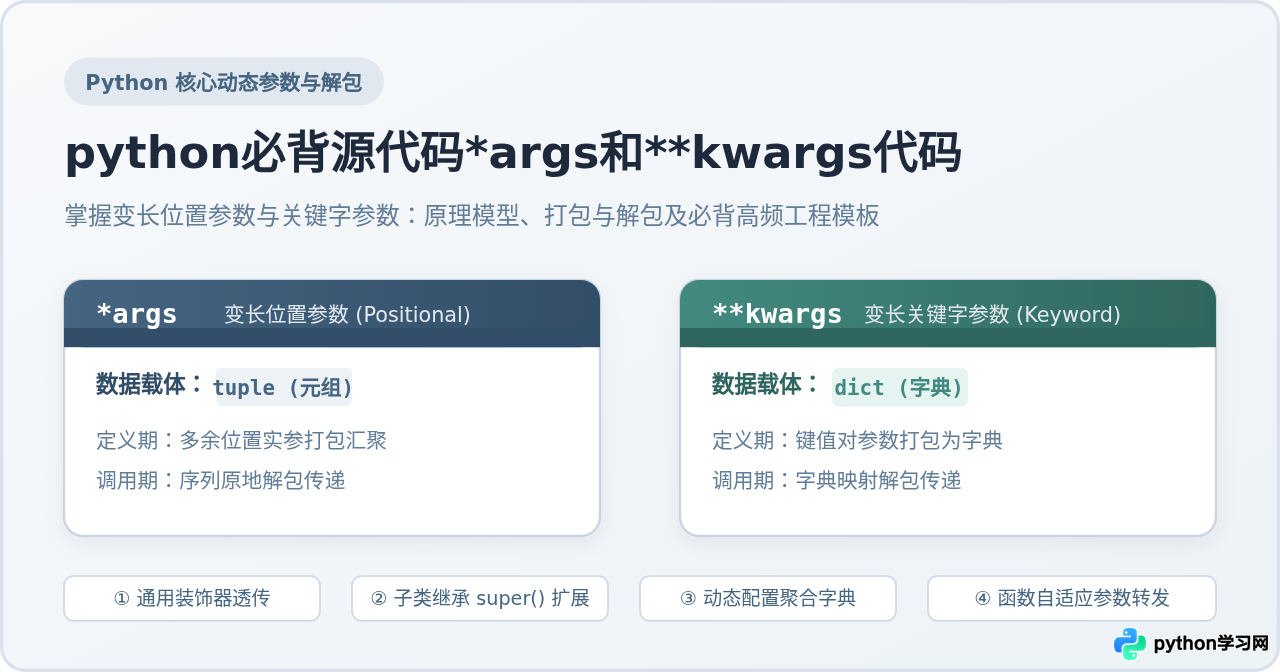
*args 和 **kwargs 是实现变长参数收集与动态透传的核心语法机制。其中单星号 * 将多余的无名位置实参聚合为不可变元组(tuple),双星号 ** 则将多余的命名键值对实参聚合为字典(dict);而在函数调用端,它们反向充当解包运算符,将数据结构无损拆解为离散实参。掌握这套语法是编写通用高阶装饰器、面向对象多层继承 super() 透传及高弹性接口必备的底层功底。本文直接剖析底层运行原理,提供生产级必背经典代码片段与参数排布防错规则。
一、底层原理:参数打包机制与内存结构
在 Python 中,语法实质由星号运算符 * 和 ** 决定,标识符名称 args(arguments 的缩写)和 kwargs(keyword arguments 的缩写)是全行业通用的规范命名约定。只要形参前带有单星号或双星号,Python 解释器在函数调用绑定形参时便会启动可变长度打包逻辑。
具体机制是:当调用端传入多个离散实参时,前置的普通位置形参会优先按序占位赋值;未被普通形参消费的所有多余位置实参会被顺序打包,构成一个只读的不可变元组(tuple)并绑定到 args;未被普通形参消费的所有关键字实参,则会被解析为键值对并组装为一个标准的内置字典(dict)绑定到 kwargs。
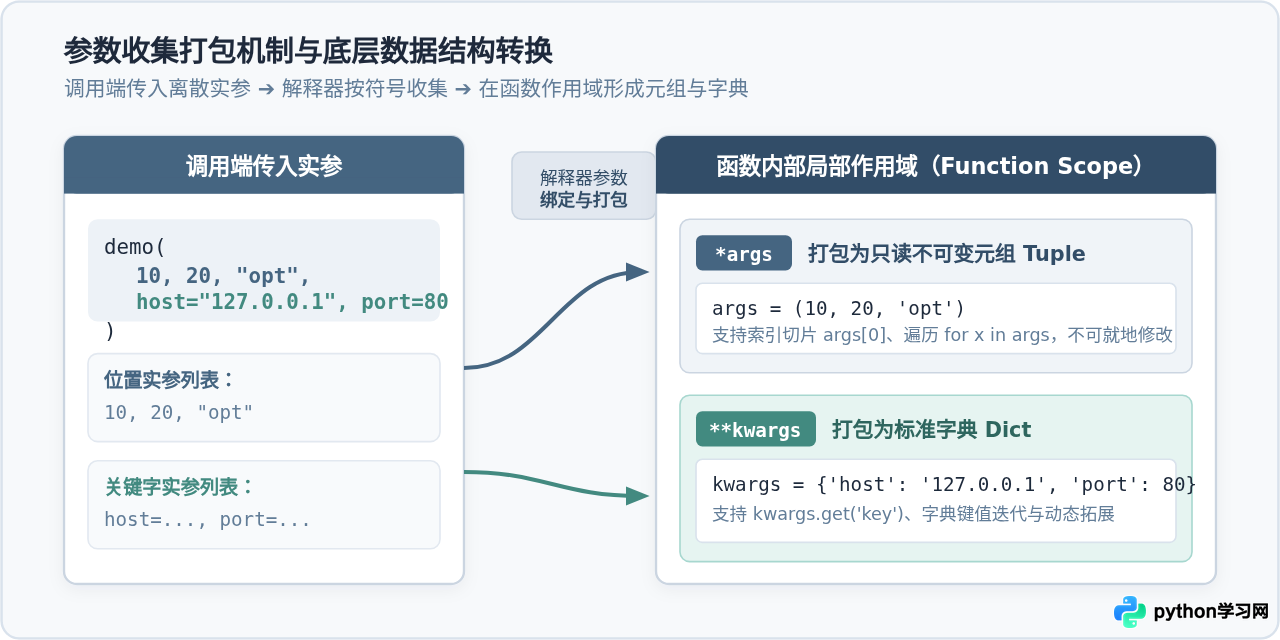
我们可以通过一段精简的代码直观观察解释器内部生成的数据结构类型:
# 源码验证:探查 args 与 kwargs 的底层类型与缺省表现
def inspect_arguments(*args, **kwargs):
    print("args 数据内容:", args)
    print("args 底层类型:", type(args))
    print("kwargs 数据内容:", kwargs)
    print("kwargs 底层类型:", type(kwargs))

# 场景 1:传入混合参数
inspect_arguments(10, 20, "demo", host="127.0.0.1", port=8080)

# 场景 2:完全不传参
print("-" * 35)
inspect_arguments()
从输出可以确认:即使完全不传入任何参数,args 也会初始化为空元组 (),kwargs 会初始化为空字典 {},二者均不为 None,在布尔上下文中求值均为 False。因此在函数体内部可以直接对其进行安全迭代或使用 in 条件判断,无需进行空值检查。
二、必背经典源代码模板
在实际项目开发与源码阅读中,*args 和 **kwargs 存在几个高频通用的工业级必背代码模式。熟悉并记住这几套经典模板,能够直接解决大多数动态传参和函数扩展需求。
模板一:变长位置参数累加与批处理(*args 经典模板)
适用于入参数量未知、支持传入任意个数数值并进行聚合并行的计算场景。
# 必背模板 1:动态累加与均值计算器
def calculate_summary(*numbers, scale: float = 1.0) -> dict:
    # numbers 在此被打包为元组,若未传参则为 ()
    if not numbers:
        return {"total": 0.0, "average": 0.0, "count": 0}

    total_val = sum(numbers) * scale
    avg_val = total_val / len(numbers)
    return {
        "total": round(total_val, 2),
        "average": round(avg_val, 2),
        "count": len(numbers)
    }

# 示例调用:可传任意数量的位置实参,末尾通过关键字指定倍率
res1 = calculate_summary(10, 25, 45, 60, scale=1.5)
print("计算结果:", res1)模板二:动态配置字典构建与过滤(**kwargs 经典模板)
适用于构建用户信息、数据库连接选项或配置字典,能够安全捕获所有动态选项,并通过 get() 或 pop() 设定安全缺省值。
# 必背模板 2:安全配置合并与提取
def create_service_node(node_name: str, ip: str, **options) -> dict:
    # 提取关键可选属性,给出明确默认值;其余扩展属性保留
    timeout = options.pop("timeout", 30)
    retry_count = options.pop("retry", 3)

    node_config = {
        "name": node_name,
        "endpoint": f"http://{ip}",
        "timeout": timeout,
        "retry": retry_count,
        "extra_metadata": options  # 剩余未显式弹出的键值对
    }
    return node_config

# 示例调用:灵活传入环境、标签等扩展参数
node = create_service_node("auth-worker", "192.168.1.10", retry=5, env="prod", zone="asia-east")
print("生成的节点配置:", node)模板三:生产级万能装饰器模板(*args, **kwargs 黄金模板)
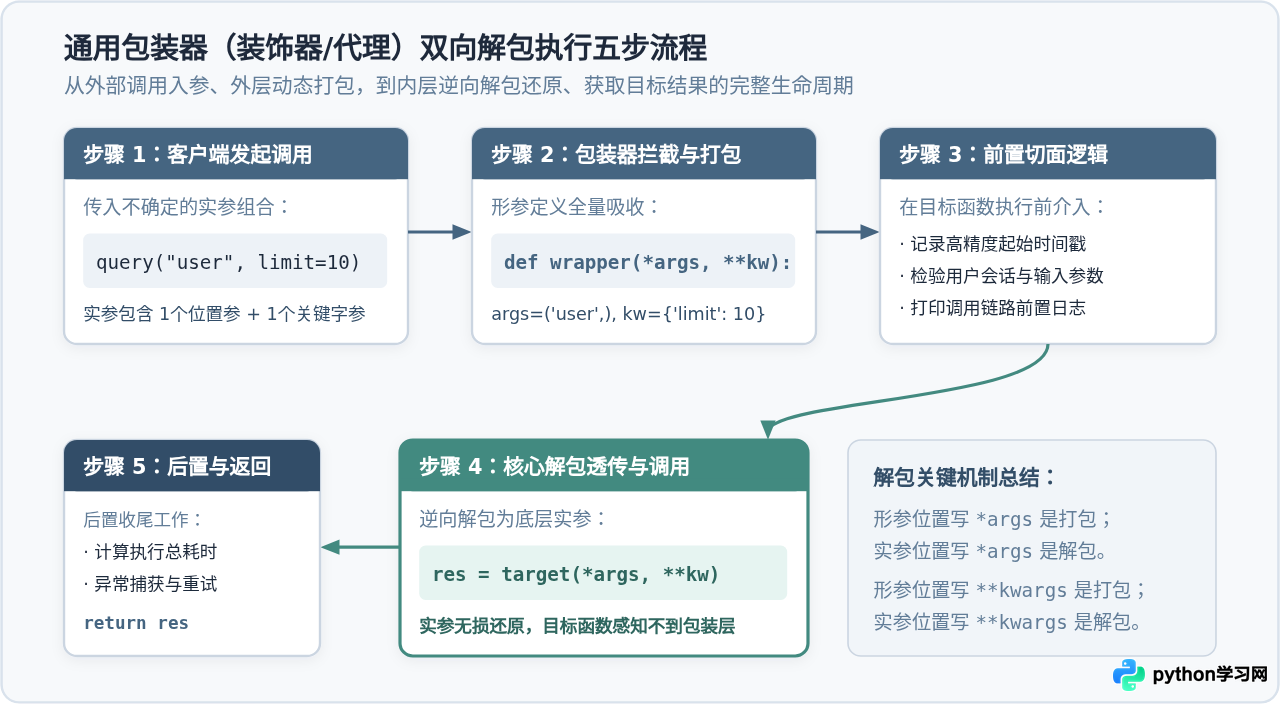
这是 Python 开发者最核心的必背模板。装饰器在包装任意未知签名的函数时,必须使用 (*args, **kwargs) 完整吸收所有实参,再通过 (*args, **kwargs) 原样逆向解包传递给被修饰函数,确保被包裹函数的调用签名不发生任何损耗或形变。
import time
from functools import wraps

# 必背模板 3:通用函数性能与执行监控装饰器
def execution_timer(func):
    @wraps(func)  # 保留原函数的 docstring 与 __name__
    def wrapper(*args, **kwargs):
        # 1. 前置处理:记录开始执行时间
        start_time = time.perf_counter()

        # 2. 核心透传:将接收到的 args 与 kwargs 原样逆向解包传入原函数
        result = func(*args, **kwargs)

        # 3. 后置处理:统计耗时并打印日志
        elapsed = (time.perf_counter() - start_time) * 1000
        print(f"[LOG] 执行函数: {func.__name__} | 耗时: {elapsed:.3f}ms")

        # 4. 返回原函数结果
        return result
    return wrapper

# 应用装饰器:被装饰函数可拥有任意参数列表
@execution_timer
def query_database(table: str, limit: int = 10, **filters):
    # 模拟耗时操作
    time.sleep(0.05)
    return f"查询成功: 表格={table}, 行数={limit}, 过滤条件={filters}"

# 示例调用
output = query_database("orders", limit=50, status="paid", region="SH")
print("调用返回:", output)模板四:面向对象子类重写与继承透传
在类的继承层次中,子类重写 __init__ 构造方法时,常常需要扩展自有属性,同时将其余未知参数完整转发给父类构造函数。
# 必背模板 4:类继承中的参数透传
class BaseDataSource:
    def __init__(self, uri: str, timeout: int = 30, **kwargs):
        self.uri = uri
        self.timeout = timeout
        self.extra = kwargs

class EncryptedDataSource(BaseDataSource):
    def __init__(self, cipher_key: str, *args, **kwargs):
        # 截取子类专属属性
        self.cipher_key = cipher_key
        # 将其余所有位置与关键字参数委托给父类
        super().__init__(*args, **kwargs)

# 示例调用
ds = EncryptedDataSource("AES-256-SECRET", "https://db.internal.net", timeout=60, pool_size=10)
print(f"数据源信息: URI={ds.uri}, 密钥={ds.cipher_key}, 超时={ds.timeout}, 额外配置={ds.extra}")三、函数形参定义的五重排布顺规
Python 解释器对函数签名中不同类型参数的排列顺序有着严格的语法约束。如果打破此规则,解释器会在编译阶段直接抛出 SyntaxError。正确的五重排布顺序如下:
- 标准位置形参(Positional Arguments):必传参数,如
def f(a, b)。 - 默认参数(Default Arguments):带有缺省值的可选参数,如
def f(a, b=10)。 - 变长位置形参(*args):负责收集多余位置实参。
- 仅限关键字形参(Keyword-Only Arguments):位于
*args之后的普通参数,调用时必须显式传键名。 - 变长关键字形参(**kwargs):负责兜底收集多余关键字实参,必须位于末尾。
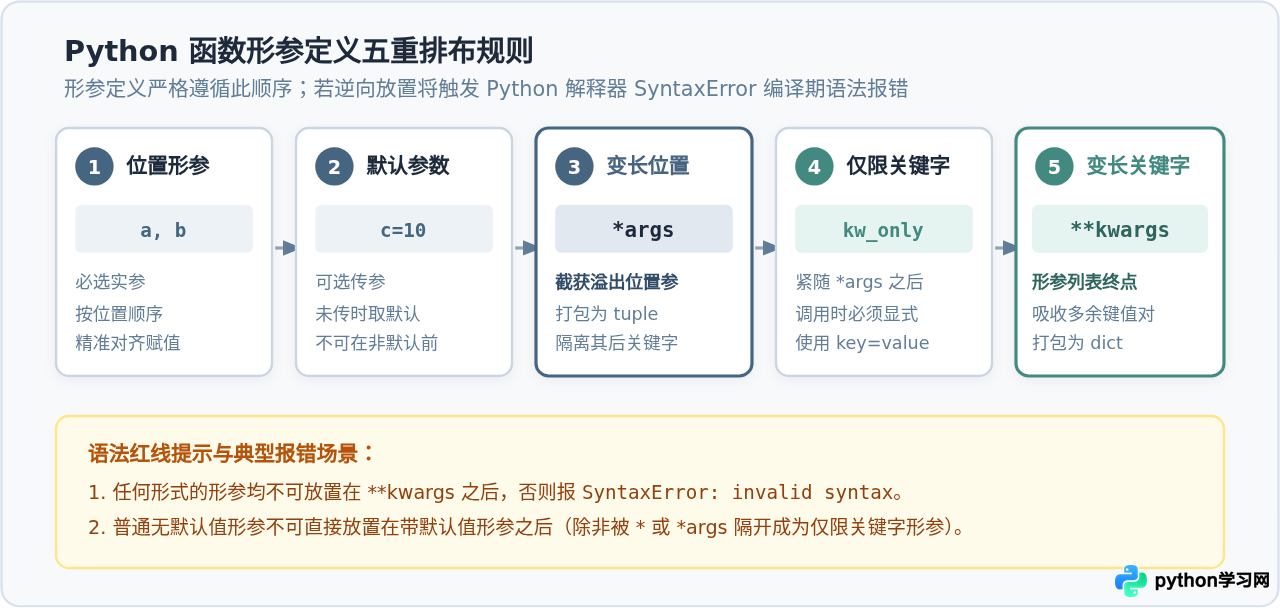
下面通过一个完整涵盖五重参数的综合范例验证此顺序的实际表现:
# 综合演示:包含全部五类参数的标准签名
def standard_pipeline(pos1, pos2="default_val", *args, kw_only=100, **kwargs):
    print(f"位置参数: pos1={pos1}, pos2={pos2}")
    print(f"变长位置: args={args}")
    print(f"仅限关键字: kw_only={kw_only}")
    print(f"变长关键字: kwargs={kwargs}")

# 正确调用:
standard_pipeline(1, 2, 3, 4, kw_only=999, tag="production", env="k8s")**kwargs 之后!例如 def func(**kwargs, last) 会直接导致 SyntaxError: invalid syntax;同时,在未声明 * 或 *args 的情况下,无默认值的常规参数不得直接跟在带默认值的参数之后(例如 def func(a=1, b) 会报 SyntaxError: non-default argument follows default argument)。
四、调用端的双向解包:* 与 ** 运算符
星号运算符具有“定义时打包、调用时解包”的对称特性。在函数调用时,在可迭代对象(列表、元组、集合)前加上 * 会将其解包为独立的位置实参;在字典映射前加上 ** 会将其解包为独立的关键字实参。
解包调用示例:
def render_view(title, width, height, background="white", theme="light"):
    return f"视图[{title}] 尺寸:{width}x{height}, 底色:{background}, 主题:{theme}"

# 准备离散数据容器
dimensions = [1920, 1080]
style_options = {"background": "slategray", "theme": "dark"}

# 结合使用 * 解包列表,使用 ** 解包字典
view_text = render_view("主控仪表盘", *dimensions, **style_options)
print(view_text)五、*args 与 **kwargs 核心特性对比与速查矩阵
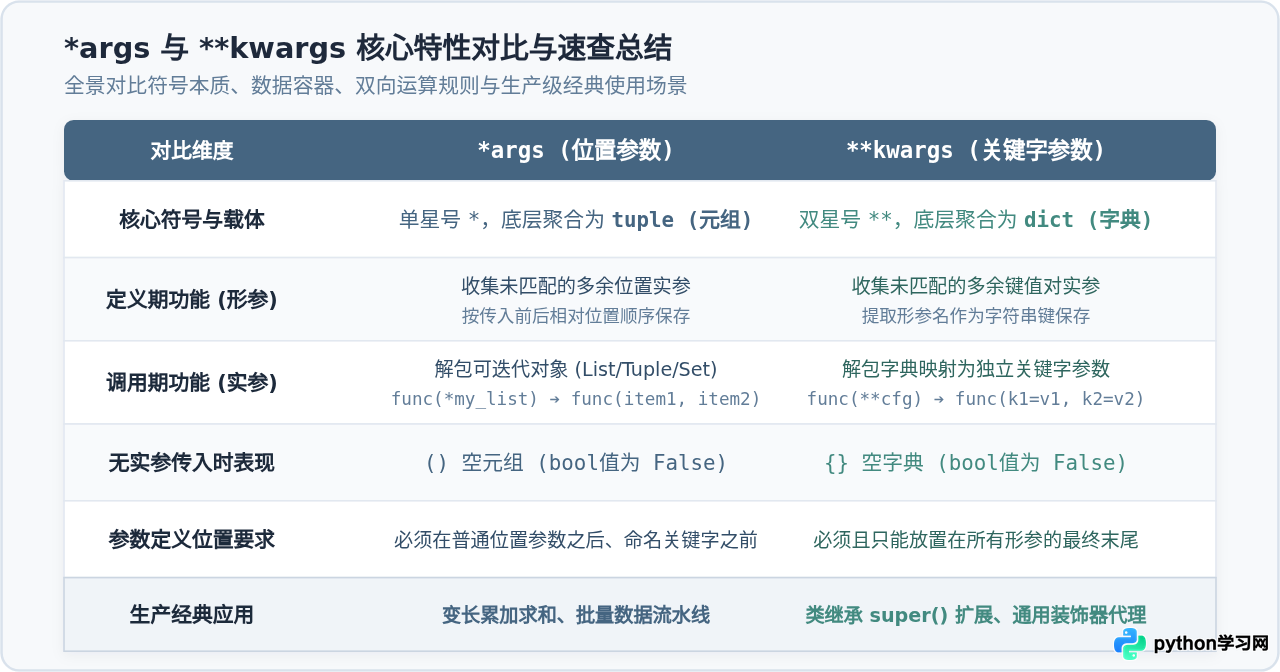
为了便于快速回顾与概念比对,下表系统总结了两者在符号、数据结构、双向功能及经典工程应用场景上的全部差异:
六、高频陷阱与开发防坑指南
在实际工程中使用变长参数时,以下三个细节最容易引发隐蔽的运行时异常:
-
字典解包时的键必须是合法字符串:使用
func(**my_dict)时,my_dict的所有键必须是有效的 Python 标识符字符串(例如数字键{1: "a"}会引发TypeError: keywords must be strings)。 -
命名重复引发冲突:如果函数已经显式定义了具名参数
def f(name, **kwargs),但在解包字典中同样包含了{"name": "Alice"},调用f("Bob", **{"name": "Alice"})会触发TypeError: f() got multiple values for argument 'name'。 -
防范类型提示(Type Hinting)信息衰减:在大型项目中无节制滥用
*args, **kwargs会导致 IDE 自动补全失效。对高可读性要求的核心业务函数,建议优先显式定义形参;若在装饰器中使用,建议结合typing.ParamSpec与typing.TypeVar进行精确类型标注,以兼顾灵活性与静态类型安全性。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









