

Python中怎么从固定格式字符串提取子串?切片实战案例
在Python中处理日期时间、流水编号、传感器报文等固定格式字符串时,字符串切片(s[start:stop])是最轻量、高效的原生提取方式。本文通过图解索引坐标、典型实战案例、常见避坑点与命名切片技巧,系统讲解切片的用法与边界条件。
在 Python 中,当面对位置和长度严格固定的字符串(如标准时间戳、定长流水单号、传感器遥测数据或传统系统导出的定宽文本行)时,最直接、性能最高的方法是使用字符串切片(String Slicing)语法 s[start:stop]。切片属于 Python 底层原生能力,不依赖任何第三方模块,也不需要启动正则表达式引擎,截取开销通常仅在数十纳秒级别。本文从索引坐标体系展开,结合三组典型实战案例,梳理切片的核心语法、常见逻辑陷阱、命名切片对象以及技术选型边界。
一、核心机制:切片语法与索引坐标的对应关系
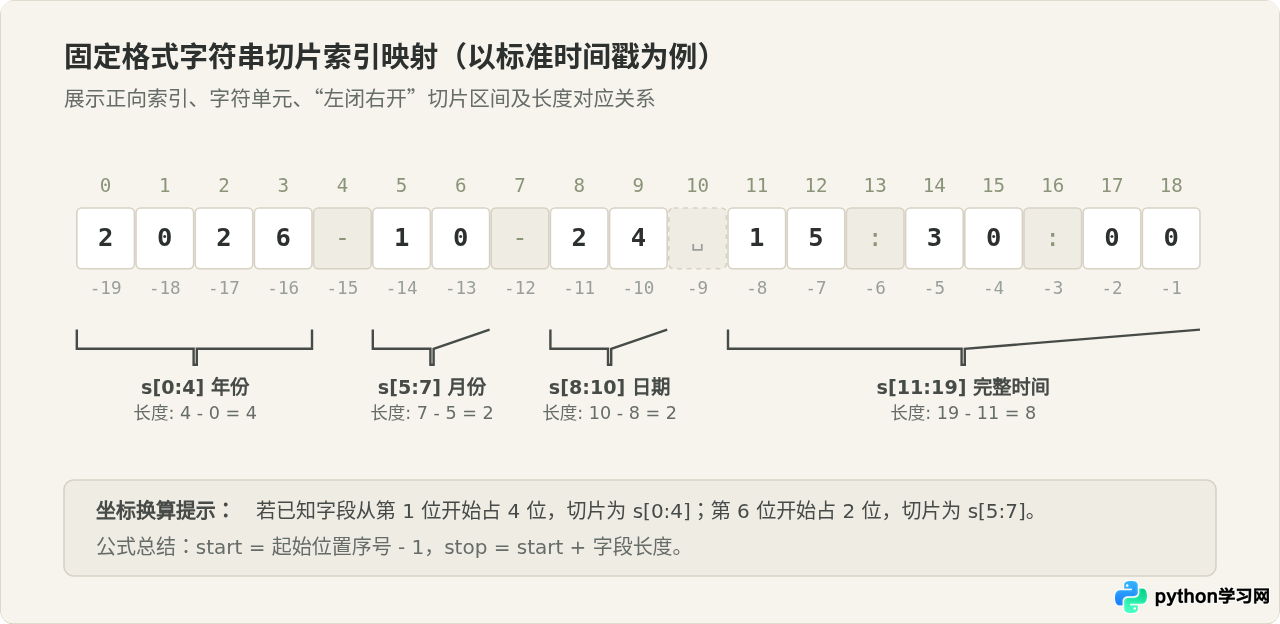
Python 字符串切片的基础语法为 s[start:stop:step]。在固定格式字符串解析中,最常用的是不带步长的双参数形态 s[start:stop]。理解切片并避免截取差位的关键,在于掌握两项基本规则:
- 左闭右开(含头不含尾):截取区间包含索引
start处的字符,但不包含索引stop处的字符。例如s[0:4]只取索引 0、1、2、3 共 4 个字符。 - 长度精确对应:当步长为默认值 1 时,提取出的子串长度永远等于
stop - start。例如stop=7, start=5,提取长度就是7 - 5 = 2。
二、典型实战案例:从三类常见固定格式文本中截取数据
案例 1:标准时间戳字符串解析
日常开发中最常见的固定格式是 ISO 8601 或标准 SQL 时间格式 YYYY-MM-DD HH:MM:SS。其各部分在字符串中的偏移量完全固定:
timestamp_str = "2026-10-24 15:30:00"

# 1. 提取年份:索引 0 到 3,stop 取 4
year = timestamp_str[0:4]

# 2. 提取月份与日期
month = timestamp_str[5:7]
day = timestamp_str[8:10]

# 3. 提取时间部分:小时、分钟、秒
hour = timestamp_str[11:13]
minute = timestamp_str[14:16]
second = timestamp_str[17:19]

# 4. 提取纯日期或纯时间
date_part = timestamp_str[:10]   # 等同于 timestamp_str[0:10]
time_part = timestamp_str[11:]   # 从索引 11 截取至末尾

print(f"日期: {date_part}, 年份: {year}, 月: {month}, 日: {day}")
print(f"时间: {time_part}, 时: {hour}, 分: {minute}, 秒: {second}")

# 示例输出:
# 日期: 2026-10-24, 年份: 2026, 月: 10, 日: 24
# 时间: 15:30:00, 时: 15, 分: 30, 秒: 00
案例 2:工业与金融定长流水号解析
金融清算流水、快递条码或硬件传感器报文常常采用无分隔符的纯定宽布局。以一条长度为 28 位的金融记账报文为例:TXN202610240098A000125000CNY。各字段的物理位置定义如下表:
| 字段名称 | 起始位(1-based) | 占用长度 | 切片语法 s[start:stop] |
提取示例 |
|---|---|---|---|---|
| 业务类别 | 1 | 3 | record[0:3] |
"TXN" |
| 交易日期 | 4 | 8 | record[3:11] |
"20261024" |
| 终端编码 | 12 | 4 | record[11:15] |
"0098" |
| 账户类别 | 16 | 1 | record[15:16] |
"A" |
| 金额(分) | 17 | 9 | record[16:25] |
"000125000" (1250.00元) |
| 币种代码 | 26 | 3 | record[25:28] |
"CNY" |
结合 Python 处理该定长记录并完成结构化转化的完整脚本如下:
record = "TXN202610240098A000125000CNY"

# 统一提取并按需转型
parsed_data = {
    "biz_type": record[0:3],
    "txn_date": record[3:11],
    "terminal_id": record[11:15],
    "account_type": record[15:16],
    "amount_yuan": int(record[16:25]) / 100.0,  # 转换为实际元
    "currency": record[25:28]
}

print(parsed_data)
# 示例输出:
# {'biz_type': 'TXN', 'txn_date': '20261024', 'terminal_id': '0098', 'account_type': 'A', 'amount_yuan': 1250.0, 'currency': 'CNY'}
案例 3:利用负向索引提取固定后缀与尾部校验位
当字符串前半部分长度可能略有浮动,但尾部字段固定时,负向索引切片能大幅简化计算。例如固定提取最后 4 位校验码,或者处理带有定长后缀的文件标识:
raw_sn = "DEVICE-NODE-B12-CHK88A1"

# 提取最后 5 位校验标识 "CHK88A1" 中的最后 4 位校验位 "88A1"
checksum = raw_sn[-4:]

# 提取倒数第 7 位到倒数第 4 位的校验前缀 "CHK"
chk_tag = raw_sn[-7:-4]

print(f"校验前缀: {chk_tag}, 校验码: {checksum}")
# 示例输出:
# 校验前缀: CHK, 校验码: 88A1
三、固定格式字符串切片的安全流程
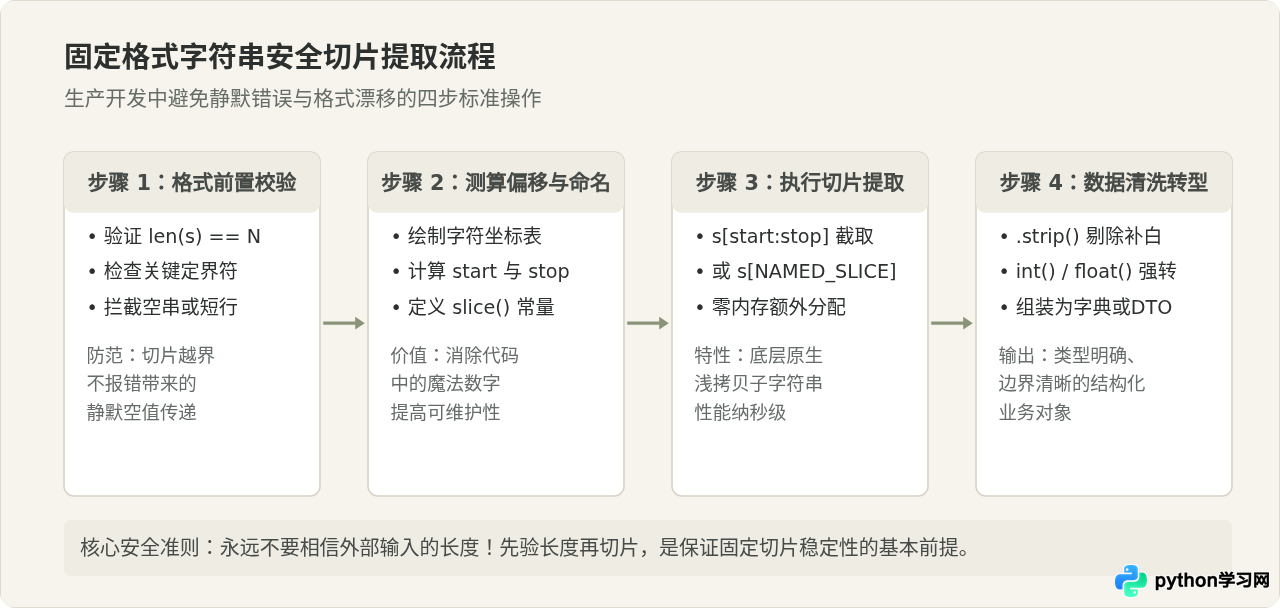
虽然切片操作语法极其简洁,但在生产环境中直接写死索引极易引发两类隐患:一是未做长度校验导致空串静默传递;二是直接在业务逻辑中散落大量数字下标(魔数),导致后期格式微调时极难维护。规范的提取流程应当包含以下四步:
四、工程化提效:利用 slice() 对象消除“魔法数字”
在批量处理成千上万行定宽文本时,如果在循环体内反复写 line[0:3]、line[3:11],代码不仅可读性差,而且一旦格式字段变更,维护者需要在茫茫代码中寻找数字替换,极易出错。
Python 提供了内置函数 slice(start, stop[, step]),可以把切片范围封装为独立的对象,赋予其具备业务含义的名字:
# 1. 集中定义字段切片规范(命名切片对象)
FLD_BIZ_TYPE = slice(0, 3)
FLD_TXN_DATE = slice(3, 11)
FLD_TERMINAL = slice(11, 15)
FLD_AMOUNT   = slice(16, 25)

# 2. 批量处理固定格式数据行
raw_records = [
    "TXN202610240098A000125000CNY",
    "TXN202610240102A000086500CNY",
    "REF202610240098B000012000CNY"
]

results = []
for line in raw_records:
    # 基础前置检查
    if len(line) < 28:
        continue

    # 直接使用切片对象作为下标
    item = {
        "type": line[FLD_BIZ_TYPE],
        "date": line[FLD_TXN_DATE],
        "terminal": line[FLD_TERMINAL],
        "amount": int(line[FLD_AMOUNT]) / 100.0
    }
    results.append(item)

print(f"成功解析 {len(results)} 条记录,首条金额: {results[0]['amount']}")
# 示例输出:
# 成功解析 3 条记录,首条金额: 1250.0slice 对象具备 .start、.stop 和 .step 只读属性。如果需要编写通用校验函数,可以直接从切片对象中获取字段长度 fld.stop - fld.start,实现了元数据与执行逻辑的解耦。
五、容易混淆的认知与避坑辨析
1. 为什么“切片越界”不报错?
在 Python 中,单字符索引 s[i] 当 i >= len(s) 时会抛出 IndexError: string index out of range。但切片 s[start:stop] 的行为完全不同:切片具有优雅降级(Graceful Degradation)特性,越界的索引会被自动限制在字符串两端,永远不会抛出 IndexError。
text = "Python"

# 越界切片测试
print(repr(text[10:20]))  # 输出: '' (超出范围直接返回空字符串)
print(repr(text[2:100]))   # 输出: 'thon' (自动截断至字符串末尾)
print(repr(text[-50:3]))   # 输出: 'Pyt' (负索引越界自动截断至字符串头部)
这个特性在提取可选后缀时非常方便,但在固定格式解析中却是一把双刃剑:如果上游传来的字符串因截断只有 10 位,而你尝试提取 s[16:25],Python 不会报错,而是默默返回 ""。紧接着后续的 int("") 就会抛出 ValueError,或者将空值存入数据库造成隐蔽故障。因此,固定格式必须配合前置长度检查。
2. 步长为负数时的起止反转陷阱
当指定第三个参数步长 step < 0 时,切片的扫描方向会从“从左向右”变为“从右向左”。此时 start 必须位于 stop 的右侧(即 start > stop),否则会直接返回空字符串:
s = "ABCDEF"

# 正确的反向切片:从索引 4 ('E') 向左截取到索引 1 ('B'),不包含索引 1
print(s[4:1: -1])   # 输出: 'EDC'

# 常见笔误:如果依然写成 start < stop,由于无法反向步进,将得到空串
print(repr(s[1:4: -1]))  # 输出: ''

# 常用简写:整串反转
print(s[::-1])      # 输出: 'FEDCBA'
六、方案选型:切片、split() 还是 正则表达式?
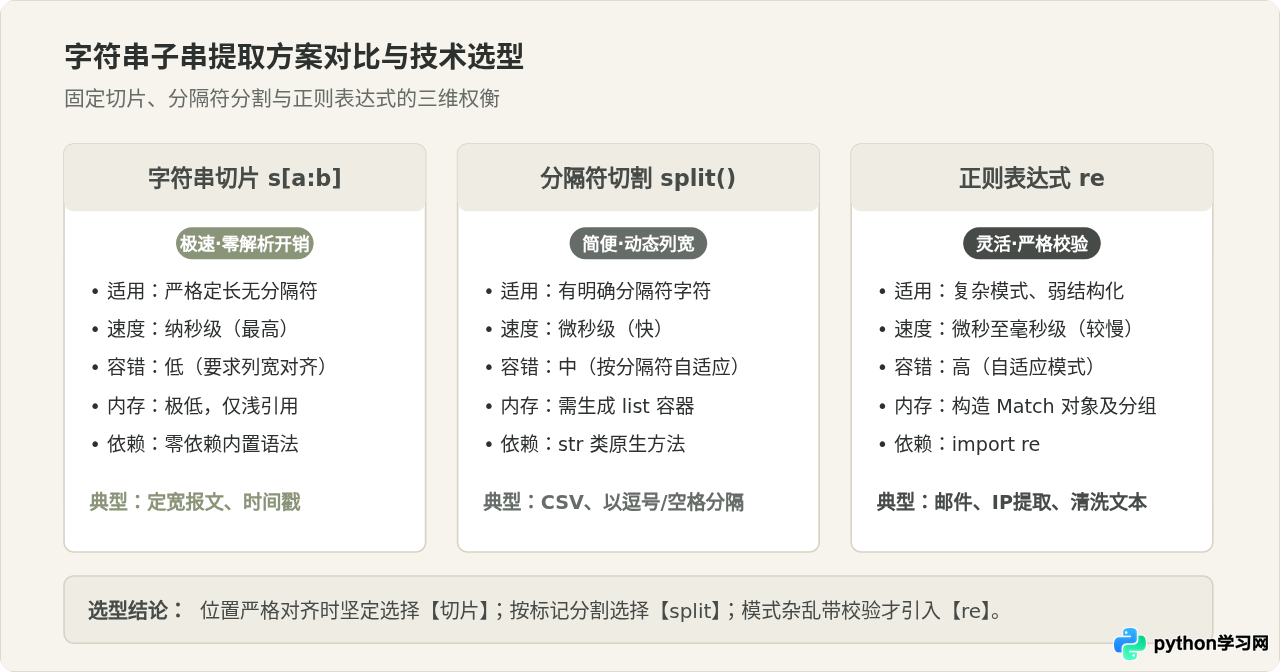
并不是所有子串提取任务都适合使用切片。选择哪种技术方案,完全取决于输入数据的结构特征:
七、实战要点全景总结
通过切片从固定格式字符串提取子串,是 Python 开发者必须熟练掌握的基本功。在实际应用中,可将其归纳为以下四项核心要点:
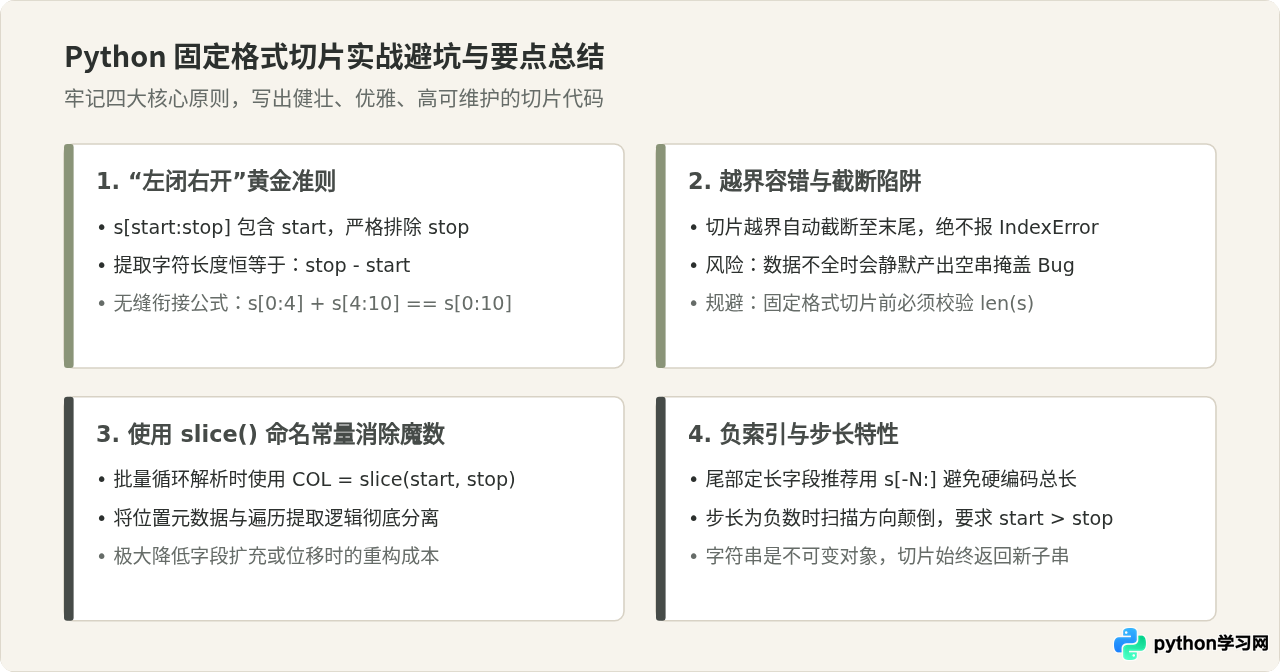
掌握以上原理和方法后,面对日期时间解析、接口定宽校验码拆解等任务时,便能以最优雅的代码和最高的运行效率,准确完成固定格式子串的提取与清洗。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









