

Python文件读写出现UnicodeDecodeError乱码怎么办
深入解析Python读写文件时出现UnicodeDecodeError乱码的核心原因、诊断排查步骤与完整修复方案,涵盖GBK、GB18030、UTF-8-SIG及工程防御最佳实践。
UnicodeDecodeError,最核心的解决路径是在调用 open() 函数时显式指定与文件实际存储编码一致的 encoding 参数。多数中文环境下的报错,只需将读取参数指定为 encoding='gb18030'(兼容 GBK 与老旧系统文本)或 encoding='utf-8-sig'(清除 Windows 导出的 BOM 头)即可彻底修复,无需盲目猜测或删除数据。
一、认识 UnicodeDecodeError:报错的根源与解码机制
很多开发者在初学或跨平台迁移 Python 脚本时,常会遇到类似如下的典型报错:
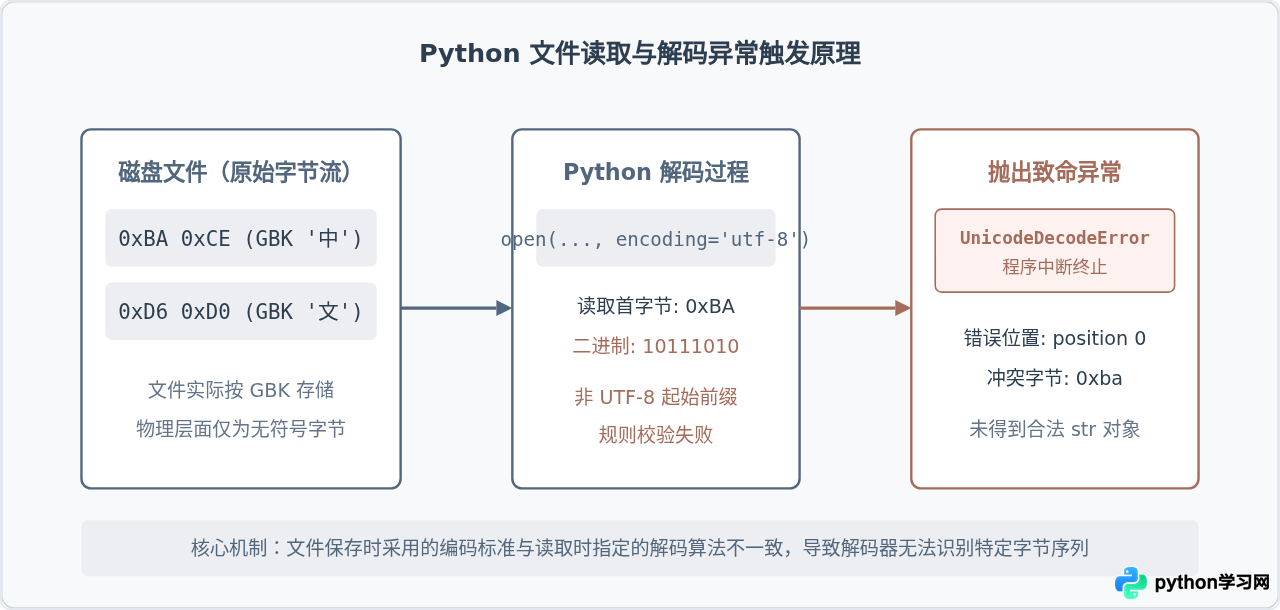
UnicodeDecodeError: 'utf-8' codec can't decode byte 0xba in position 0: invalid start byte
要解决这个报错,首先需要明白 Python 3 的字符模型。计算机硬件本身只能存储二进制字节序列(bytes),而我们在代码中看到的文本是字符串(str)。从磁盘上的二进制字节转化为内存中可阅读的字符,必须依赖某种特定的“编码规则字典”。这个由字节转字符的过程就叫做解码(Decode);反之,由字符转为字节保存的过程称为编码(Encode)。
当代码抛出 UnicodeDecodeError 时,说明 Python 正在使用的解码器遇到了一串不符合该编码规则的字节。例如上面的报错信息表明:Python 正在尝试使用 UTF-8 规范去解析文件,但在第 0 个字节处遇到了 0xba。在 UTF-8 的二进制规范中,以二进制 10111010(即十六进制 0xba)开头的单字节是绝对非法的起始字节,于是解码器立即中断并抛出异常。
出现这种冲突的根源,通常是代码中未显式指定 encoding 参数,导致 Python 采用了当前操作系统的默认编码。在 Windows 简体中文版中,系统默认编码往往是代码页 936(即 GBK/CP936),而在 macOS 和 Linux 环境中,系统默认编码是 UTF-8。一旦文件来源平台与读取平台的默认设置不匹配,或者在 UTF-8 环境中读取了 Windows 导出的 GBK 文本,乱码与报错就会随之发生。
二、排查步骤:逐步定位真实编码
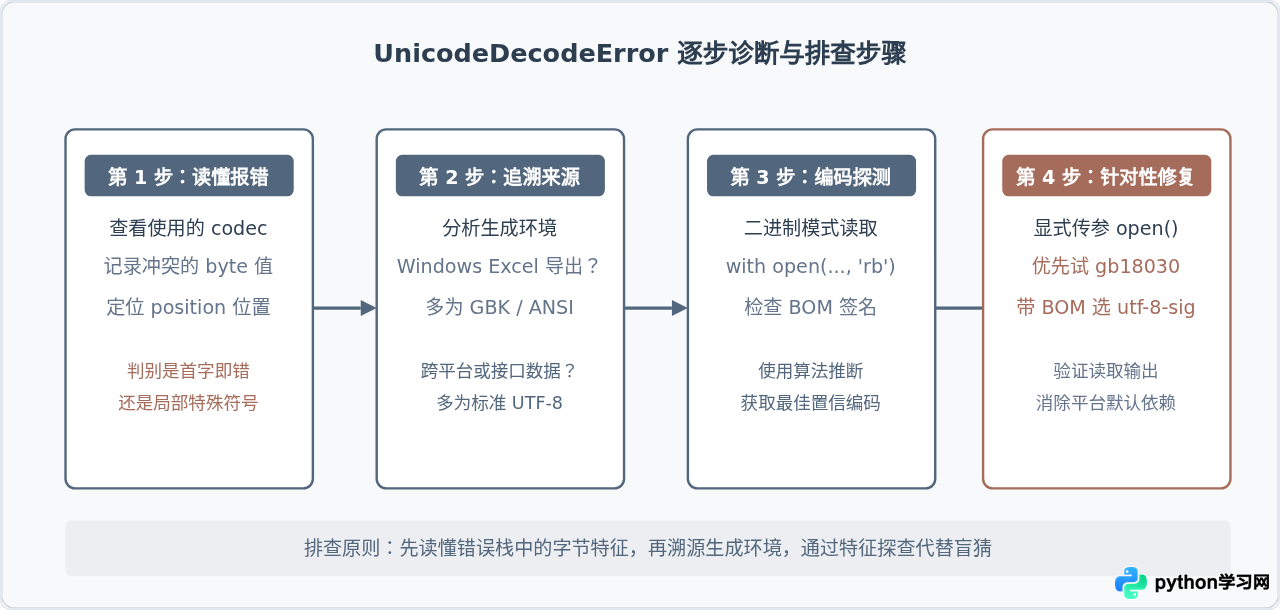
面对乱码报错,切忌在代码中随机尝试填入编码名称。建议遵循以下四个清晰步骤进行系统排查:
-
第一步:提取报错上下文
仔细观察报错信息中的三个核心要素:尝试使用的解码器名称(如'utf-8'或'ascii')、冲突字节(如0xba)、以及冲突发生的位置(如position 0或具体行数)。如果冲突发生在 position 0,往往是整个文件的格式完全不符合预期;如果冲突发生在文本中间,则可能是混杂了生僻符号或非纯文本内容。 -
第二步:核实文件产生背景与环境
分析目标文件的来源:- 由 Windows 早期软件、记事本默认另存、或中文版 Excel 导出的 CSV 文件,通常是
GBK或ANSI (CP936)。 - 现代 IDE(VS Code、PyCharm)、Web 接口下载、Git 仓库拉取的数据文件,绝大多数为
UTF-8。 - 部分由 Windows 软件生成的 UTF-8 文件,在文件头部会包含 3 个字节的 BOM(
\xef\xbb\xbf),如果使用标准 UTF-8 读取容易导致首字符异常。
- 由 Windows 早期软件、记事本默认另存、或中文版 Excel 导出的 CSV 文件,通常是
-
第三步:使用二进制模式或探查库分析头部特征
若无法从来源确定编码,可以直接使用 Python 的二进制模式读取前几十个字节进行验证,或者借助成熟的第三方推测库:
# 方案 A:直接以二进制方式读取前 16 个字节查看原始内容
with open("target.txt", "rb") as f:
    raw_bytes = f.read(16)
    print("文件原始十六进制头部:", raw_bytes.hex())

# 方案 B:使用 charset-normalizer(推荐)进行概率探测
from charset_normalizer import from_path

results = from_path("target.txt")
best_match = results.best()
if best_match:
    print("探测到的编码格式:", best_match.encoding)
    print("置信度:", best_match.coherence)
charset-normalizer 是现代 Python 社区中替代老旧 chardet 的高效库,它不仅性能更优,而且对中文多字节字符集(GB18030、Big5、UTF-8)的判定准确率极高。
三、常见场景与标准修复代码
场景 1:最常见的中文 Windows 文件(GBK / GB18030)
在国内业务开发中,大部分由 Windows 桌面软件或中文 Excel 导出的纯文本、CSV 文件采用的是国标系列字符集。如果直接使用 open('data.csv') 在 Linux 服务器或 macOS 上读取,由于环境默认编码为 UTF-8,就会立即抛出 UnicodeDecodeError。
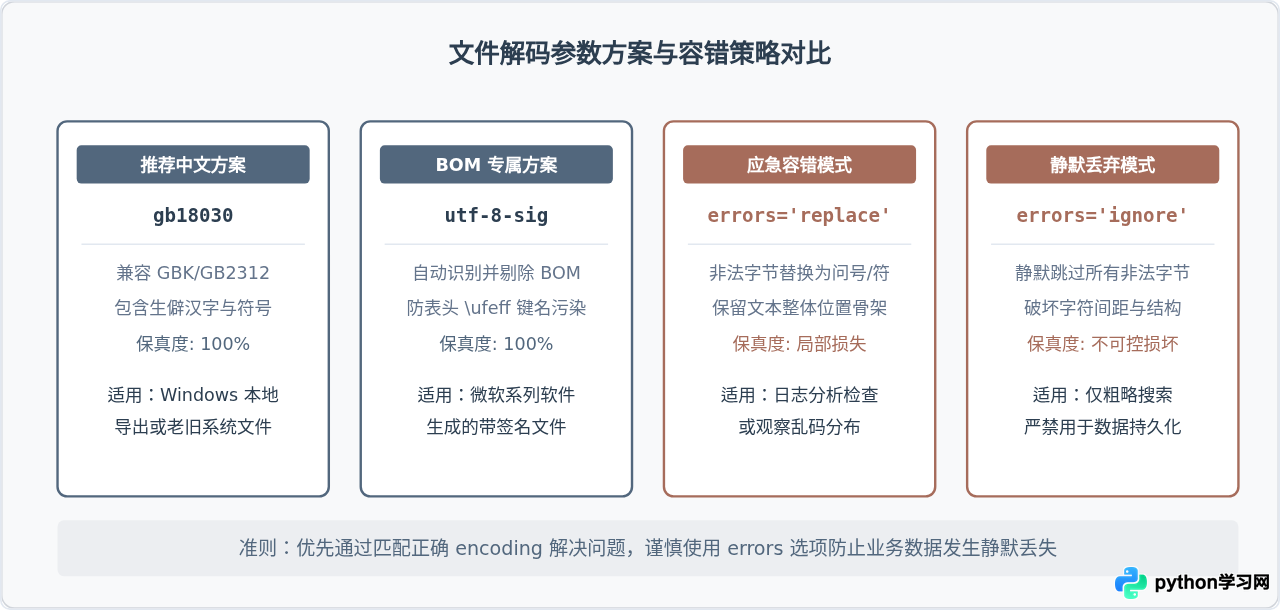
推荐做法:在 open() 中显式传入 encoding='gb18030'。
# 标准中文兼容读取方式
with open("data.csv", "r", encoding="gb18030") as f:
    for line in f:
        print(line.strip())
gb18030 而不是 gbk?GB18030 是国家强制标准的超集,它完全向下兼容 GBK 和 GB2312,同时收录了包含生僻汉字(如人名、古籍字、地名专用字)及少数民族字符在内的数万个符号。如果仅使用 encoding='gbk',一旦遇到生僻字依然会报错;而使用 gb18030 则能确保最大程度的解码稳定性。
场景 2:带 BOM 头的 UTF-8 文件(UTF-8-SIG)
部分 Windows 记事本或早期软件在保存 UTF-8 文件时,会在文件开头添加不可见的 3 个字节标识(十六进制为 EF BB BF),即 Byte Order Mark(BOM)。
如果你使用 encoding='utf-8' 读取,Python 不会自动去除这三个字节,通常会导致读取出来的第一行首个键名多出奇怪的 \ufeff,甚至在解析 JSON/CSV 时引发语法错误;而在某些特定解析流程中,也会引发解码异常。
推荐做法:使用 Python 内置的 utf-8-sig 编码:
# 自动识别并跳过文件开头的 BOM 标记
with open("windows_utf8.csv", "r", encoding="utf-8-sig") as f:
    header = f.readline()
    print("表头无 BOM 污染:", repr(header))
utf-8-sig 具有双向自适应特性:读取时如果存在 BOM 则自动剥离,若没有 BOM 则按常规 UTF-8 处理;写入时则会自动补齐 BOM 标记。
场景 3:包含损坏字节或混合编码的容错处理
在爬虫抓取、网络传输或日志采集等场景中,文本流可能因截断或网络丢包而混杂个别损毁字节。如果业务要求程序不能因个别字符崩掉,可以通过 errors 参数控制解码器的容错策略:
# 策略 A:替换非法字节(推荐用于数据分析和定位)
with open("mixed_log.txt", "r", encoding="utf-8", errors="replace") as f:
    content = f.read()
    # 非法字节会被替换为标准占位符 '' (U+FFFD)

# 策略 B:直接忽略跳过非法字节(慎用,仅限非结构化文本粗略查看)
with open("mixed_log.txt", "r", encoding="utf-8", errors="ignore") as f:
    content = f.read()
    # 损毁字节直接被抛弃,文本整体长度会发生变动
注意:errors='ignore' 存在导致数据隐蔽丢失的风险,如果用于 JSON 或数据入库场景,可能导致整个数据结构错位。应优先寻找正确的 encoding,切勿将容错参数作为常规开发时的“万能补丁”。
四、预防策略与编码规范总结
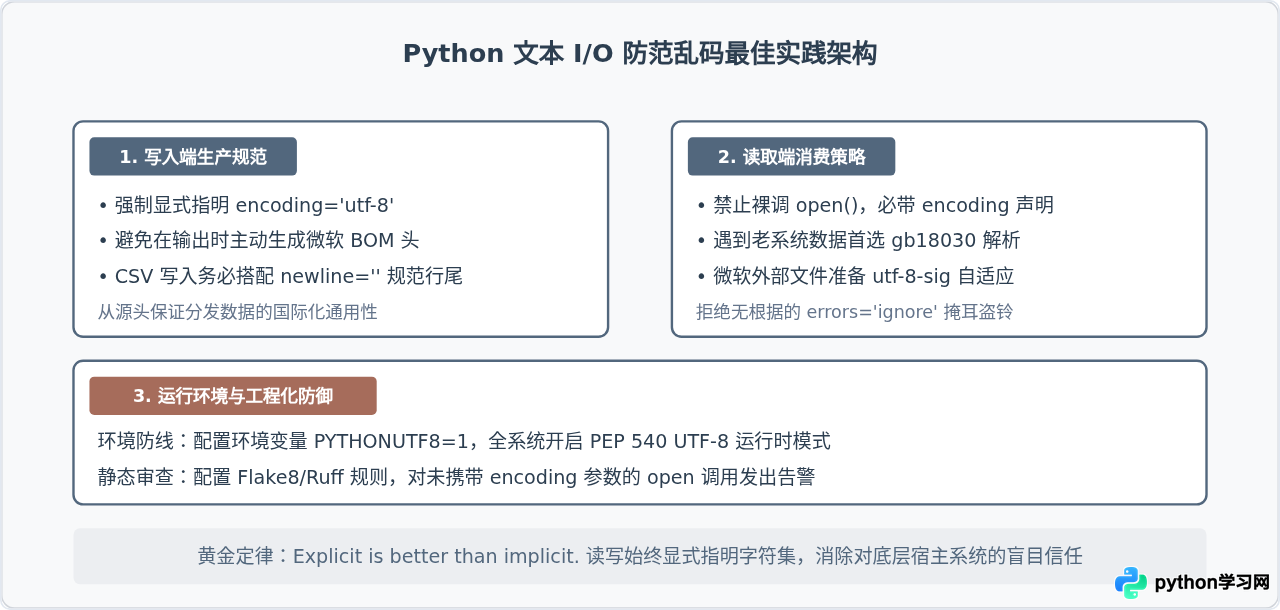
排查单次报错只是治标,在工程开发中建立规范、从源头杜绝乱码才是长远之策。以下是三条在团队协作与生产环境中必须遵守的最佳实践:
-
第一原则:永远显式传参,杜绝隐式调用。
Python 哲学强调 "Explicit is better than implicit"(明了胜于晦涩)。在所有调用open()的代码中,无论是读取还是写入,都必须明确写出encoding="utf-8"。绝不依赖运行机器的默认环境。 -
统一团队与部署环境的 UTF-8 Mode。
从 Python 3.7 开始引入了 PEP 540(UTF-8 模式)。可以通过设置环境变量PYTHONUTF8=1,强制 Python 在所有平台上忽略操作系统的本地 locale,默认使用 UTF-8 进行所有文本 I/O 操作。在 Dockerfile 或 CI/CD 流水线中加入该配置,能直接免疫绝大多数跨平台乱码问题。 -
写入文本时保持清洁无 BOM。
在数据落盘或向接口输出数据时,统一使用标准的无 BOMUTF-8。对于 CSV 文件,配合newline=''保持换行符跨平台一致性,避免 Windows/Unix 换行符与编码双重污染。
五、总结
遇到 UnicodeDecodeError 时无须慌张,它只是在提醒你:当前的解码器与文件的实际存储字节集发生了偏离。通过检查报错信息中的字节特征、回溯文件生成平台、使用 charset-normalizer 进行特征探查,并针对性地为 open() 传入 encoding='gb18030' 或 encoding='utf-8-sig',即可快速恢复正常读取。在日常编码中坚持显式指定 encoding,是保证 Python 程序跨平台健壮运行的最有效习惯。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









