

Python正则表达式代码示例:提取文本中的邮箱与电话
本文详细介绍如何使用 Python 标准库 re 模块通过正则表达式高效提取文本中的邮箱地址与电话号码,包含清晰的结构拆解、完整代码示例、常见问题排查与注意事项。
在处理网页爬虫抓取内容、客服工单、用户留言或日志文本时,非结构化文本中往往混杂着关键联系方式。直接使用 Python 标准库内置的 re 模块,搭配针对性设计的正则表达式,可以在无需依赖任何第三方库的前提下,精确且批量地抽取出文本中的电子邮箱和电话号码。
re.finditer() 或 re.findall() 遍历搜索,再通过简单的后处理清洗非目标标点,即可获得干净规整的联系方式列表。
一、快速上手:5行代码提取基础示例
为了直观展示效果,我们可以先看一段包含混合信息的文本以及基础的提取代码:
import re

text = """
如有合作咨询,请联系张经理:zhang_hr@techcorp.com 或 138-1234-5678。
技术支持邮箱:support.dev@open-source.org,固话咨询热线:010-87654321(周一至周五)。
外部客户也可发送邮件至 sales101@partner.com.cn 进行登记。
"""

# 基础匹配模式
email_pattern = r'[a-zA-Z0-9_.+-]+@[a-zA-Z0-9-]+\.[a-zA-Z0-9-.]+'
phone_pattern = r'(?:(?:\+86\s*)?1[3-9]\d{9}|0\d{2,3}-?\d{7,8})'

emails = re.findall(email_pattern, text)
phones = re.findall(phone_pattern, text)

print("提取到的邮箱:", emails)
print("提取到的电话:", phones)
执行该脚本后,控制台会输出提取到的三个邮箱以及两个格式不同的电话号码。接下来,我们逐一深入剖析邮箱与电话的具体正则构造与边界边界处理细节。
二、提取电子邮箱的正则表达式构建
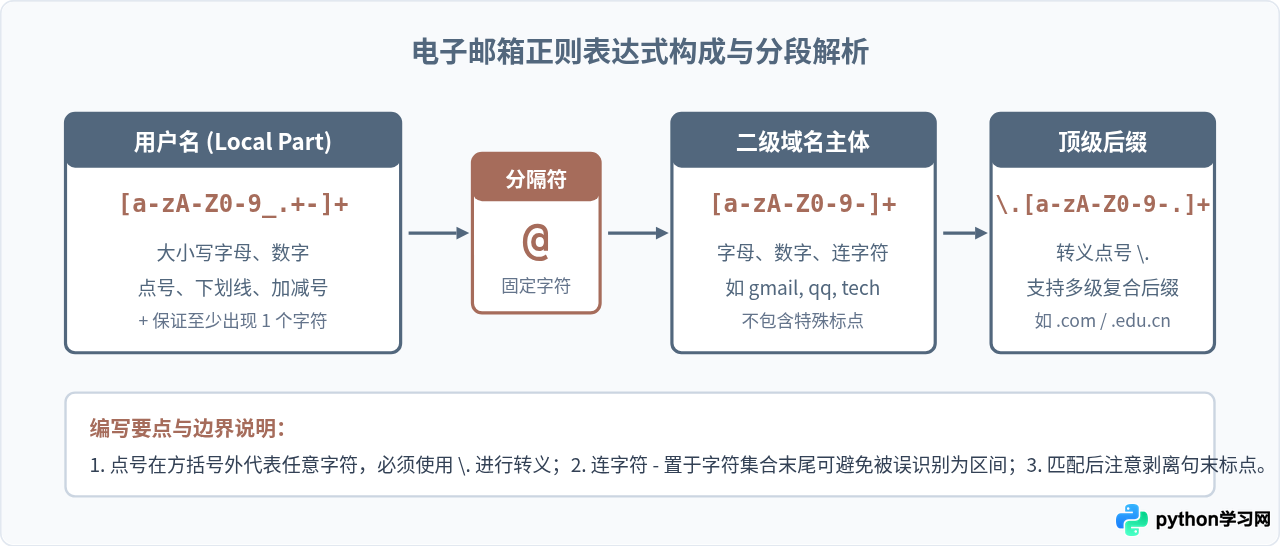
一个标准的电子邮箱主要由三部分构成:用户名(Local Part)、@ 符号 以及 域名部分(Domain Part)。在实际业务文本中,邮箱用户名常常包含点号 .、下划线 _、连字符 - 甚至加号 +;域名部分则可能包含多级后缀(如 .com.cn 或 .edu.cn)。
代码实现与末尾非目标字符剥离
在中文自然语言中,邮箱末尾经常紧随逗号、句号、右括号或分号(如 user@domain.com。)。单纯用字符类匹配时容易将句号一并吸纳。因此,建议在匹配后统一使用 rstrip(".,;!?。,;?!)") 剔除粘连标点:
def extract_clean_emails(raw_text):
    # 邮箱正则模式
    pattern = r'[a-zA-Z0-9_.+-]+@[a-zA-Z0-9-]+\.[a-zA-Z0-9-.]+'
    raw_matches = re.findall(pattern, raw_text)

    clean_list = []
    for item in raw_matches:
        # 清除结尾可能粘连的标点符号
        cleaned = item.rstrip('.,;:!?。,;:!?))》”"')
        if cleaned and cleaned not in clean_list:
            clean_list.append(cleaned)
    return clean_list

# 测试示例
sample = "反馈请寄至 info@example.com,备用信箱 admin-ops@cloud.service.cn;测试邮箱 test+work@dev.io。"
print(extract_clean_emails(sample))
# 期望输出: ['info@example.com', 'admin-ops@cloud.service.cn', 'test+work@dev.io']
三、提取电话号码:手机号与座机分支匹配
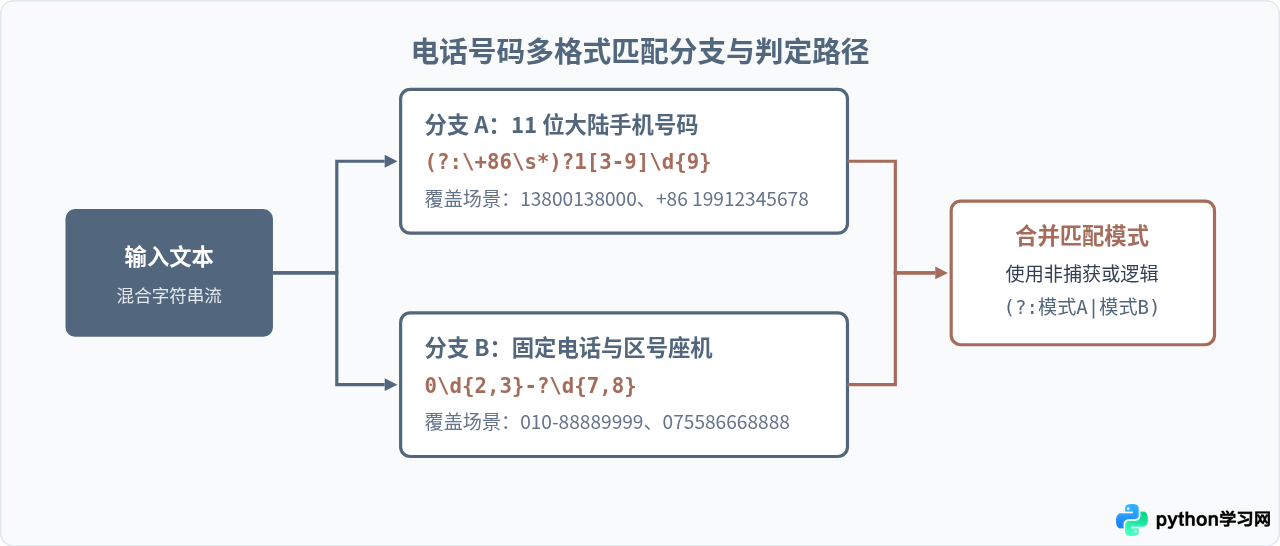
中文文本中的电话主要呈现两种形态:
- 中国大陆移动电话(11位):以
1开头,第二位通常为3-9,可能带有国际区号前缀(如+86、+86-或0086),中间可能带有连字符或空格。 - 固定电话(座机):以
0开头的3到4位区号(如010、021、0755),后接7到8位本地号码,中间可能用横线-隔开。
电话号码提取代码与格式标准化
提取电话时需要特别注意非捕获组 (?:...) 的使用。如果误写为普通括号 (...),re.findall 将只返回括号内部的内容,而非匹配到的整个电话串。
def extract_phones(raw_text):
    # 使用 (?:...) 构成非捕获组,确保 findall 返回完整匹配项
    mobile_re = r'(?:\+86\s*)?1[3-9]\d{9}'
    landline_re = r'0\d{2,3}-?\d{7,8}'
    combined_re = rf'(?:{mobile_re}|{landline_re})'

    matches = re.findall(combined_re, raw_text)

    # 统一清洗格式:去除多余空格与规范化
    normalized = []
    for p in matches:
        p_clean = p.strip()
        if p_clean not in normalized:
            normalized.append(p_clean)
    return normalized

text_sample = "售后电话:021-61234567,手机联系人:+86 13987654321 或 18600001111。"
print(extract_phones(text_sample))
# 期望输出: ['021-61234567', '+86 13987654321', '18600001111']
四、操作步骤:构建完整的联系信息提取器
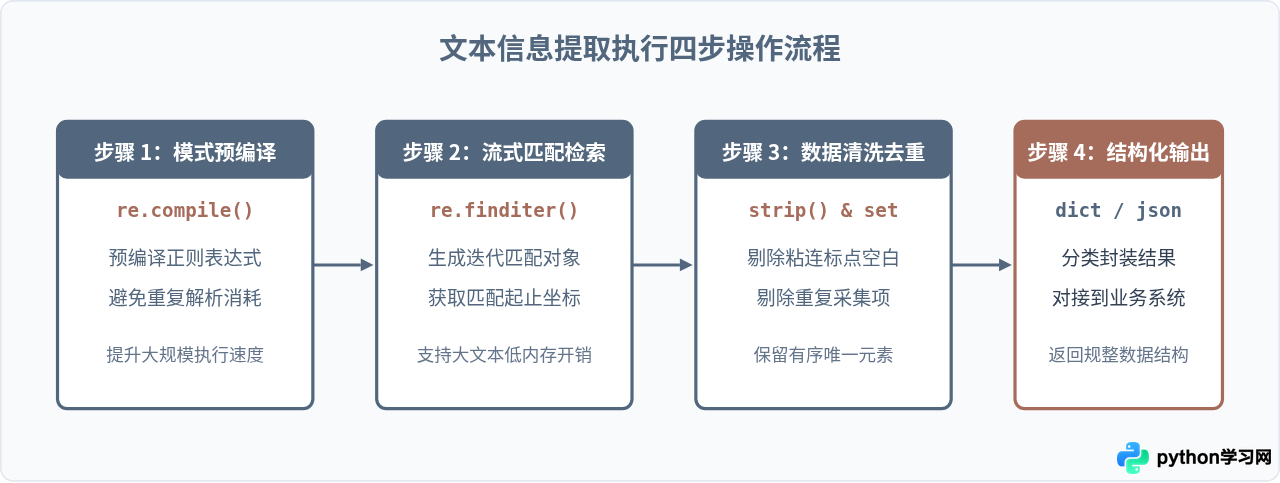
在工程项目中,我们通常将正则对象预先编译,并封装为通用工具函数。标准化提取流程主要包含以下四个步骤:
完整且可复用的生产级代码示例
下面给出一段整合后的完整 Python 函数,可以直接复制到项目中用于文本清洗模块:
import re

class ContactExtractor:
    """文本联系方式提取器"""

    def __init__(self):
        # 预编译邮箱模式
        self.email_re = re.compile(
            r'[a-zA-Z0-9_.+-]+@[a-zA-Z0-9-]+\.[a-zA-Z0-9-.]+'
        )
        # 预编译电话模式(手机号 + 座机号)
        self.phone_re = re.compile(
            r'(?:(?:\+86\s*)?1[3-9]\d{9}|0\d{2,3}-?\d{7,8})'
        )
        self.trailing_puncts = '.,;:!?。,;:!?))》”"\' \t\n'

    def extract(self, text: str) -> dict:
        """从字符串中提取唯一的邮箱和电话列表"""
        if not text or not isinstance(text, str):
            return {"emails": [], "phones": []}

        # 1. 提取并清洗邮箱
        raw_emails = self.email_re.findall(text)
        emails = []
        for item in raw_emails:
            clean = item.rstrip(self.trailing_puncts)
            if clean and clean not in emails:
                emails.append(clean)

        # 2. 提取并清洗电话
        raw_phones = self.phone_re.findall(text)
        phones = []
        for item in raw_phones:
            clean = item.strip(self.trailing_puncts)
            if clean and clean not in phones:
                phones.append(clean)

        return {
            "emails": emails,
            "phones": phones
        }

# 验证代码执行效果
if __name__ == "__main__":
    doc = """
    【商务合作公告】
    请有意向的供应商将材料发送至: vendor-bid@enterprise-group.com.cn。
    紧急联络人李总监手机: +86 13800138000;商务部座机专线: 021-58889999。
    另附抄送邮件: compliance_check@partner.org!
    """

    extractor = ContactExtractor()
    result = extractor.extract(doc)

    print("提取结果:")
    print("邮箱:", result["emails"])
    print("电话:", result["phones"])
控制台输出示例:
提取结果:
邮箱: ['vendor-bid@enterprise-group.com.cn', 'compliance_check@partner.org']
电话: ['+86 13800138000', '021-58889999']
五、关键陷阱与进阶优化注意事项
在实际工程落地过程中,许多初学者经常会遇到匹配结果不全、返回多余元组或执行性能低下的问题。掌握以下核心规则能够避免绝大多数常见错误。
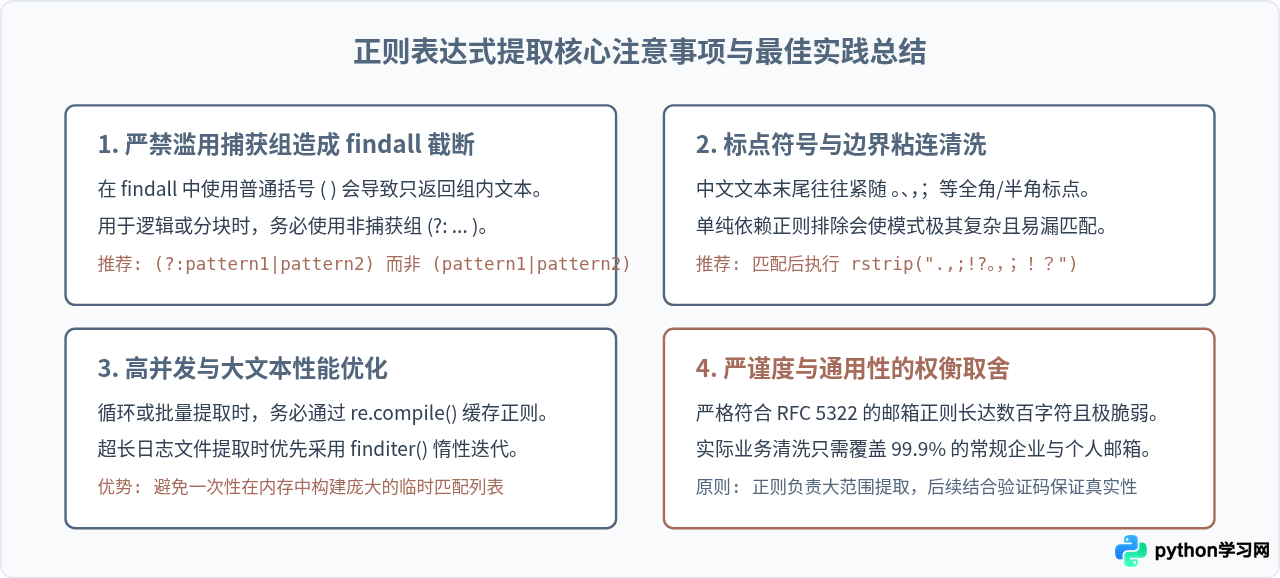
核心排查对比表
| 常见问题表现 | 背后的根本原因 | 正确修复方案 |
|---|---|---|
re.findall 只返回部分字符串或空元组 |
在正则中使用了捕获组 (),改变了 findall 的默认返回行为 |
将用于逻辑聚合的括号改写为非捕获组 (?:...) |
| 提取的邮箱末尾带有中文句号或逗号 | 字符类中的 [a-zA-Z0-9-.] 允许点号,若文本句末为点号会被误吞 |
匹配结果后统一调用 rstrip() 剥离边缘非格式标点 |
| 大批量文本处理时程序运行缓慢 | 在循环体内部反复调用 re.findall("...", text) 导致多次重复语法树解析 |
提前在循环体外使用 re.compile() 生成预编译对象复用 |
| 将普通连续11位数字识别为手机号(如订单号) | 正则仅校验了数字位数,未对首位数字进行范围约束 | 严格限制首位为 1,第二位为 [3-9],必要时增加单词边界 \b |
通过合理结合上述正则表达式、编译缓存机制与后缀标点清洗流程,即可稳健地应对大部分真实应用场景中的邮箱和电话批量提取任务。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









