

Python按条件筛选并读取CSV特定行
本文系统讲解在Python中按条件筛选并读取CSV特定行的核心技术,深入解析内置csv模块流式过滤与pandas向量化筛选的适用场景、代码实现与常见陷阱。
在 Python 中按条件筛选并读取 CSV 特定行,核心在于确定“何时进行过滤”以及“采用何种内存开销模型”。根据实际业务场景和数据规模,主要有两种成熟的解决路径:使用 Python 内置的 csv 标准库进行流式逐行判断(内存占用极低、零第三方依赖),或者使用第三方科学计算库 pandas 的向量化条件索引与分块读取(语法简洁、处理复杂计算效率高)。根据数据量与运行环境选择匹配的方案,能够有效避免内存溢出并显著提高执行效率。
一、使用内置 csv 模块流式过滤(轻量与大文件首选)
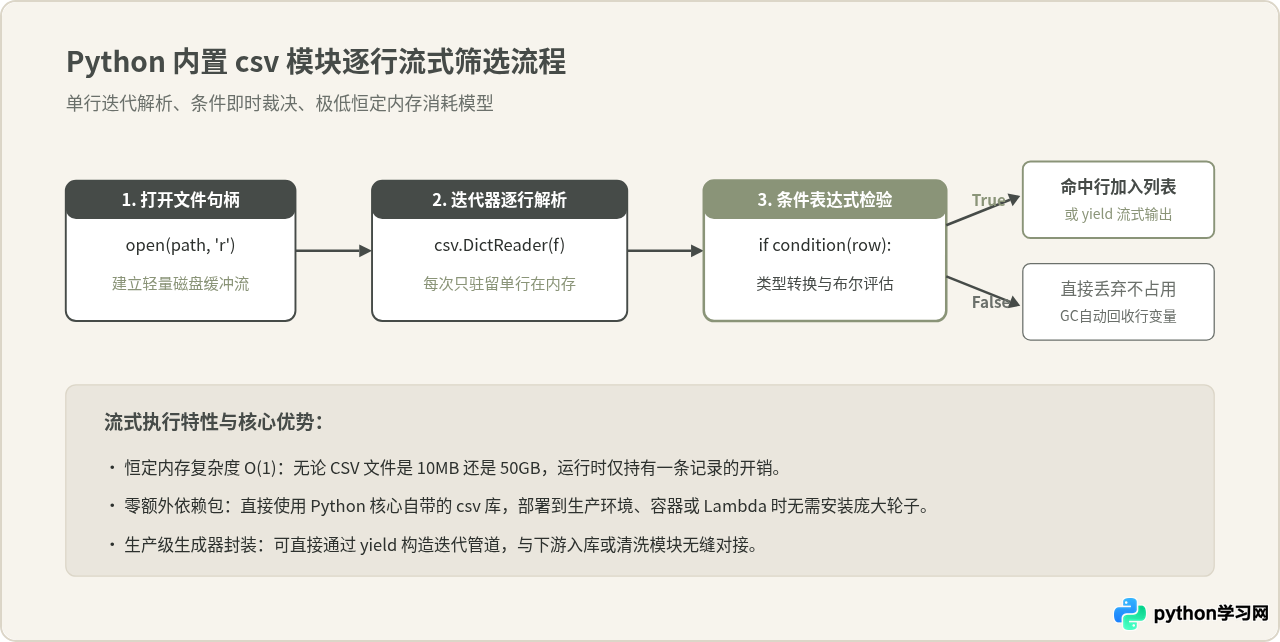
当处理的文件体积从几十兆到数十吉字节(GB),或者运行在对第三方依赖有严格限制的轻量级脚本环境时,标准库 csv 是首选工具。该方案的核心机制是流式迭代(Streaming Iteration):通过生成器按行从磁盘缓冲区读取并解析单行数据,完成条件判定后即时保留或丢弃,整个执行过程中内存占用恒定保持在单行级别。
1. 基于 csv.DictReader 按列名过滤
使用 csv.DictReader 可以将每行直接映射为字典,以列名作为键,极大增强了代码的可读性与稳健性。假定我们有一个 users.csv 文件,包含 user_id、city、age、status 等列,要求筛选出城市为“北京”且年龄大于等于 30 岁的有效用户:
import csv

def filter_csv_by_condition(file_path):
    matched_rows = []
    # 使用 utf-8-sig 兼容可能包含 UTF-8 BOM 头的 CSV 文件
    with open(file_path, mode='r', encoding='utf-8-sig', newline='') as f:
        reader = csv.DictReader(f)
        for row in reader:
            # 注意:CSV 读入的内容全为字符串,数值比较前必须显式转换类型
            try:
                age = int(row['age'])
            except (ValueError, TypeError):
                continue  # 跳过脏数据或空值行

            if row['city'] == '北京' and age >= 30:
                matched_rows.append(row)
    return matched_rows

# 示例调用(仅作说明)
# results = filter_csv_by_condition('users.csv')
# print(f"匹配行数: {len(results)}")
2. 使用生成器函数(Generator)进一步释放内存
如果筛选出来的目标行数本身也非常庞大,使用 matched_rows.append(row) 依然会在内存中堆积海量字典对象。更推荐的工程做法是将读取逻辑封装为生成器,配合 yield 交付给下游,随用随取:
def stream_filter_csv(file_path, target_city, min_age):
    with open(file_path, mode='r', encoding='utf-8-sig', newline='') as f:
        reader = csv.DictReader(f)
        for row in reader:
            try:
                if row['city'] == target_city and int(row['age']) >= min_age:
                    yield row
            except (ValueError, KeyError):
                continue

# 下游消费示例:按需获取,无需一次性把所有命中行保存在列表里
# for matched_item in stream_filter_csv('large_data.csv', '上海', 25):
#     process_record(matched_item)
二、使用 Pandas 进行向量化筛选与分块读取
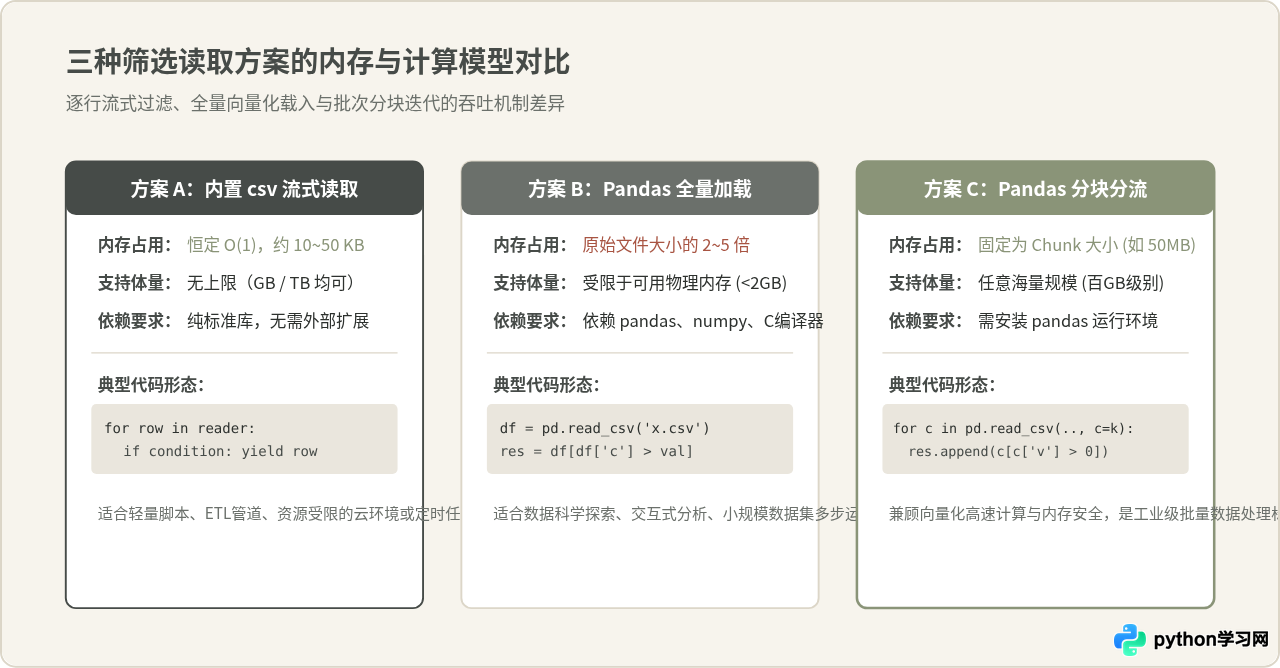
如果数据文件体积处于可用内存允许范围内(一般建议小于物理可用内存的 1/3),或者后续需要进行多列统计、聚合计算或矩阵运算,第三方库 pandas 提供了极具表达力的语法与底层 C 优化的执行性能。
1. 全量读取与布尔索引筛选
在 Pandas 中,条件筛选通常借助布尔索引(Boolean Mask)完成。多个条件组合时,必须使用按位运算符 &(与)、|(或)、~(非),且每个独立条件必须用小括号括起来:
import pandas as pd

# 读取 CSV 文件
df = pd.read_csv('users.csv', encoding='utf-8-sig')

# 组合筛选条件:年龄大于等于 30 且城市为北京
condition = (df['age'] >= 30) & (df['city'] == '北京')
filtered_df = df[condition]

# 如果仅需要其中某些列,可在筛选同时按需切片
result = df.loc[condition, ['user_id', 'user_name', 'city']]
2. 辨析误区:“用 Pandas 筛选就必须把整个文件读入内存”
许多初学者认为使用 Pandas 处理 CSV 就必须先执行 pd.read_csv() 将整个文件载入,导致面对数吉字节的 CSV 文件时频繁遭遇 MemoryError。这种说法在小文件时看似合理且方便,但对于海量数据是完全错误的。
Pandas 官方早已提供了分块读取参数 chunksize。它返回一个 TextFileReader 迭代器,使 Pandas 能够在保持向量化运算优势的同时,将内存控制在一个固定批次(Chunk)内:
import pandas as pd

# 设定每个批次读取 50,000 行
chunk_size = 50000
chunks = []

for chunk in pd.read_csv('large_data.csv', chunksize=chunk_size, encoding='utf-8-sig'):
    # 对当前批次执行向量化过滤
    sub_filtered = chunk[(chunk['city'] == '广州') & (chunk['score'] > 90)]
    if not sub_filtered.empty:
        chunks.append(sub_filtered)

# 最终仅把所有命中行拼接为结果 DataFrame
if chunks:
    final_df = pd.concat(chunks, ignore_index=True)
else:
    final_df = pd.DataFrame()
三、按条件筛选的技术选型路径
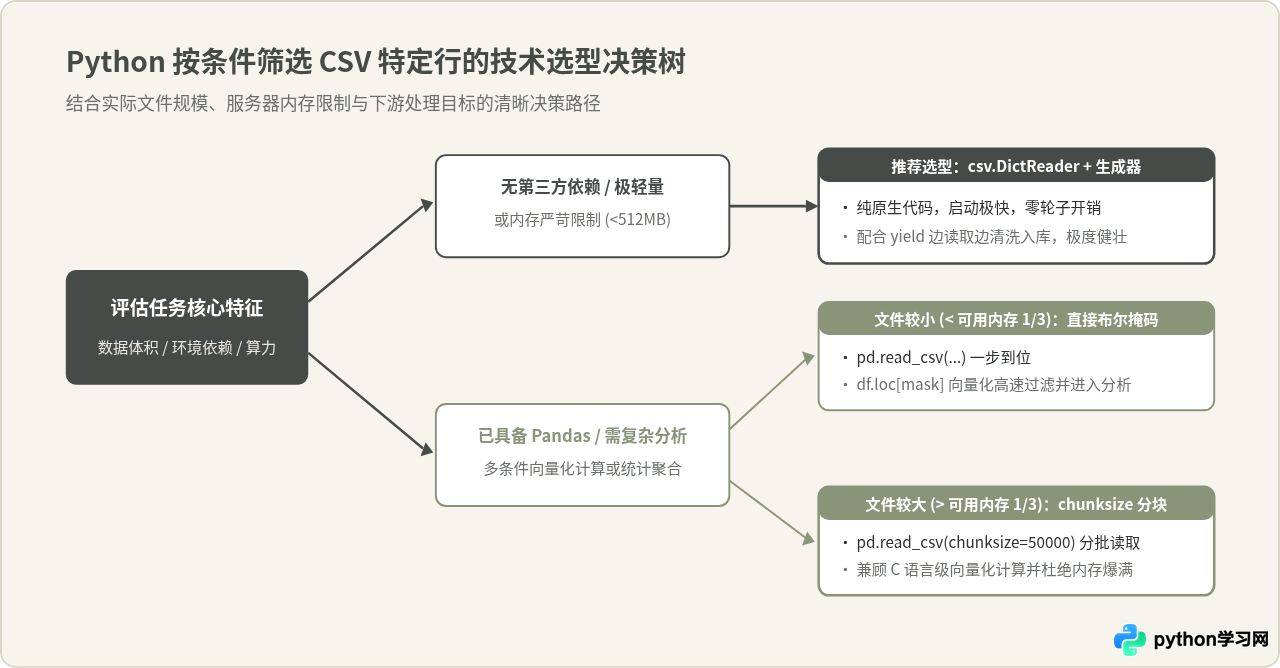
在工程实践中,面临具体的业务任务时究竟应该选择哪种实现方式?可以依据文件体积大小、执行环境依赖和后续业务链条三项关键指标进行决策:
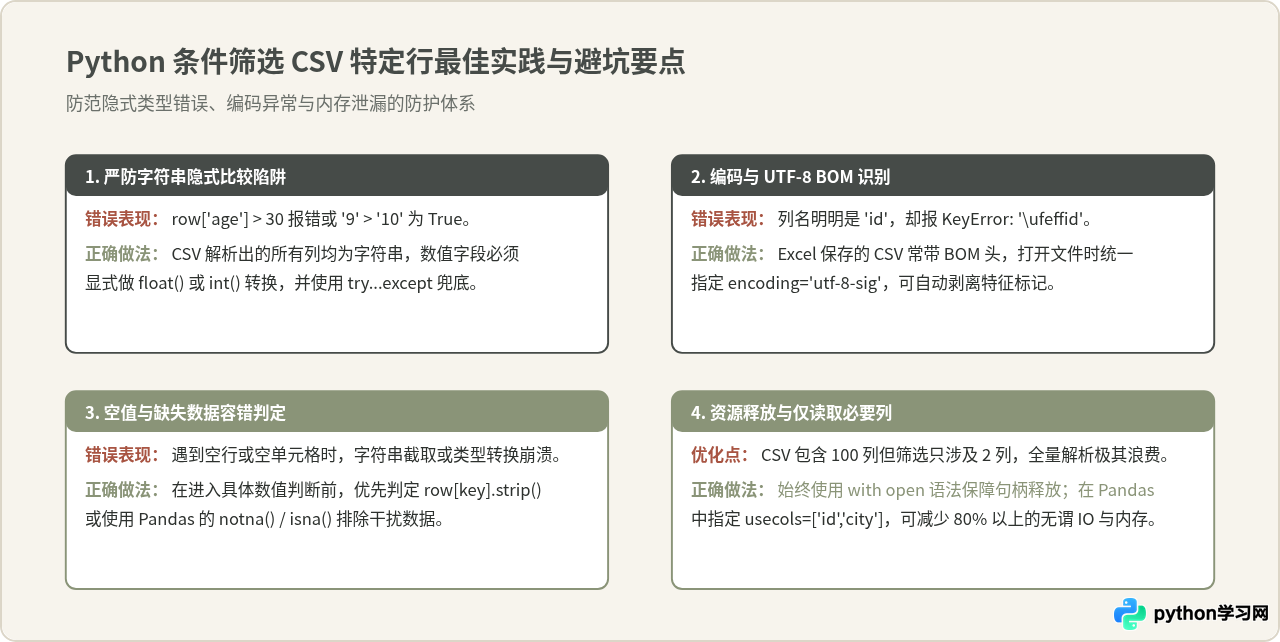
四、避坑指南:必须注意的四个关键细节
在编写条件筛选逻辑时,常见的问题往往不是语法不会写,而是由于 CSV 文本文件的特殊格式引发的隐蔽逻辑错误:
五、总结
在 Python 中按条件筛选并读取 CSV 特定行,并没有绝对的优劣之分,关键在于平衡开发成本与运行开销:
- 对于日常轻量自动化、微服务日志过滤、服务器原生部署,优先采用标准库
csv.DictReader+ 生成器,以 O(1) 的固定内存完成流式提取。 - 对于科学计算、探索性数据分析(EDA)或复杂多维查询,直接采用 Pandas 布尔索引;一旦文件规模超出内存承受范围,无缝切换至
chunksize分块批处理。 - 在执行具体条件判断前,牢记处理
utf-8-sig编码与显式类型转换,即可编写出既高效又健壮的 CSV 筛选处理程序。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









