

Python asyncio并发执行多个任务:create_task与gather用法示例
深入解析Python asyncio并发执行多个任务的核心机制,详解asyncio.create_task与asyncio.gather的区别、用法示例、执行流程与常见避坑指南。
在编写网络请求、批量数据抓取或高吞吐量 I/O 服务时,串行等待每一个网络响应会让程序耗时随着请求量线性倍增。Python 提供的 asyncio 标准库通过单线程事件循环机制,允许我们在等待 I/O 阻塞的间隙切换执行其他任务,从而在极低资源开销下达成高效并发。实现多任务并发执行最基础也最常用的两个核心工具是 asyncio.create_task 与 asyncio.gather。本文将从执行原理出发,通过完整的代码示例、机制拆解和结构对比,讲解如何正确使用这两个函数并发调度多个异步任务,并规避常见的内存回收与异常捕获陷阱。
一、理解并发前提:直接 await 为什么不是并发?
很多初学者在编写 asyncio 代码时,容易写出如下形式的代码:
# 常见误区:表面上使用了 async/await,但实际上是串行执行
async def main():
    res1 = await fetch_data("A", 1)  # 等待 A 完成后才继续向下执行
    res2 = await fetch_data("B", 2)  # 等待 B 完成后才继续向下执行
    res3 = await fetch_data("C", 3)  # 等待 C 完成后才继续向下执行
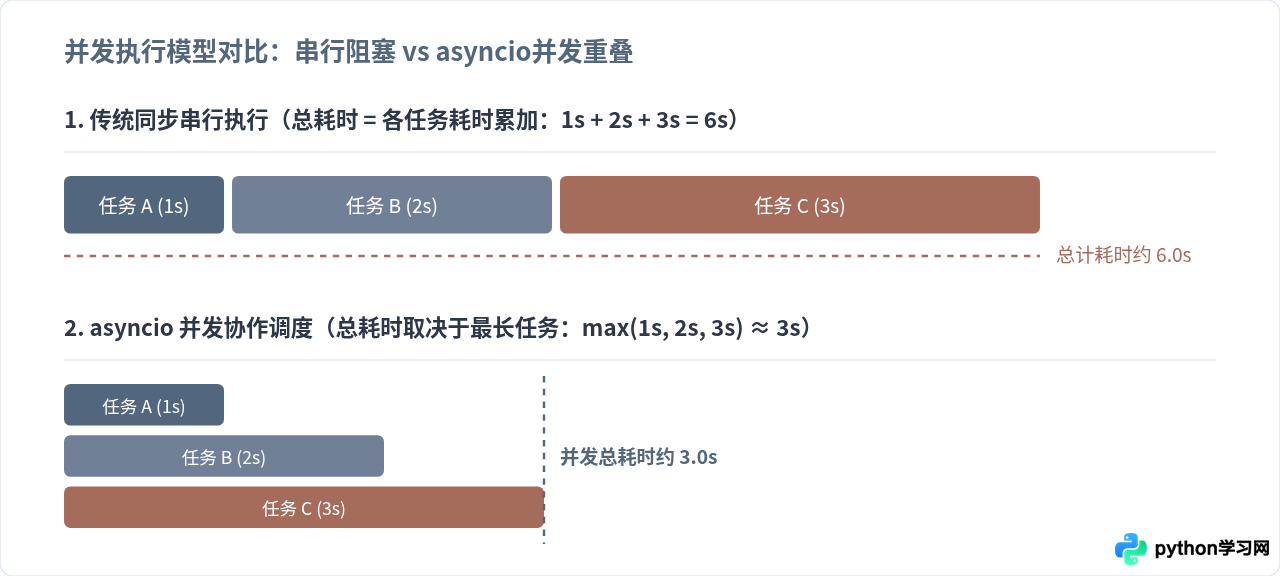
在这段代码中,每一次 await 都会立刻暂停 main 函数的执行,直到对应的协程完全执行完毕返回结果。事件循环虽然在这期间可以执行其他任务,但由于当前 main 并没有在事件循环中注册后续任务,导致任务 B 必须在任务 A 结束后才开始创建并进入循环,实际总耗时依旧是各个任务耗时的累加。要实现真正的“同时开工、重叠等待”,必须将多个协程在当前事件循环中完成调度注册。
二、asyncio.create_task:立即调度单个任务
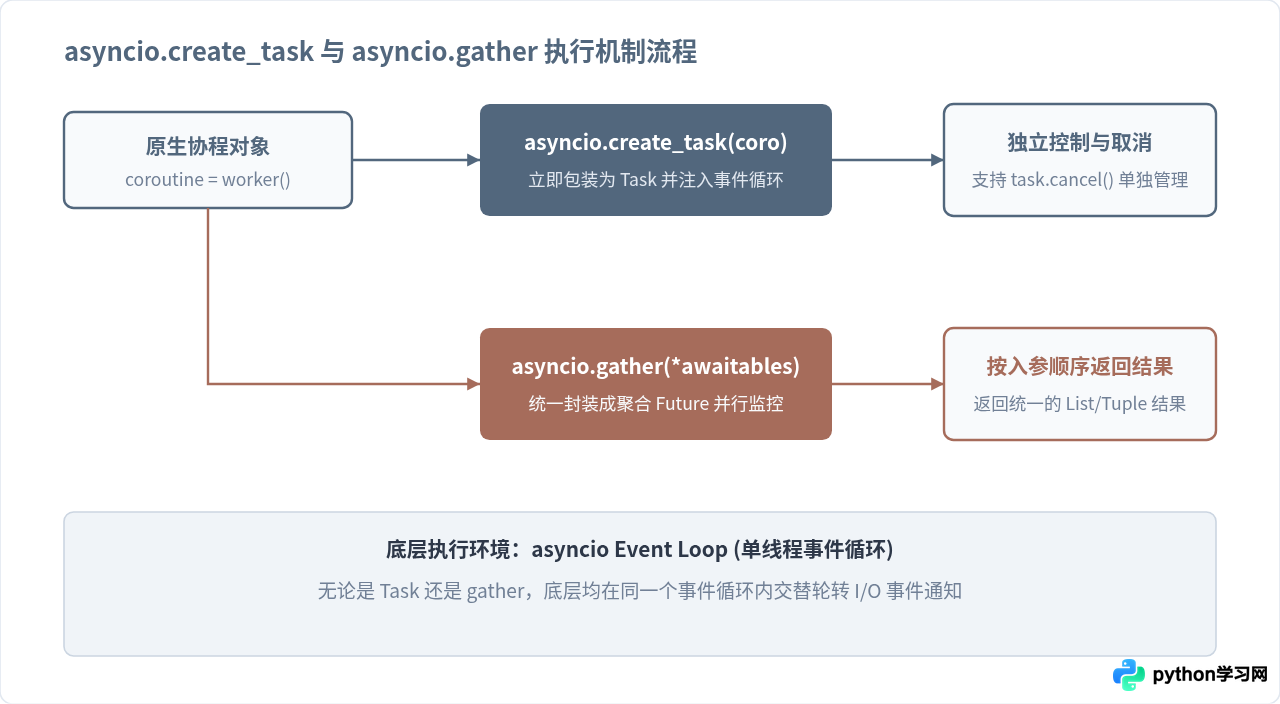
asyncio.create_task(coro) 接收一个协程对象,并将其包装为 asyncio.Task 对象。调用该函数的瞬间,任务就已经被排入了事件循环的执行队列。这意味着该任务在下一次循环迭代时即可立即并发运行,而不需要等到你主动 await 它。
1. 基础用法与代码示例
以下示例展示了如何使用 asyncio.create_task 派生多个并发任务:
import asyncio
import time

async def worker(name: str, delay: int) -> str:
    print(f"[{time.strftime('%X')}] 任务 {name} 开始执行,预计耗时 {delay} 秒")
    await asyncio.sleep(delay)
    print(f"[{time.strftime('%X')}] 任务 {name} 执行完毕")
    return f"{name}_done"

async def main():
    start_time = time.perf_counter()

    # 1. 创建 Task 对象:瞬间完成事件循环排期,后台开始并发推进
    task1 = asyncio.create_task(worker("A", 1))
    task2 = asyncio.create_task(worker("B", 2))
    task3 = asyncio.create_task(worker("C", 3))

    # 2. 在需要结果的时候再分别 await 收集
    res1 = await task1
    res2 = await task2
    res3 = await task3

    elapsed = time.perf_counter() - start_time
    print(f"[{time.strftime('%X')}] 所有任务完成,返回值: {[res1, res2, res3]}")
    print(f"总耗时: {elapsed:.2f} 秒")

if __name__ == "__main__":
    asyncio.run(main())
运行输出(示例):
[10:00:00] 任务 A 开始执行,预计耗时 1 秒
[10:00:00] 任务 B 开始执行,预计耗时 2 秒
[10:00:00] 任务 C 开始执行,预计耗时 3 秒
[10:00:01] 任务 A 执行完毕
[10:00:02] 任务 B 执行完毕
[10:00:03] 任务 C 执行完毕
[10:00:03] 所有任务完成,返回值: ['A_done', 'B_done', 'C_done']
总耗时: 3.01 秒
官方文档明确指出,后台由
create_task 创建的任务若未被变量强引用(例如直接调用 asyncio.create_task(background_work()) 而未将返回值赋给变量),可能在执行过程中被垃圾回收机制(GC)销毁导致任务中断。因此,如果任务是在后台运行且暂时不立即 await,应将其添加到一个全局或外部活跃的作用域集合中(如 background_tasks.add(task)),并在其完成时从集合移除(如通过 task.add_done_callback(background_tasks.discard))。
三、asyncio.gather:批量并发与结果聚合
如果你的场景是拥有一个确定的任务列表(如并发抓取 10 个网页),并且需要等待它们全部执行完毕后统一收集返回结果,那么 asyncio.gather 通常是更简洁优雅的选择。
gather(*aws, return_exceptions=False) 可以接收多个可等待对象(协程对象或已经创建的 Task)。如果传入的是原生协程对象,gather 会在内部自动将其转换为 Task 并投入调度。完成时,它将按照传入任务的先后顺序,返回一个包含所有结果的列表(List)。
1. 批量调度与解包传参
在实际工程中,我们通常将一组参数映射为一个任务列表,并通过星号 * 进行解包传入:
import asyncio
import time

async def fetch_url(url_id: int) -> dict:
    await asyncio.sleep(1.5)  # 模拟网络延迟
    return {"id": url_id, "status": 200}

async def main():
    start = time.perf_counter()

    # 构造多个协程调用
    tasks = [fetch_url(i) for i in range(1, 6)]

    # 并发执行并解包,按序等待所有结果
    results = await asyncio.gather(*tasks)

    print(f"聚合返回结果: {results}")
    print(f"并发执行耗时: {time.perf_counter() - start:.2f} 秒")

if __name__ == "__main__":
    asyncio.run(main())
运行输出(示例):
聚合返回结果: [{'id': 1, 'status': 200}, {'id': 2, 'status': 200}, {'id': 3, 'status': 200}, {'id': 4, 'status': 200}, {'id': 5, 'status': 200}]
并发执行耗时: 1.51 秒
2. 异常隔离机制:return_exceptions 参数
当多个并发任务中某一个任务发生未捕获异常时,asyncio.gather 的默认行为是立即将该异常向上抛出中断当前的 await 调用。但此时,其余尚未完成的任务并不会自动被取消,它们依然会在后台继续默默运行。
为了避免单点失败影响整体,可设置 return_exceptions=True。此时异常对象会被作为对应位置的普通返回值存放在结果列表中,而不会中断整个批处理流程:
async def faulty_worker(task_id: int):
    await asyncio.sleep(1)
    if task_id == 2:
        raise ValueError(f"任务 {task_id} 发生未知错误")
    return f"任务 {task_id} 成功"

async def main():
    tasks = [faulty_worker(i) for i in range(1, 4)]

    # 关键参数:return_exceptions=True
    results = await asyncio.gather(*tasks, return_exceptions=True)

    for i, res in enumerate(results, start=1):
        if isinstance(res, Exception):
            print(f"[{i}] 失败,捕获到异常: {res}")
        else:
            print(f"[{i}] 成功,结果为: {res}")

if __name__ == "__main__":
    asyncio.run(main())
四、两者结合应用:控制高并发速率
在实际生产环境中,盲目使用 gather 并发上千个请求极易导致本地文件描述符耗尽(Too many open files)或击垮对端服务器。最佳实践是将 asyncio.Semaphore(信号量)与 create_task 或 gather 结合,限制同时处于运行状态的最大协程数:
import asyncio
import time

# 限制最大同时并发数不超过 3
sem = asyncio.Semaphore(3)

async def limited_fetch(item_id: int):
    async with sem:
        print(f"[{time.strftime('%X')}] 正在处理 item-{item_id} (已获取信号量)")
        await asyncio.sleep(2)  # 模拟网络延迟
        return f"item-{item_id}-data"

async def main():
    # 虽然创建了 9 个任务,但由于 Semaphore 约束,每次只有 3 个在并发执行
    tasks = [limited_fetch(i) for i in range(1, 10)]
    results = await asyncio.gather(*tasks)
    print(f"全部完成,抓取数量: {len(results)}")

if __name__ == "__main__":
    asyncio.run(main())
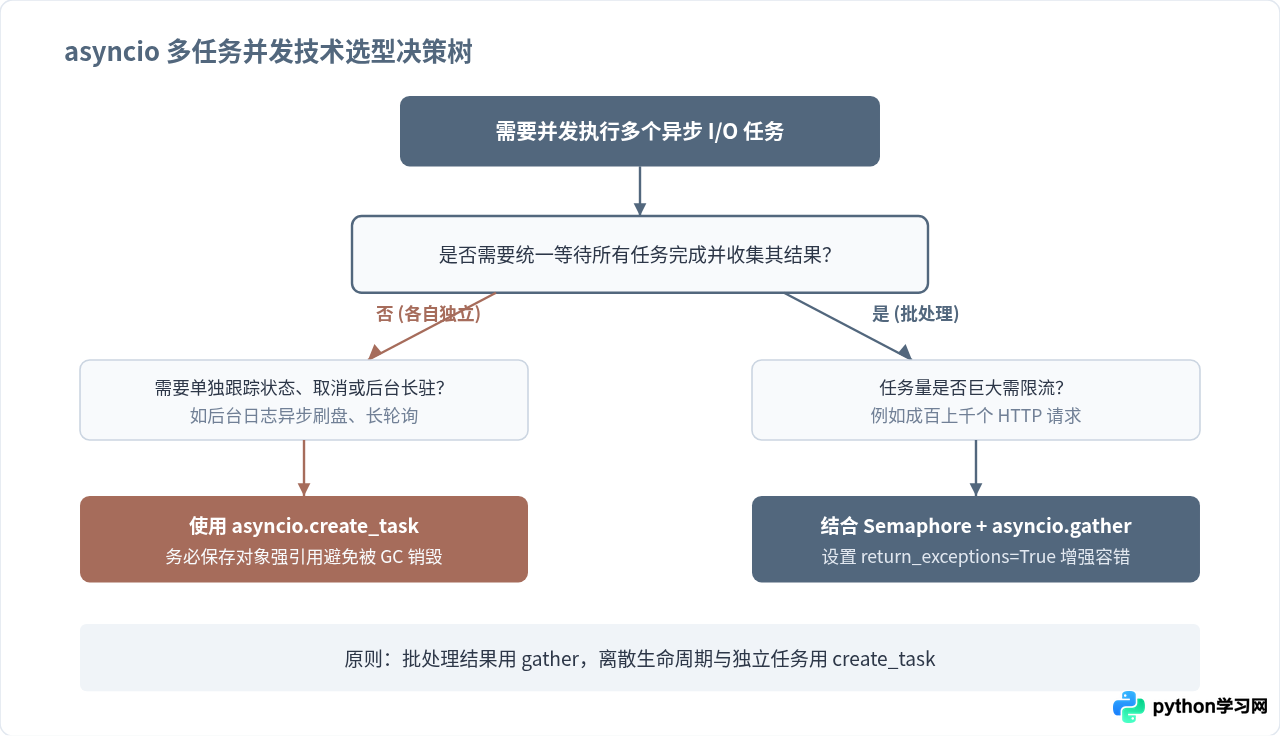
五、总结与速查清单
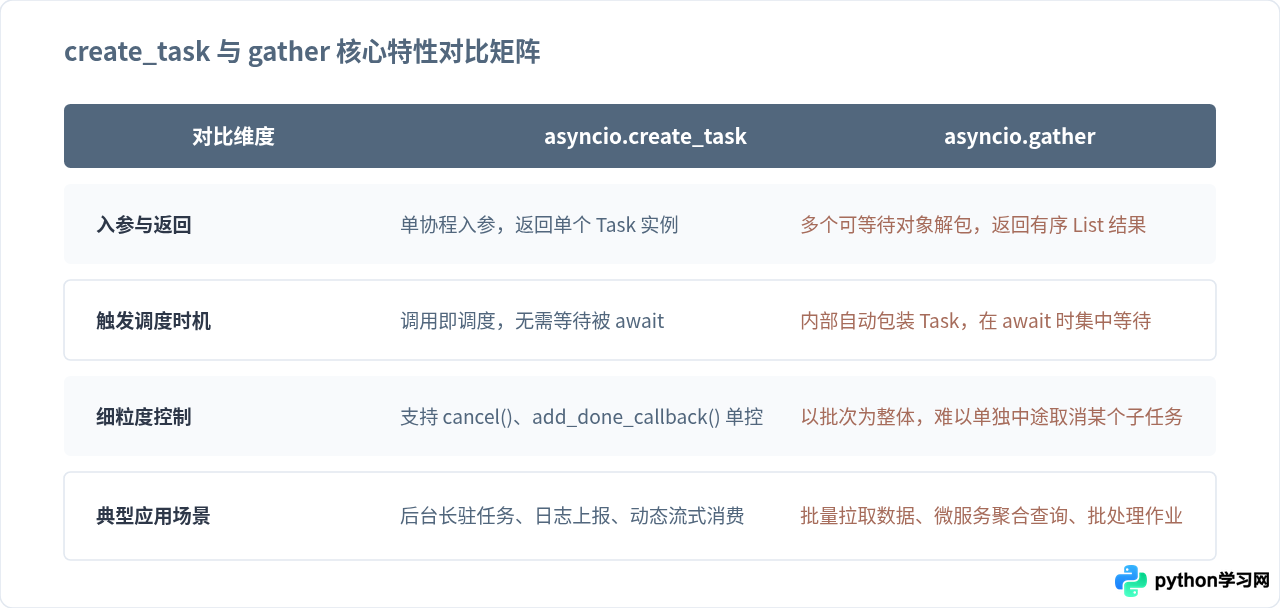
掌握 asyncio 并发执行的核心在于厘清调度时机与结果等待的分离:
- 必须避免伪并发:直接逐行
await coro()仍然是同步串行执行,没有任何重叠等待的效益。 - 单个任务与后台作业用
create_task:调用时即在事件循环挂号,允许在后续任意位置await;但务必保留任务对象引用,防止被垃圾回收中途终止。 - 确定批次与结果汇聚用
gather:将多个任务一并等待,并按输入顺序返回结果;善用return_exceptions=True实现容错隔离,防止单任务崩溃摧毁整个批次。 - 保护对端资源:高并发并非无节制,针对大量并发任务,必须使用
asyncio.Semaphore设定并发上限窗口。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









