

Python异步编程入门:async/await语法与asyncio基础
深入浅出讲解Python异步编程核心机制,系统介绍async/await语法规范与asyncio标准库基础,剖析事件循环原理、多任务并发实践及常见避坑指南。
async 与 await 语法糖,搭配标准库 asyncio,允许单个线程在等待 I/O 响应时主动出让执行权,交由事件循环调度其他就绪任务。本文直入主题,详细讲解协程的核心工作机制、基础语法规则、多任务并发编排方法,并通过具体代码对比与避坑指南,帮助读者建立清晰规范的异步编程心智模型。
一、为什么需要异步:从同步阻塞到事件循环
计算机程序的性能瓶颈通常分为两类:CPU 密集型(如大量数学计算、图像编解码)与 I/O 密集型(如下载网页、调用远程 API、读取磁盘)。在典型的 Web 服务和爬虫任务中,90% 以上的耗时都在等待远程服务器响应,此时 CPU 本身处于闲置状态。
传统的多线程模型通过操作系统层面的线程上下文切换来实现并发,但每个操作系统线程通常占用数兆字节的独立栈内存,线程间的切换还需要陷入内核态,资源开销较大。而在 Python 中,由于全局解释器锁(GIL)的存在,多线程更无法利用多核 CPU 提升纯计算效率。
异步编程(Asynchronous Programming) 采用的是完全不同的设计哲学:它运行在单线程之上,通过一个名为事件循环(Event Loop)的核心调度器来监控所有 I/O 事件。当一个任务发起网络请求后,它不会像同步代码那样把整个线程卡死,而是主动向事件循环挂起自己;事件循环趁此间隙立即切换去执行其他已经就绪的代码;一旦底层的网络数据包到达,操作系统通知事件循环,原任务便被重新唤醒继续往下执行。
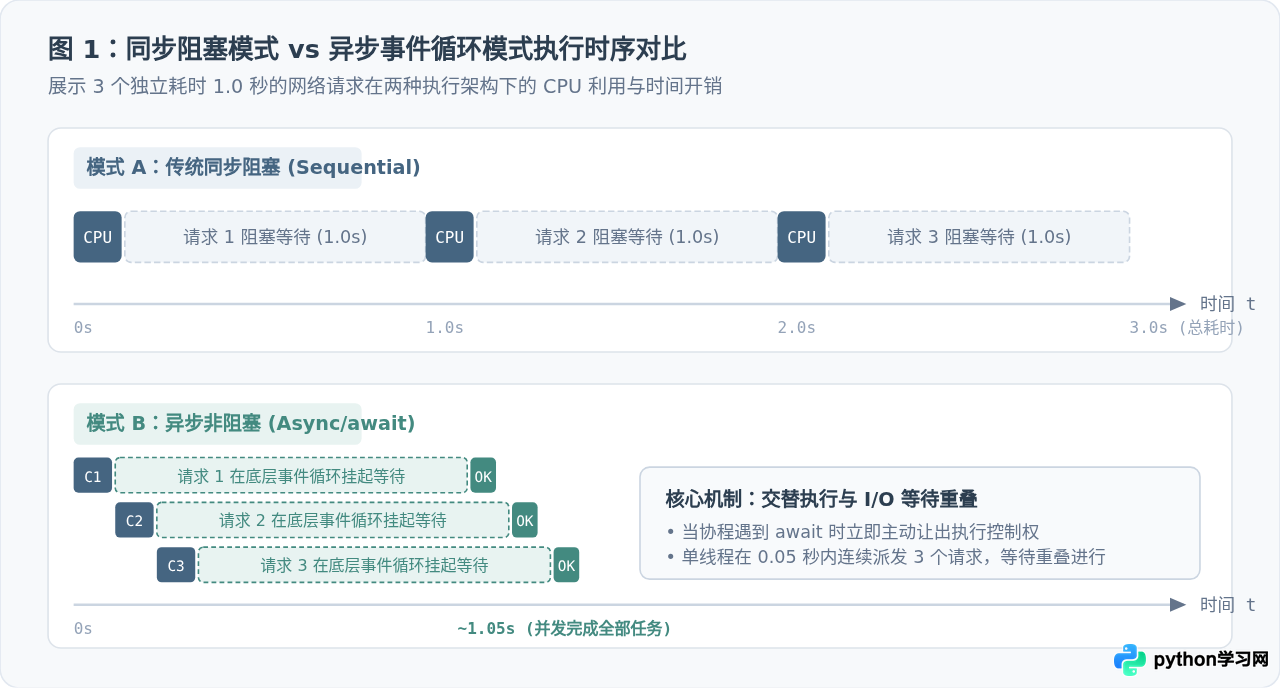
从图 1 可以直观地看到:在同步模式下,执行 3 个各耗时 1 秒的 I/O 请求需要依次累加耗时,总时长为 3 秒;而在异步事件循环模式下,3 个请求在极短的几毫秒内被相继派发出去,随后它们的网络等待阶段在底层完全重叠进行,最终完成总耗时仅略大于 1 秒。
二、async 与 await 核心语法规范
自 Python 3.5 起,Python 正式引入了专门的 async 与 await 关键字,确立了现代协程的标准语法。理解它们的核心在于把握协程函数与协程对象的区别。
1. 定义与声明:async def
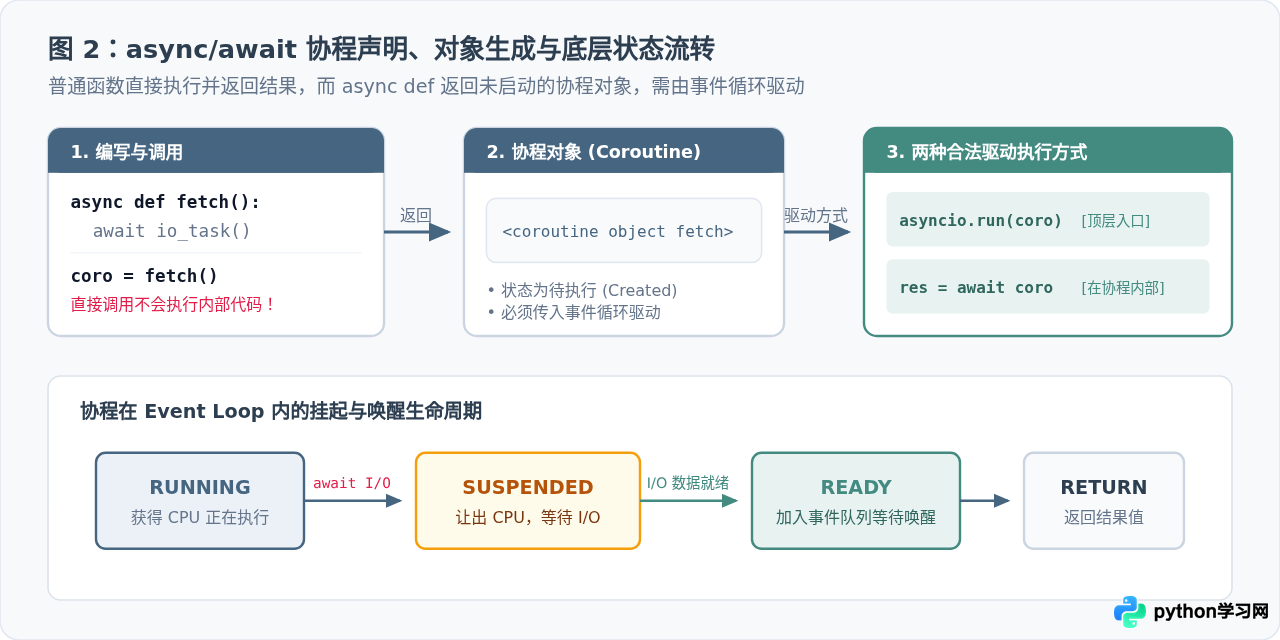
普通函数使用 def 定义,只要被调用就会立即执行函数体并返回值。而使用 async def 定义的函数被称为协程函数(Coroutine Function)。
fetch_data(),绝对不会执行函数体内部的代码!它仅返回一个未启动的协程对象(Coroutine Object)。
# demo_coroutine.py
import asyncio

async def say_hello():
    print("Hello, asyncio!")
    return 42

# 直接调用的错误示范
coro = say_hello()
print(coro)
# 终端输出: <coroutine object say_hello at 0x...>
# 同时伴随警告: RuntimeWarning: coroutine 'say_hello' was never awaited
2. 挂起与等待:await
await 关键字的作用是挂起当前协程的执行,将 CPU 控制权交还给事件循环,直到等待的目标对象计算完毕或 I/O 完成,再恢复执行并获取返回值。
使用 await 必须严格遵循以下两条硬性语法规则:
- 使用位置限制:
await只能在被async def修饰的异步函数内部使用,不能在普通的同步函数中直接调用。 - 对象类型限制:
await后面必须跟一个可等待对象(Awaitable)。在 Python 中,可等待对象主要分为三类:协程对象(Coroutine)、任务(Task)以及底层 Future。如果尝试 await 一个普通整数、字符串或同步函数,将抛出TypeError: object ... can't be used in 'await' expression。
3. 程序总入口:asyncio.run()
由于普通同步代码不能直接使用 await,那么如何启动第一个异步协程呢?Python 3.7+ 提供了标准顶层入口 asyncio.run(coro)。它负责完整处理底层的生命周期:创建全新的事件循环、运行传入的根协程直至完成、安全取消未尽任务并彻底关闭循环。
下面是一个完整且规范的初级异步示例:
# basic_run.py
import asyncio

async def fetch_status():
    print("开始模拟网络请求...")
    # 模拟非阻塞的异步网络等待 1.5 秒
    await asyncio.sleep(1.5)
    print("网络数据获取成功!")
    return {"status": 200, "data": "ok"}

async def main():
    print("主协程启动")
    result = await fetch_status()
    print(f"解析到返回结果: {result}")
    print("主协程结束")

if __name__ == "__main__":
asyncio.run(main())三、并发执行多个任务:Task 与 gather
在上述示例中,我们在 main() 中单次 await fetch_status()。如果连续书写两个 await:
# 常见误区:这依然是串行的!
result1 = await fetch_status()
result2 = await fetch_status()
程序会先等 result1 彻底执行完毕返回后,才发起 result2。因为 await 会阻塞当前协程往下一行推进。要实现真正的并发运行,必须将多个协程同时注册到事件循环中。
1. 封装为任务:asyncio.create_task()
asyncio.create_task(coro) 用于将一个协程对象封装成一个 asyncio.Task。一旦调用该函数,该任务就会立刻被推入当前事件循环的任务就绪队列中进行排队,无需等到被显式 await 之后才启动。
2. 批量并发汇聚:asyncio.gather()
在实际项目中,最常用且最优雅的高层并发 API 是 asyncio.gather(*aws)。它可以接收任意数量的可等待对象,自动将它们调度并发执行,并保持原始传参顺序,将所有协程的最终返回值打包成一个列表一并返回。
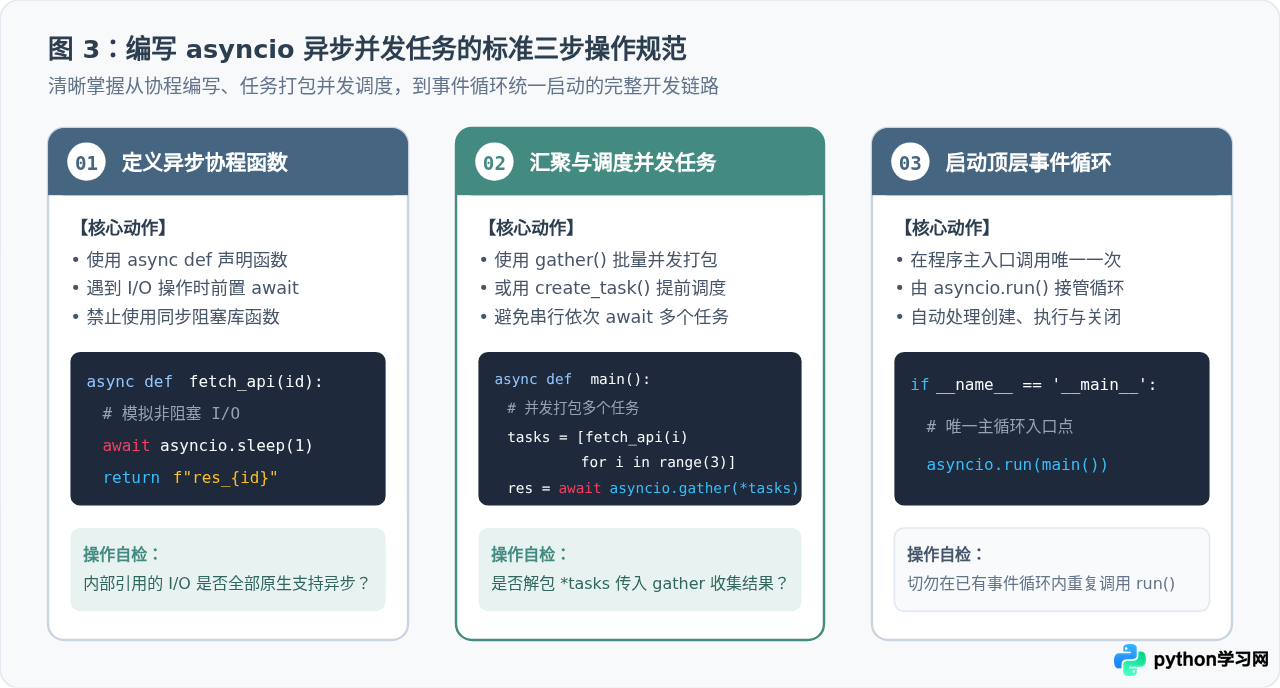
四、实战性能对比:同步 vs 异步
为了让读者直观感受性能差异,我们设计一个基准测试场景:模拟依次访问 3 个微服务节点,每个节点响应固定耗时 1.0 秒。我们对比同步执行与异步并发执行的代码结构与实际耗时。
1. 同步执行方案
# sync_benchmark.py
import time

def sync_fetch(task_id: int):
    print(f"同步请求 {task_id} 开始...")
    time.sleep(1.0)  # 阻塞当前线程 1.0 秒
    print(f"同步请求 {task_id} 完成")
    return f"data_{task_id}"

def main():
    start_time = time.perf_counter()
    results = [sync_fetch(i) for i in range(1, 4)]
    total_time = time.perf_counter() - start_time
    print(f"同步全部完成,结果: {results}")
    print(f"总耗时: {total_time:.2f} 秒")

if __name__ == "__main__":
main()2. 异步并发方案
# async_benchmark.py
import asyncio
import time

async def async_fetch(task_id: int):
    print(f"异步请求 {task_id} 触发...")
    await asyncio.sleep(1.0)  # 非阻塞让出控制权
    print(f"异步请求 {task_id} 收到响应")
    return f"data_{task_id}"

async def main():
    start_time = time.perf_counter()
    # 生成 3 个协程对象并由 gather 并发编排
    tasks = [async_fetch(i) for i in range(1, 4)]
    results = await asyncio.gather(*tasks)

    total_time = time.perf_counter() - start_time
    print(f"异步全部完成,结果: {results}")
    print(f"总耗时: {total_time:.2f} 秒")

if __name__ == "__main__":
    asyncio.run(main())
性能结论:在相同的单线程硬件环境下,通过 asyncio.gather 进行并发聚合,执行时长从 3.01 秒 骤降至 1.01 秒,吞吐量提升了近 3 倍。如果并发请求量扩大到 50 个或 100 个,只要服务器与带宽允许,耗时依然可维持在约 1 秒上下,这正是异步处理高吞吐网络业务的根本优势。
五、初学者常见三大陷阱与解决策略
这是绝大多数从传统 Python 转入异步的开发者最容易犯的错误。例如在 async def 函数中使用了 time.sleep(5) 或者流行的 requests.get()。
原因剖析:requests 和 time.sleep 是同步阻塞调用,它们在等待过程中会牢牢锁死底层操作系统的单个主线程。由于整个 asyncio 事件循环也在这个线程中运转,主线程一旦被锁死,事件循环就完全失去了调度能力,其他所有正在并发的协程全都会被迫停摆!
解决方案:
- 优先使用原生异步第三方库:网络请求使用
httpx(搭配httpx.AsyncClient)或aiohttp;文件读写使用aiofiles。 - 若必须使用遗留的同步阻塞三方库,必须使用事件循环的
run_in_executor将其分流到单独的系统线程池中运行,避免阻断主事件循环:
# 正确处理遗留阻塞代码
import asyncio
import requests

def legacy_blocking_call(url):
    return requests.get(url).status_code

async def main():
    loop = asyncio.get_running_loop()
    # None 代表使用默认的 ThreadPoolExecutor 线程池
    status = await loop.run_in_executor(None, legacy_blocking_call, "https://example.com")
    print(f"执行状态码: {status}")

asyncio.run(main())
当调用一个异步函数忘记加 await 时,如 save_to_db()。Python 解释器不会抛出语法错误,而是静默生成一个协程对象后直接跳过。结果就是数据库保存操作从未真正执行,同时控制台会弹出:
RuntimeWarning: coroutine 'save_to_db' was never awaited。
规避建议:在日常开发中开启 Python 开发模式(命令行添加 -X dev 参数或设置环境变量 PYTHONDEVMODE=1),它会强制把未 await 的协程警告提升为显著报错。
asyncio.run() 的职责是创建全新的事件循环。如果你是在 Jupyter Notebook、IPython、FastAPI 路由函数或 Tornado/Twisted 回调中工作,当前环境早已有正在运转的事件循环。此时再次调用 asyncio.run() 会直接触发运行时崩溃:
RuntimeError: asyncio.run() cannot be called from a running event loop。
规避建议:在已有循环的运行上下文中,直接使用 await coro 或 asyncio.create_task(coro),切勿在协程内部嵌套 asyncio.run()。
六、核心要素与避坑知识卡片速查
为了方便读者在日常开发中随时查阅,下表系统梳理了同步、多线程与 asyncio 异步编程在各个核心维度的技术特性对比:
| 对比维度 | 传统同步阻塞 | 标准多线程 (threading) | 异步协程 (asyncio) |
|---|---|---|---|
| 并发执行实体 | 单个进程 / 主线程 | 操作系统原生内核线程 | 用户态轻量级协程 (Task) |
| 上下文切换开销 | 无切换 | 内核态切换,上下文开销中等 | 用户态自主切换,极低开销(函数级) |
| 内存资源占用 | 低 | 每个线程独立栈(默认约 8MB) | 单协程仅需数 KB 甚至更小 |
| 锁与竞态风险 | 无 | 高(需手动管理 Lock、RLock) | 单线程交替调度,天然避免复杂内存竞态 |
| 最佳适用场景 | 简单脚本、线性批处理 | 简单 I/O 阻塞、多核 C 扩展计算 | 高并发网络爬虫、API 微服务、消息队列消费 |
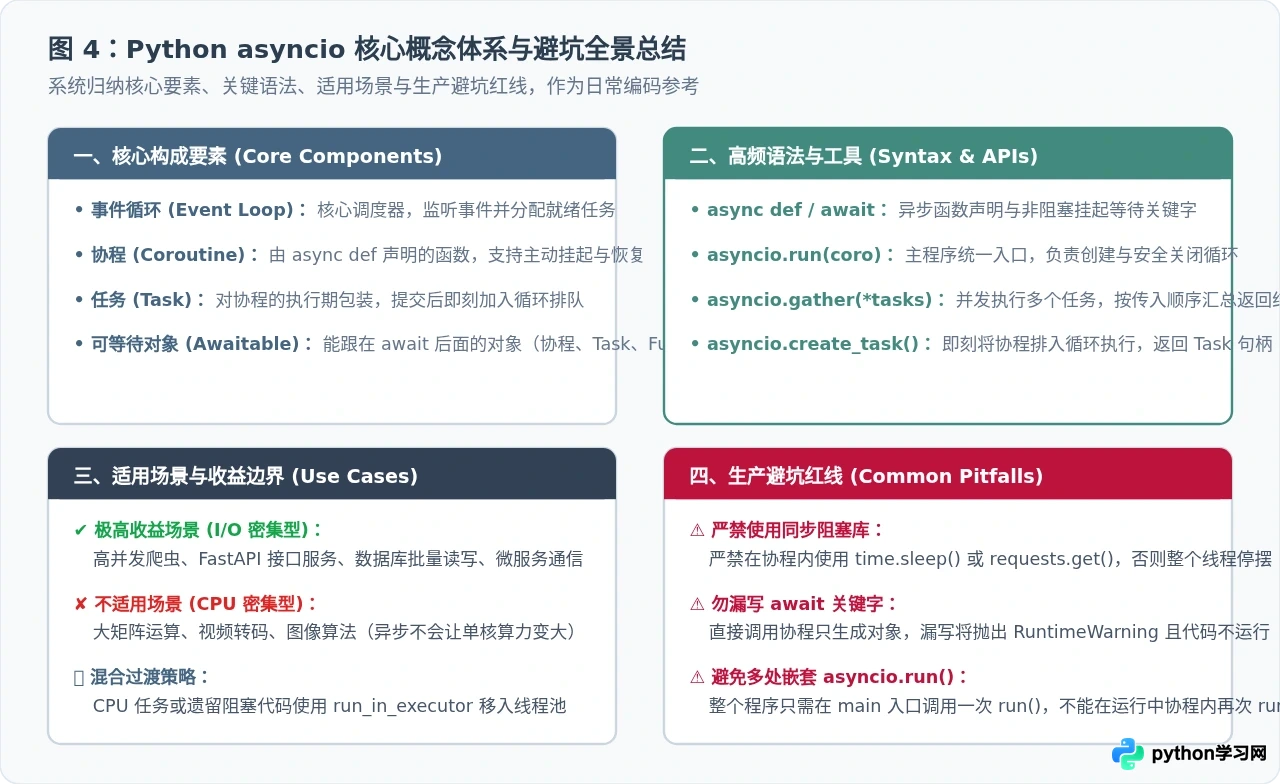
学习建议与延伸路径:
掌握了 async/await 语法与 asyncio.gather 之后,读者已经具备了编写绝大多数高并发 I/O 任务的基础能力。随着项目的复杂度提升,建议进一步探索 Python 3.11+ 引入的结构化并发管理利器 asyncio.TaskGroup(具备更强大的异常捕获与任务取消保护机制)、信号量 asyncio.Semaphore(用于限制高并发爬虫的最大并发连接数),以及现代高性能异步 Web 框架(如 FastAPI、Sanic)。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









