

Python读取CSV文件出现乱码怎么办
针对Python读取CSV文件时常见的中文乱码、UnicodeDecodeError报错及BOM头问题,系统讲解字符编码原理、排查诊断方法与针对性修复方案。
UnicodeDecodeError 报错,核心原因是程序解码时指定的字符编码与文件在磁盘中实际保存的编码不匹配。解决此问题无需繁琐试错,只需两步:首先确认文件的真实编码(常见为 GBK、UTF-8 或 UTF-8-SIG),随后在 pandas.read_csv() 或 open() 函数中通过 encoding 参数显式传入对应格式。本文将详细拆解报错原因、排查方法与对应的修复代码。
一、乱码产生的本质:字符与字节的解码错位
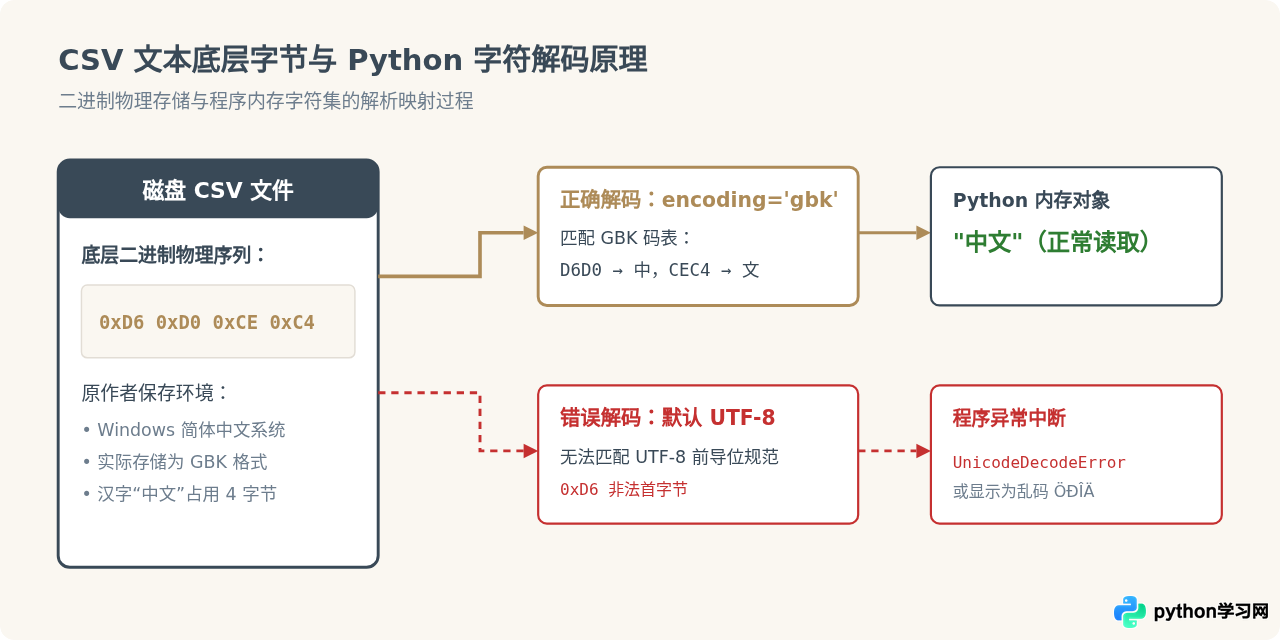
CSV 本质上是纯文本文件,在硬盘上只以一系列二进制字节(0 和 1)的形式存在。当 Python 读取文件时,必须依赖某种字符编码标准(Charset / Encoding),将这一连串字节翻译为屏幕上可见的文字字符。
如果一份 CSV 文件最初是在简体中文版 Windows 系统下的 Excel 中保存的,系统通常默认采用 ANSI 编码(在中国大陆对应 GBK 或 GB2312 编码)。然而,Python 3 在 Linux、macOS 或现代代码编辑器中,默认大多采用 UTF-8 编码来解读文件。当 Python 尝试用 UTF-8 的解析规则去套用 GBK 编码的双字节中文字符时,就会由于字节序列不符合规范而抛出异常,或者强行替换成不可读的杂乱字符。
二、CSV 乱码的三种典型症状与原因定位
在编写代码时,读取失败通常表现为以下三种具体现象,读者可以对照自己的终端输出快速确认原因:
1. 直接崩溃:抛出 UnicodeDecodeError
这是最普遍的报错形态,报错信息通常如下:
UnicodeDecodeError: 'utf-8' codec can't decode byte 0xd6 in position 0: invalid continuation byte原因:文件实际上是 GBK、GB2312 或 ANSI 编码,但 Python 读取函数默认以 UTF-8 模式打开,遇到无法解析的字节序列时直接报错中断。
2. 未报错但内容变成乱码符号(如“锟斤拷”或“ÖÐÎÄ”)
代码运行顺利完成,但在终端打印 DataFrame 或写入数据库时,所有的中文字符变成了类似 、锟斤拷锟斤拷 或者西文字符 试。
原因:读取时可能显式指定了与实际不符的单字节编码(例如 latin1 或 iso-8859-1),或者文件曾经历过多重错误转码,导致字节数据已被篡改。
3. 内容正常,但首列列名莫名包含“\ufeff”
文件内容能够正常解析为中文,但在访问首列例如 df['id'] 时报出 KeyError: 'id',打印列名发现首列实际变成了 '\ufeffid'。
原因:文件是带有 BOM(Byte Order Mark,字节顺序标记)的 UTF-8 格式(即 UTF-8-SIG)。Windows 软件(如 Excel 导出)常会在文件头部加入隐藏的 3 个字节 0xEF 0xBB 0xBF,用普通 utf-8 读取时,这三个字节会被误当成普通文本解析到第一个字段名中。
三、排查与解决 CSV 乱码的四步操作法
面对乱码问题,不建议盲目猜测编码,应按照“确认编码、配置参数、处理异常、验证结果”的标准次序操作。
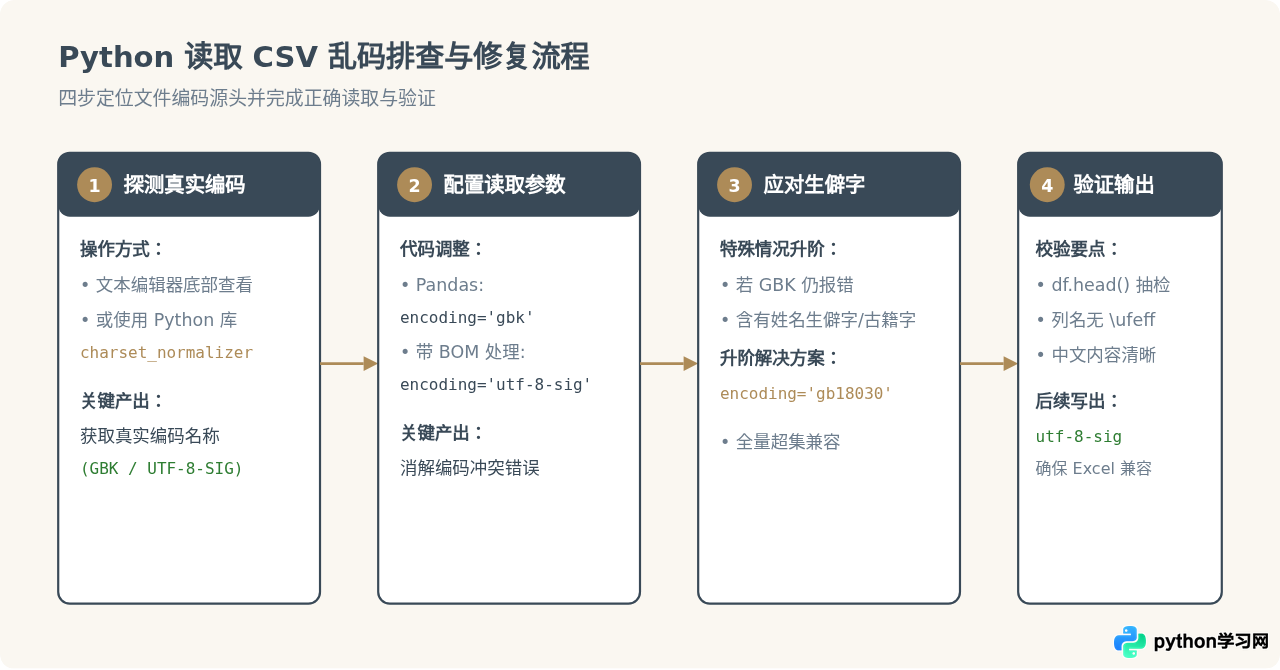
第一步:探测文件的真实编码
在写读取逻辑之前,首先需要明确目标 CSV 到底用了什么编码。有两种简易途径:
- 文本编辑器直接查看:使用 VS Code 打开该 CSV 文件,观察窗口右下角状态栏中显示的编码名称(例如
GB2312、UTF-8或UTF-8 with BOM)。 - 代码自动化探测:对于自动化批量处理场景,可以使用 Python 的
charset_normalizer模块通过统计学算法快速识别前数千字节的编码:
from charset_normalizer import from_path

# 探测文件真实编码
results = from_path("data.csv")
best_match = results.best()

if best_match is not None:
    print(f"探测到的编码格式为: {best_match.encoding}")
else:
    print("未能识别文件编码")
第二步:在 Pandas 中显式指定 encoding 参数
在使用 pandas.read_csv() 时,默认使用的是系统的 UTF-8 编码。当探测到文件为 GBK 或带 BOM 的格式时,直接传参即可解决:
import pandas as pd

# 常见场景 1:针对 Windows Excel 导出的标准 GBK 文件
df = pd.read_csv("data.csv", encoding="gbk")

# 常见场景 2:针对 Windows Excel 导出的带 BOM 头的 UTF-8 文件
# 使用 utf-8-sig 可以自动剔除开头的 \ufeff 字符,避免列名解析异常
df = pd.read_csv("data.csv", encoding="utf-8-sig")
第三步:在内置 csv 模块与 open() 函数中配置参数
如果不使用第三方库 Pandas,而是使用 Python 内置的 csv 库配合 open() 打开文件,编码参数必须配置在 open() 函数内部:
import csv

# 正确打开 GBK 编码的 CSV 文件
with open("data.csv", mode="r", encoding="gbk", newline="") as f:
    reader = csv.reader(f)
    for row in reader:
        print(row)

# 打开带 BOM 头的 UTF-8 文件
with open("data.csv", mode="r", encoding="utf-8-sig", newline="") as f:
    reader = csv.DictReader(f)
    for row in reader:
        print(row)
第四步:生僻字报错时的升阶方案(GB18030)
在处理政府机构、医疗系统或人名数据时,有时指定 encoding='gbk' 仍然会偶尔报出类似 'gbk' codec can't decode byte 0x... 的错误。这是因为 GBK 字符集只收录了两万多个常用汉字,若文件中包含了生僻字(如“䶮”、“赟”、“珅”)或特殊标点符号,就会超出 GBK 的边界。
此时将参数升级为 encoding='gb18030' 即可完全解决。GB18030 是我国的国家强制标准,完全向下兼容 GBK 和 GB2312,且收录了七万余个汉字及少数民族文字:
# 包含生僻字或冷门符号时的终极读取方案
df = pd.read_csv("data.csv", encoding="gb18030")
四、常用中文编码体系对比与选型参考
为了在团队协作与跨系统交互中彻底避免乱码,我们需要理清常用编码的差异、适用场景和特征:
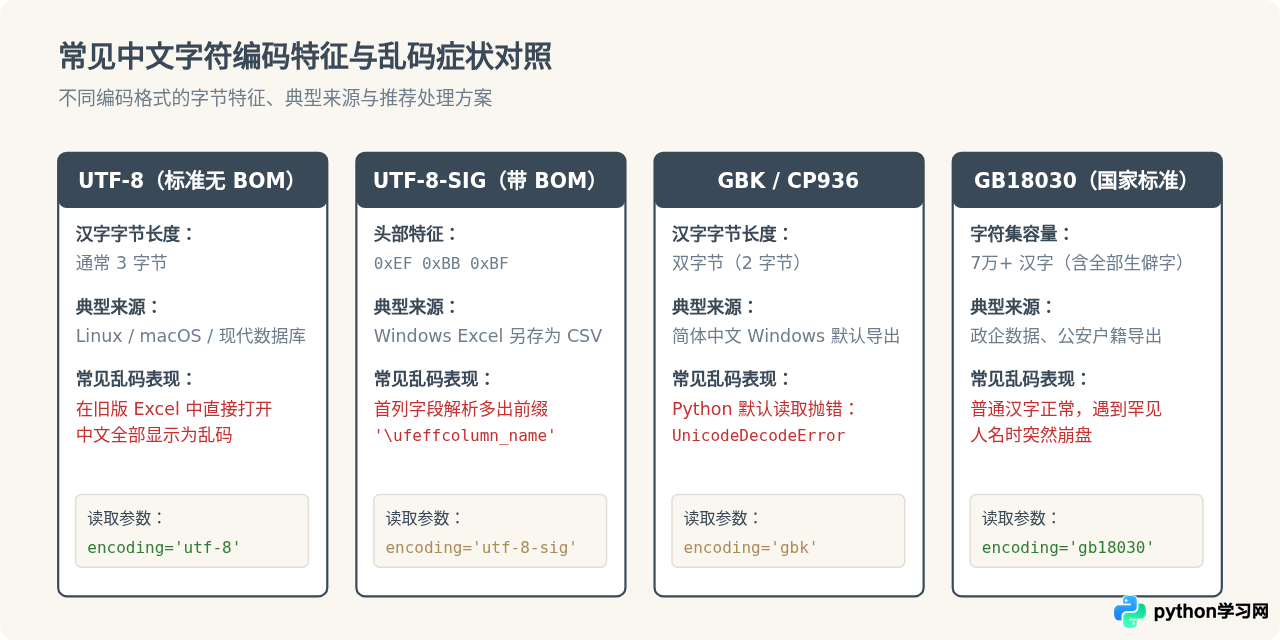
| 编码格式 | 中文占用字节 | 常见生成环境 | 适用读取参数 |
|---|---|---|---|
| UTF-8 | 3 字节 | Linux、macOS、网络爬虫、现代 API | encoding='utf-8'(默认) |
| UTF-8-SIG | 3 字节 + 3 字节头部 | Windows Excel“另存为 CSV” | encoding='utf-8-sig' |
| GBK / CP936 | 2 字节 | 简体中文版 Windows 软件默认导出 | encoding='gbk' |
| GB18030 | 1 / 2 / 4 字节变长 | 政务系统、金融银行、人名/地名含有生僻字 | encoding='gb18030' |
五、避免二次乱码的工程规范与注意事项
解决完读取问题后,如果需要将处理后的数据重新保存为 CSV 文件,必须注意“写出时的防乱码策略”,避免产生恶性循环:
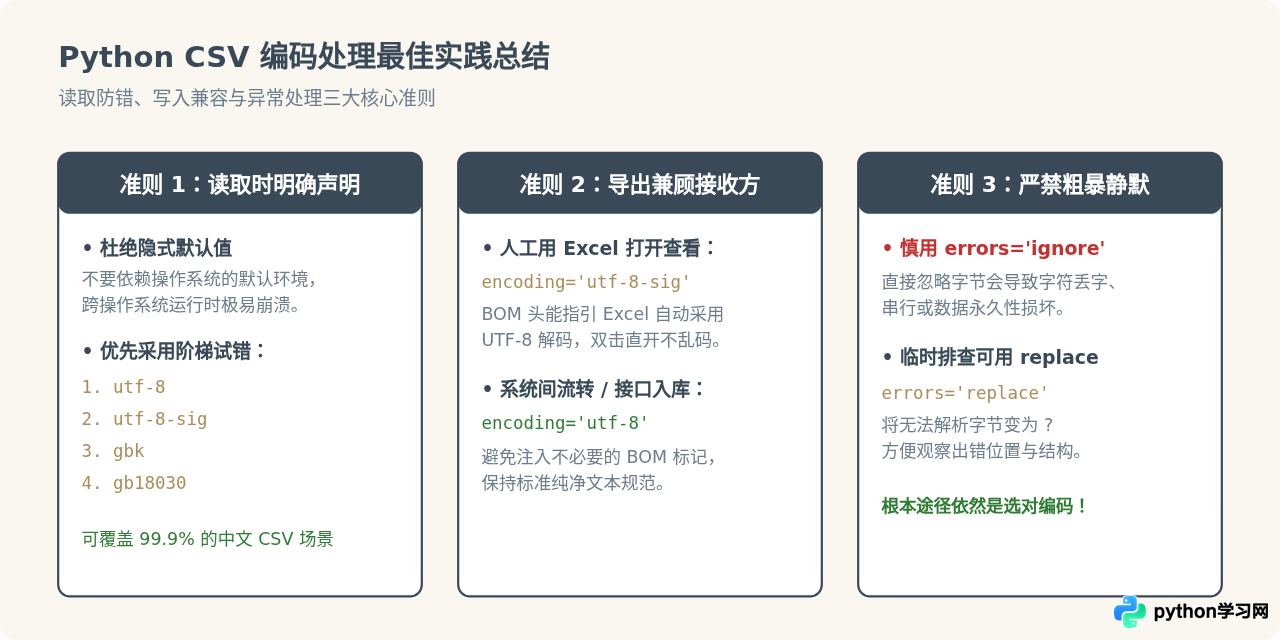
很多开发者用 Python 处理完数据后,直接执行
df.to_csv("result.csv", index=False),默认使用 UTF-8 保存。然而,当业务人员使用 Windows Excel 双击打开该文件时,Excel 往往会按系统默认的 ANSI(GBK)去解读它,导致原本正常的中文再次呈现为乱码。
终极解法:在导出时显式指定
encoding='utf-8-sig':
df.to_csv("result.csv", index=False, encoding="utf-8-sig")免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









