

Python读取CSV报错UnicodeDecodeError的修复方法
详细讲解在Python中使用内置csv模块或pandas读取CSV文件时出现UnicodeDecodeError的根本原因与排查步骤,提供可靠的代码修复方案和常见误区辨析。
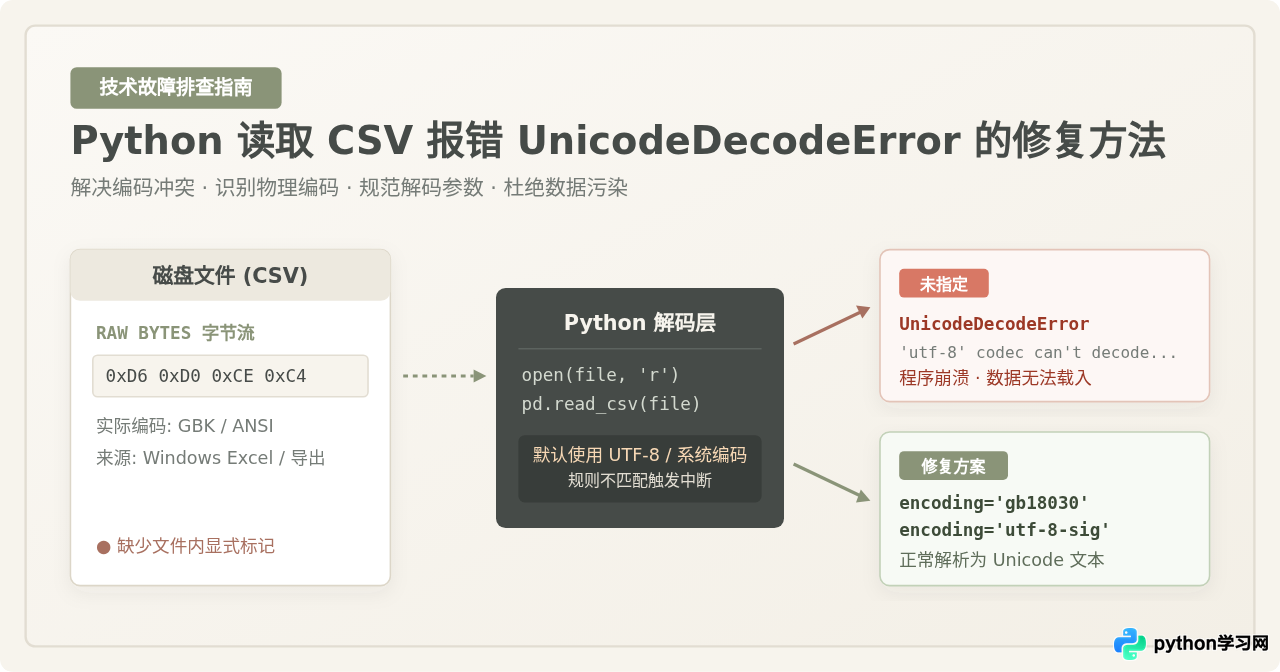
open()、csv 模块或 pandas.read_csv() 读取 CSV 文件时,出现 UnicodeDecodeError 的本质原因,是程序用于文本还原的解码规则与文件在硬盘上实际存储的字节编码不一致。解决此问题的可靠路径由两步构成:首先查明文件的实际物理编码(如 Windows 环境生成的 GBK/GB18030,或带有签名的 UTF-8-SIG),随后在读取函数中显式传入对应的 encoding 参数,即可在不损坏原始数据的前提下完成修复。
一、报错的具体表现与触发机理
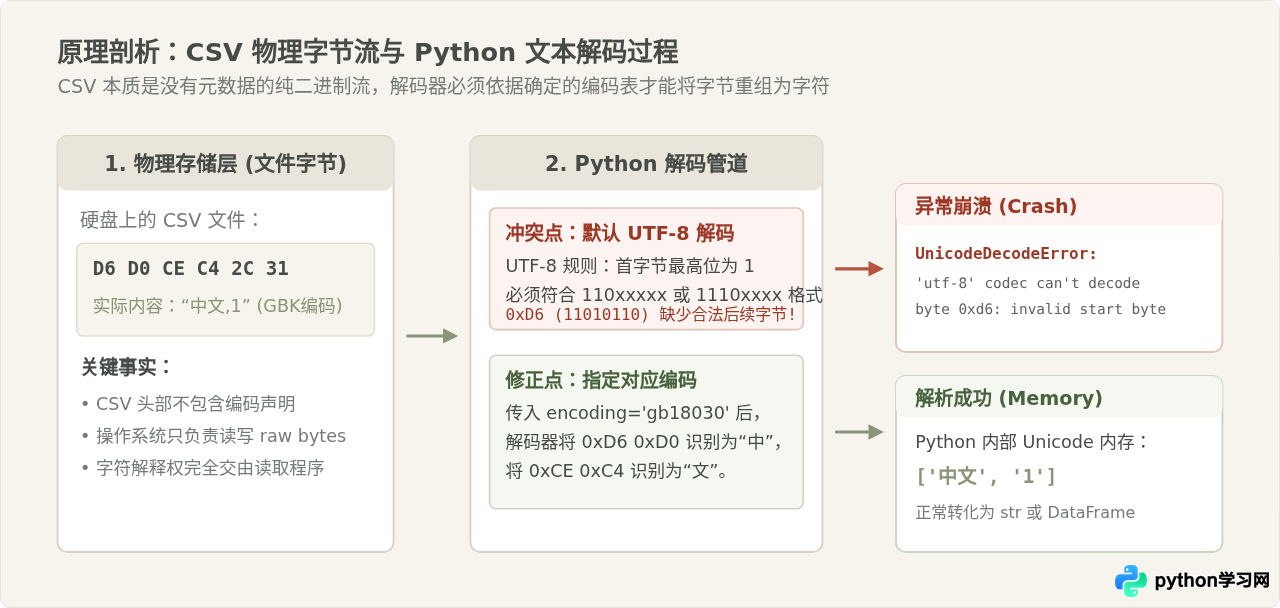
当 Python 读取 CSV 出现解码错误时,终端通常会输出形如 UnicodeDecodeError: 'utf-8' codec can't decode byte 0xb0 in position ...: invalid start byte 或 UnicodeDecodeError: 'gbk' codec can't decode byte ...: illegal multibyte sequence 的追踪信息。报错信息中直接指明了当前参与解码的编解码器(codec)以及它在哪个字节位置遇到了无法理解的数据。
要理解这一错误的产生,必须明确 CSV 文件的存储本质。CSV 并不是带有类型元数据的专有数据库文件,它在磁盘上仅仅是一连串连续的二进制字节(bytes)。当 Python 以文本模式(mode='r')读取文件时,解释器必须依据某种字符编码表将这些裸字节还原成内存中的 Unicode 字符。
如果在调用 open() 或 pandas.read_csv() 时没有显式传入 encoding 参数,Python 就会采用默认策略:
- 在 Linux 和 macOS 环境下,Python 默认编码通常是
utf-8。如果此时尝试读取一个由 Windows 简体中文版 Excel 导出的 CSV 文件(实际编码为 GBK),解码器在遇到中文字符的连续非 ASCII 字节时,发现其比特位排布不符合 UTF-8 的多字节前缀规则,就会立即抛出'utf-8' codec can't decode byte...。 - 在 Windows 简体中文环境下,Python 默认的系统代码页编码通常是
cp936(即 GBK)。如果此时直接读取一个标准的、由接口生成的 UTF-8 CSV 文件,当遇到某些特定三字节 UTF-8 序列在 GBK 双字节字典中不存在时,同样会抛出'gbk' codec can't decode...。
二、快速排查与确认文件的实际编码
修复 UnicodeDecodeError 的前提是确定目标 CSV 到底是用什么编码保存的,切忌在代码中随机猜测编码名称。排查实际物理编码可以通过以下两种互为印证的方法。
1. 根据文件来源做特征推断
大多数业务场景下的 CSV 文件都有明确的生成背景,根据来源可以迅速锁定最有可能的编码:
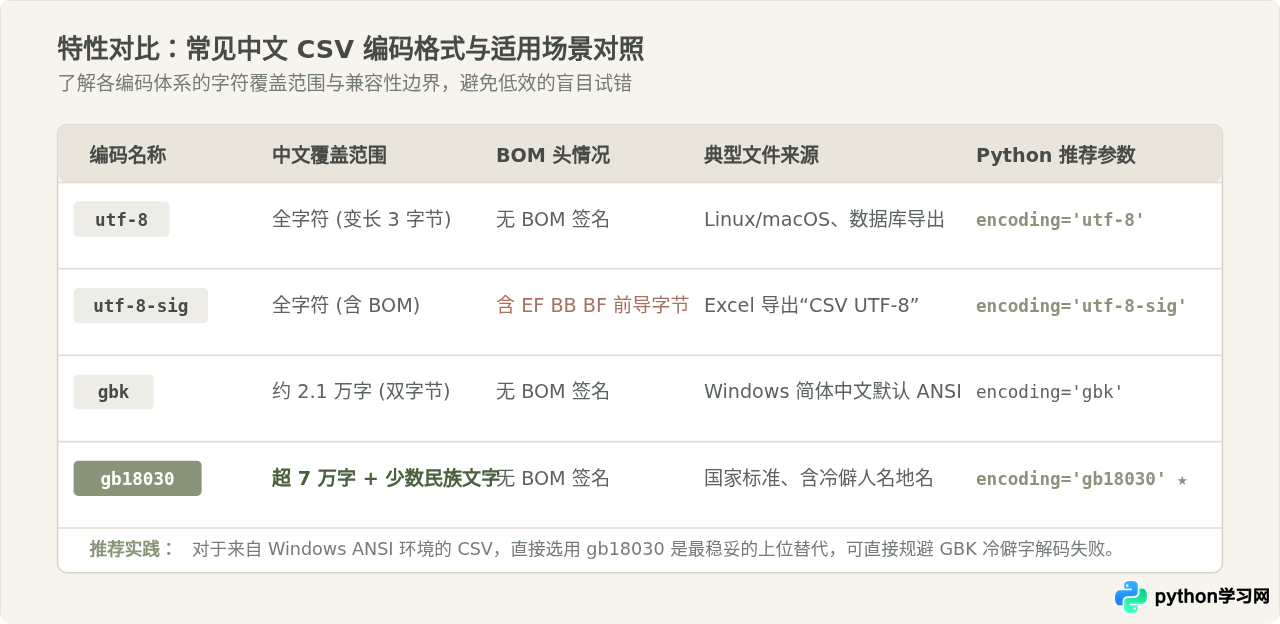
- Windows Excel 默认“CSV (逗号分隔)(*.csv)”:在简体中文系统上,Excel 默认导出的 CSV 实际是本地 ANSI 编码(即 GBK/CP936)。
- Excel “CSV UTF-8 (逗号分隔)(*.csv)”:Excel 会在文件最开头写入 3 个隐藏的字节
EF BB BF,即 UTF-8 BOM 标记。这种文件用普通utf-8读取时,虽然有时不报 decode 错误,但会导致第一列列名被污染(如出现id),但在某些严谨解析器下可能直接报错。 - Linux/macOS 工具、现代数据库管理工具(如 Navicat、DBeaver、pgAdmin)或 Web API 导出的 CSV:绝大多数为标准无 BOM 的
utf-8。
2. 使用 Python 代码探测文件头字节
如果无法确认文件来源,可以通过 Python 读取文件的二进制前缀进行判断,也可以借助 chardet 库自动检测(注意:大文件只需读取头部样本,无需读取全量数据):
# 探测 CSV 文件编码的实用脚本片段
import chardet

def detect_csv_encoding(file_path):
    with open(file_path, 'rb') as f:
        # 检查是否包含 UTF-8 BOM 标志
        raw_prefix = f.read(3)
        if raw_prefix == b'':
            return 'utf-8-sig'

        # 读取前 10KB 字节供探测器分析
        f.seek(0)
        sample = f.read(10240)
        result = chardet.detect(sample)
        return result['encoding']

detected = detect_csv_encoding('sales_data.csv')
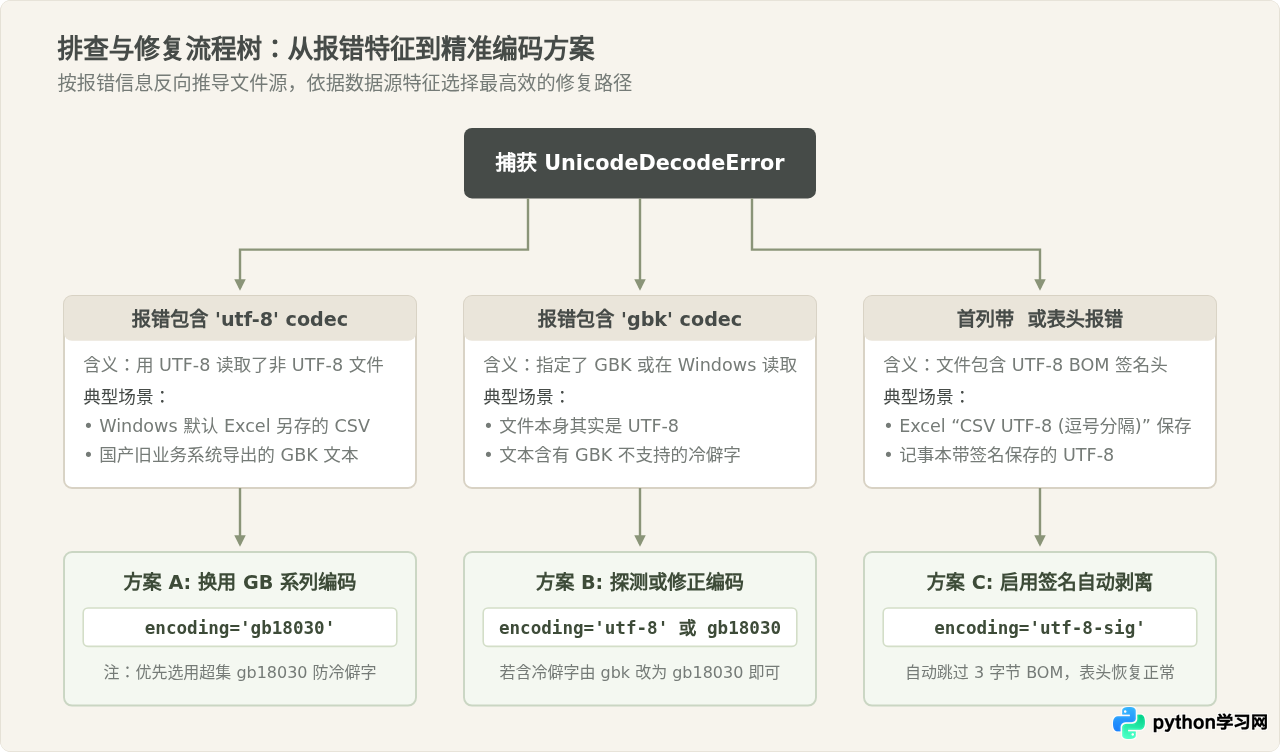
print(f"文件检测编码: {detected}")chardet 检测结果显示为 GB2312 或 GBK,在 Python 代码中一律建议传参为 encoding='gb18030'。因为 gb18030 是 gbk 和 gb2312 的官方完整超集,能无缝兼容常规汉字,并在遇到生僻字、特殊标点或少数民族人名时完全避免报错。
三、主流读取方式的具体代码修复方案
在确认了文件的物理编码后,修复的核心动作就是在调用读取函数时,显式指定正确的 encoding 参数。以下分别针对 Python 内置 csv 库和数据科学常用的 pandas 库给出具体示例。
1. 使用 Python 内置 open() 与 csv 模块读取
Python 内置的 open() 函数支持 encoding 参数。无论是在 Windows、macOS 还是 Linux 上运行,都应当始终显式提供该参数,防止依赖不同操作系统的隐式默认值:
import csv

# 修复方案 A:读取 Windows Excel 导出的 ANSI/GBK 文件(推荐 gb18030)
csv_path = 'sales_data.csv'

with open(csv_path, mode='r', encoding='gb18030', newline='') as f:
    reader = csv.reader(f)
    header = next(reader)
    print("读取表头:", header)
    for row_idx, row in enumerate(reader):
        print(f"第 {row_idx+1} 行:", row)
        if row_idx >= 2:
break第 1 行: ['ORD-2026-001', '张伟', '128.5', '华东']
第 2 行: ['ORD-2026-002', '䶮明', '256.0', '华南']
第 3 行: ['ORD-2026-003', '王芳', '89.0', '华北']
如果文件来源于 Excel 保存的“CSV UTF-8 (逗号分隔)”,文件开头包含了 EF BB BF 签名,请使用 encoding='utf-8-sig'。该编码会在解码时自动剥除开头的零宽无间断空格符(BOM),保证读取到的首列名称纯净:
# 修复方案 B:读取带有 BOM 头的 UTF-8 CSV 文件
with open(csv_path, mode='r', encoding='utf-8-sig', newline='') as f:
    reader = csv.DictReader(f)
    print("列名字典键:", reader.fieldnames)
2. 使用 Pandas (read_csv) 读取
在数据分析任务中,pandas.read_csv() 同样接收 encoding 参数。修复方法是在函数调用中传入对应编码:
import pandas as pd

# 读取 GBK / GB18030 格式的 CSV 文件
df_gbk = pd.read_csv('sales_data.csv', encoding='gb18030')
print(df_gbk.head(3))

# 读取带 BOM 头的 UTF-8 文件
df_utf8_sig = pd.read_csv('sales_data_bom.csv', encoding='utf-8-sig')
print(df_utf8_sig.columns.tolist())0 ORD-2026-001 张伟 128.5 华东
1 ORD-2026-002 䶮明 256.0 华南
2 ORD-2026-003 王芳 89.0 华北
['订单编号', '客户姓名', '购买金额', '所属地区']
四、容易混淆的说法与修复误区辨析
围绕 UnicodeDecodeError,社区和网络讨论中常有一些“看似有效”的技巧。理解它们在什么条件下成立、存在什么隐藏危害,能够帮助我们在工程中做出正确选择。
误区一:“在 open 中添加 errors='ignore' 可以一劳永逸解决报错”
为什么看似合理:当加上 errors='ignore' 或 errors='replace' 后,Python 在遇到无法按指定编码解析的字节时,会跳过或替换为 ?,程序确实不再崩溃中断,数据看起来成功加载了。
问题所在:中文字符在 GBK 或 UTF-8 下通常由 2 到 3 个字节构成。如果指定的编码本身错误,ignore 会直接丢弃其中的某些关键字节,导致中文字符变成破碎的乱码、字词缺失。更严重的是,若字段截断处包含逗号等定界符,会导致整行字段错位,给后续数据分析和业务逻辑带来致命的数据污染。因此,除非处理的是不关注文本完整性的脏日志流,在读取业务 CSV 时严禁使用 errors='ignore'。
误区二:“只要是中文 CSV,传 encoding='gbk' 就一定能解决”
为什么看似合理:在很多 Windows 桌面环境下,大部分导出的 CSV 确实是 GBK 编码,传入 encoding='gbk' 能解决 80% 以上的常见报错。
哪里需要修正:GBK 字符集收录了 21000 多个汉字,但在处理人名、地名、文史资料时,经常会遇到生僻字(例如“䶮”、“赟”、“埗”等)。遇到这些字符时,gbk 同样会抛出 UnicodeDecodeError: 'gbk' codec can't decode byte...。修正方法是始终优先使用我国的国家标准超集 gb18030。gb18030 完全向下兼容 gbk,同时收录了超过 7 万个汉字和少数民族文字,能够彻底杜绝生僻字引发的中断。
误区三:“遇到报错,用 Windows 记事本打开并‘另存为 UTF-8’即可”
为什么看似合理:通过图形界面手工转码,确实可以让原文件变成 UTF-8,从而适配默认代码。
局限性:在自动化脚本、定时任务或生产数据流水线中,不可能由人工介入去另存文件;此外,旧版 Windows 记事本另存的 UTF-8 可能会强制写入 BOM 头,如果在后续读取时未配置 utf-8-sig,依然会引发列名异常。代码问题应当在代码层通过健壮的参数配置解决。
五、验证修复结果与长效防范建议
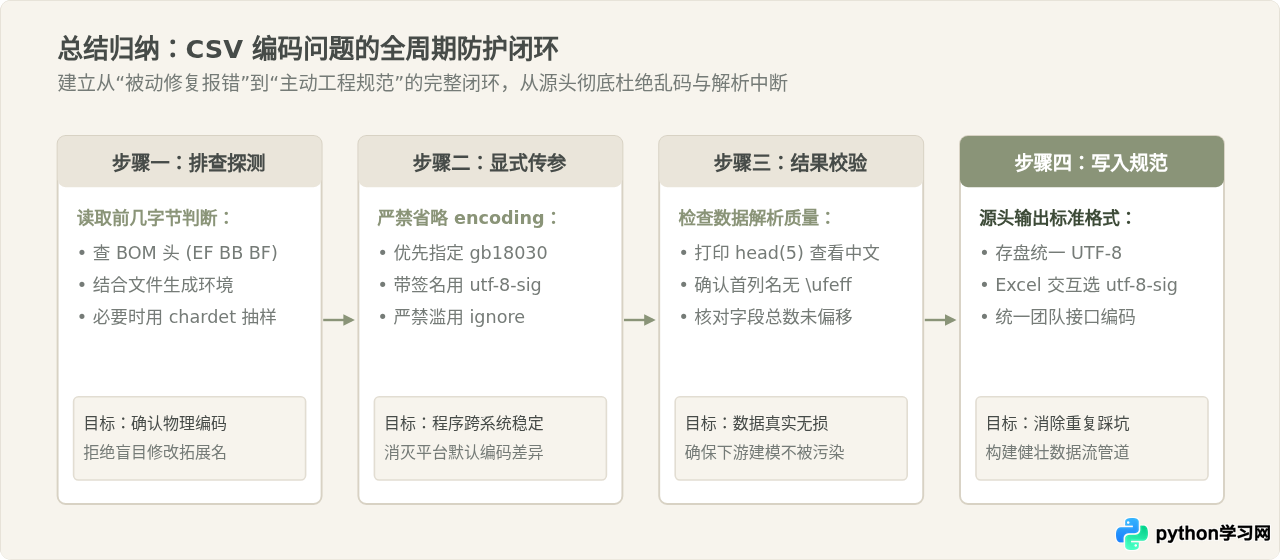
修复编码报错后,不能仅以“程序不崩溃退出”作为修复完成的标准,还需要通过明确的检查步骤验证数据读取的真实有效性:
- 中文采样验证:打印读取结果的前 5 行以及包含复杂文字的样本行,确认文字清晰无“”字符或乱码。
- 列名与字段完整性验证:检查
columns或fieldnames列表,确认第一个字段名没有附带,且字段总数与 CSV 原始定义完全一致。 - 行数核对:对比读取到的行数与文件物理行数(在终端可通过
wc -l核对),确认没有因定界符混淆而导致行合并。
为了在团队协作和数据流水线中从源头杜绝 UnicodeDecodeError,建议在所有数据读写脚本中落实以下工程规范:
- 在代码中调用所有
open()、read_csv()以及to_csv()时,一律显式声明encoding参数,彻底消除对操作系统环境默认值的依赖。 - 若系统生成的 CSV 专供 Excel 用户直接双击打开查看,写入时建议采用
encoding='utf-8-sig',这样既能保证全字符集支持,又能让 Windows Excel 正确识别而不会出现双击乱码。 - 若文件供后端服务、数据库或跨平台程序消费,统一以
encoding='utf-8'(无 BOM)作为标准交付格式。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









